

💡 站外导读:长期以来,全球顶级社交网络与流媒体平台的推荐算法主要依赖用户的“隐式交互信号”(如停留时长、点击、点赞与滑过)进行协同过滤与深度学习拟合。这种被动学习机制虽具备超大规模吞吐与工程扩展性,却存在自适应迟缓、无法捕捉复杂微细意图以及深陷“信息茧房”的顽疾。为此,Meta 工程团队近日重磅发布工程技术长文,全景解密了赋能数十亿用户的 Facebook 推荐系统革新成果——“Your Algorithm”。该系统开创性地构建了以多任务大语言模型(LLM)为认知中枢的端到端可控架构,允许用户通过自然语言直接在 Feed 和 Reels 中显式声明“感兴趣(Interested In)”与“不感兴趣(Not Interested In)”的双向主题池。本文结合一手官方工程白皮书与架构图表,深度剖析其多路召回、防倾倒控制层、端侧缓存失效机制以及 LLM-as-a-Judge 评测体系。
一、 推荐算法的工业范式革命:从被动隐式推断跨越到显式自然语言掌控
在传统的推荐系统工程中,算法工程师通过构建庞大的深度神经网络(如双塔模型、DLRM、序列注意力网络等),在用户每一次划动屏幕时计算数以万计候选内容的点击率(CTR)与转化率(CVR)。这种模式虽然成功撑起了万亿美元的数字广告与信息流生态,但在体验层面却始终无法逾越三大系统性缺陷:
- 适应周期迟缓(Adaptability Lag):系统主要通过隐式交互信号更新用户画像。当一个用户因为偶发工作需求搜索了一次冷门工具,或者在某条猎奇视频上多停留了 5 秒钟,系统往往需要数十次甚至数百次后续的负反馈交互,才能逐步衰减该主题的权重;
- 微细语义盲区(Nuance Blindness):隐式行为只能表达“看与不看”,却无法区分“我喜欢这个博主的解说风格,但讨厌他今天讨论的题材”,或者“我虽然关注科技前沿,但坚决不希望在下班后被推荐低质 AI 鸡汤”;
- 全球监管与透明度刚性要求:欧盟数字市场法案(DMA)及全球多国反垄断机构,正在不断对“不透明黑盒算法”提出严厉监管审查,强制要求主流平台向用户提供直观、可解释且可自由干预的时间线控制权。
Meta 推出的 Your Algorithm 正是在此行业拐点下诞生的破局之作。它为用户提供了一个单一且可直观编辑的中央兴趣视图,将控制权从冷冰冰的点击概率回归给人类的真实意志。
二、 “Your Algorithm”系统全生命周期架构:偏好解析、存储与多任务 LLM 流水线
在工程物理实现上,Your Algorithm 界面由三大核心模块构成:顶部是一句由大语言模型动态生成的“近期兴趣总结(Lately Summary)”;下方则是两个结构化列表——“感兴趣(Interested In)”(由系统从历史行为中自动推断初值,支持手动增删改)与“不感兴趣(Not Interested In)”(捕获用户明确标记屏蔽的主题、隐藏的创作者或显式输入的内容类型)。
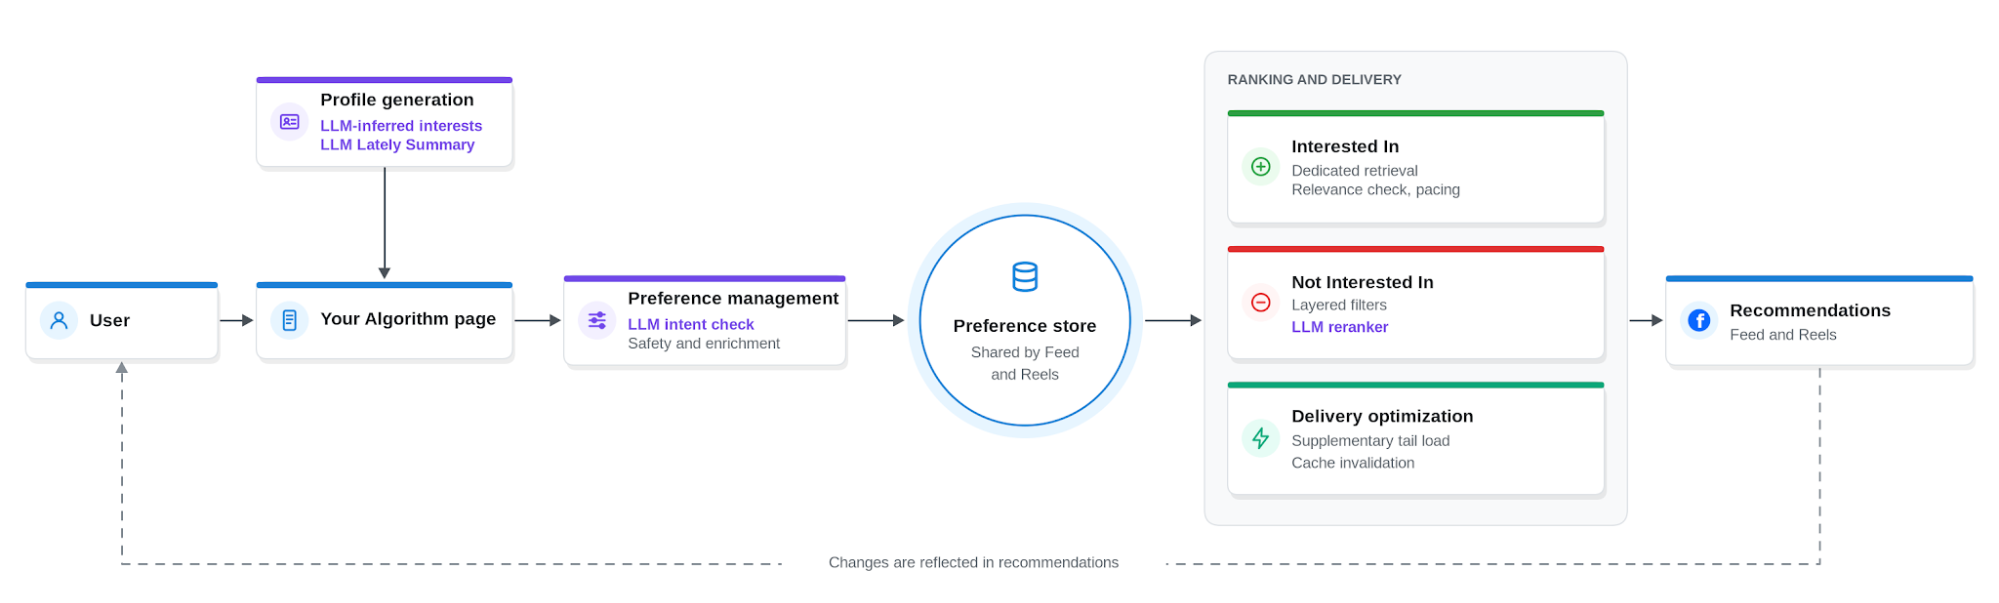
如图 2 所示,整个偏好处理流程覆盖了从提炼推断到排序交付的完整生命周期:
- 用户画像自动构建(Profile Generation):当用户首次进入界面时,多任务 LLM 会系统扫描用户近期在 Feed 和 Reels 中的高维交互信号,将其转化为人类可读且干净的主题名称(Clean Topic Names),预填入“Interested In”列表中,并撰写自然语言形式的 Lately Summary;
- 实时偏好管理中枢(Preference Management):用户在输入框中输入任何一段自然语言(例如“想看更多关于轻量级 Docker 容器调优的内容”),轻量微调 LLM 会实时执行意图识别、去重校验,并将其归一化映射为内部标准主题。随后,系统为该偏好富化排序所需的特征信号(包括语义向量 Embedding 与密集搜索关键词),持久化写入统一的共享偏好存储库(Single Shared Store)。这一设计确保了用户在页面上所见的配置与后端排序引擎读取的规则 100% 物理一致;
- 多层级安全与合规守卫:在 LLM 解析之外,系统部署了独立的前置内容安全组件,防止通过恶意注入 prompt 绕过推荐系统的安全基线。
三、 召回与重排双向博弈:4路独立召回抗倾倒机制与多层级反向过滤深度解密
如何将用户的显式偏好无缝注入高并发推荐链路,是 Meta 团队面临的最大工程挑战。若处理不当,新增偏好极易引发“候选流洪水泛滥”破坏推荐多样性;而负向偏好若过滤不严,又会导致用户产生“设置无效”的强烈挫败感。
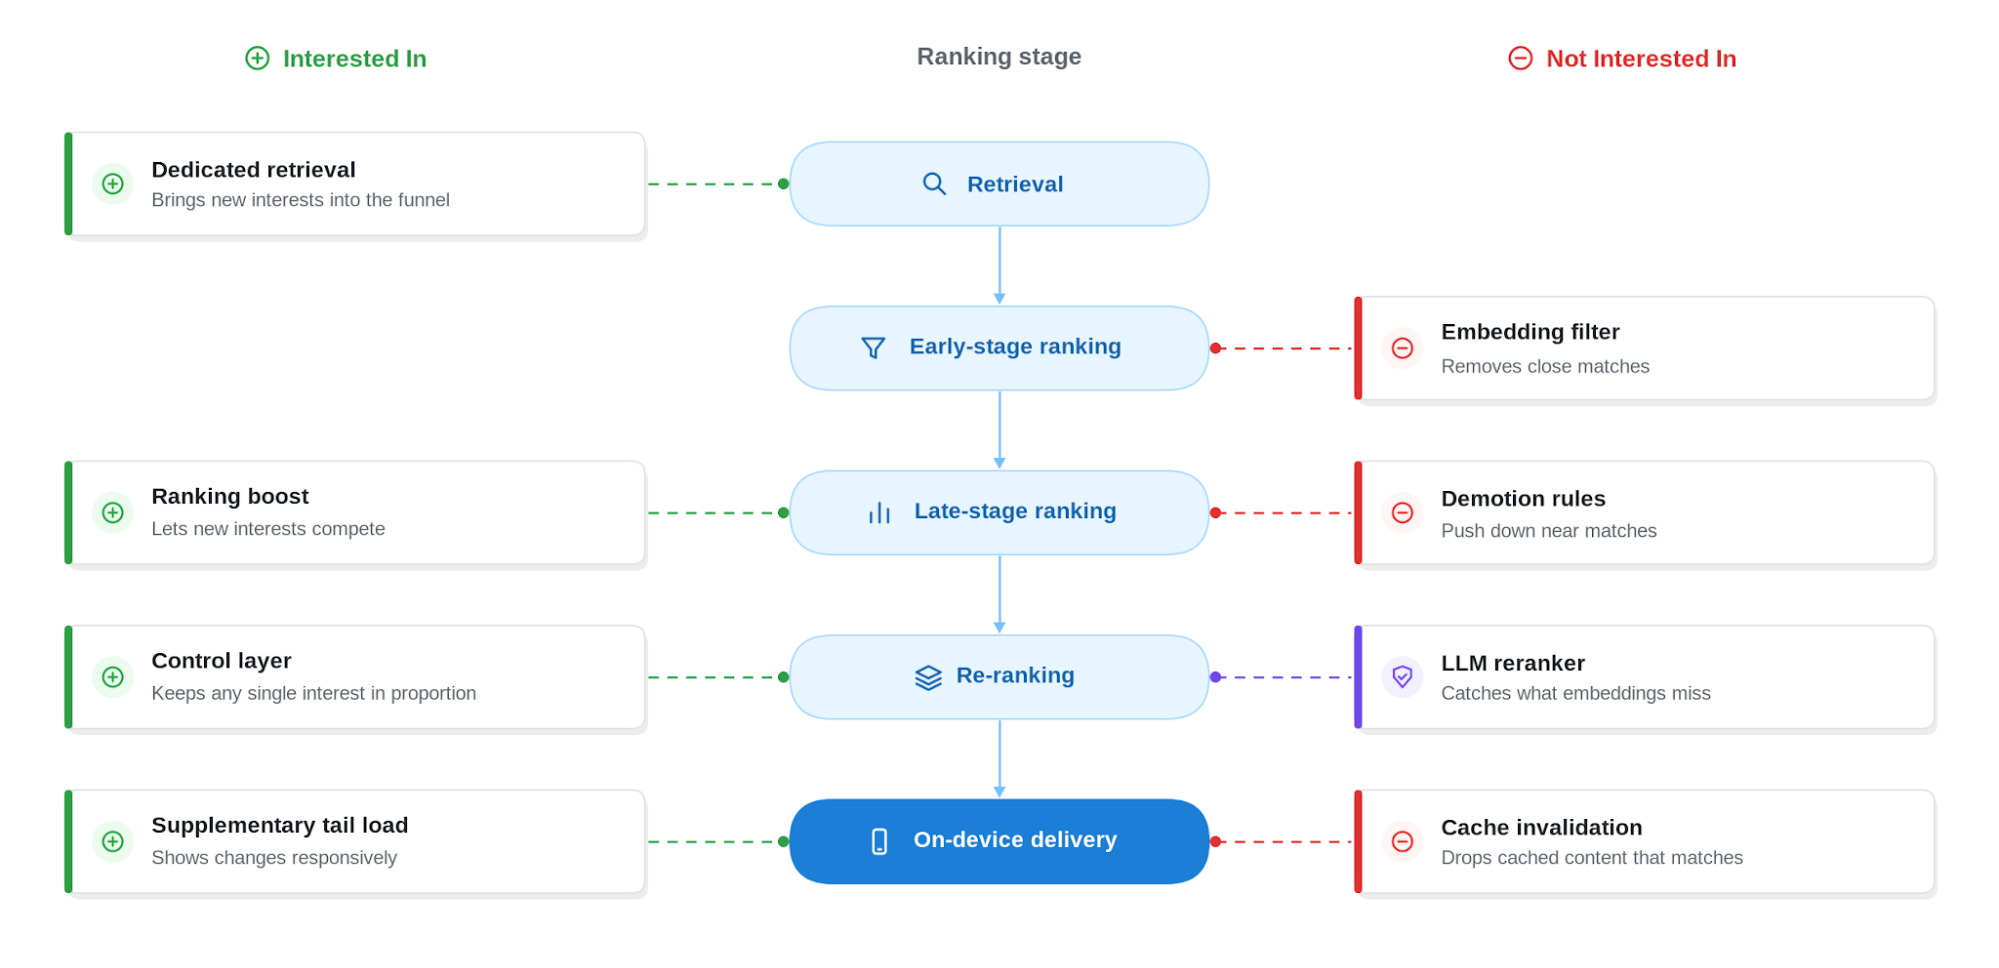
为此,Meta 在推荐漏斗中构建了精密的双向控制策略:
- 正向偏好(Interested In):4 路独立召回与防倾倒控制层:
用户每添加一个新兴趣,系统都会在底层为其并行激活 4 路专用召回源:两路通过搜索索引和高相关主题聚类直接匹配内容,另两路则通过图计算与 Item-to-Item 协同过滤进行发散召回。通过语义相关性校验的候选物料,在后期重排阶段会获得专属提权(Promotion)。为了防止新兴趣迅速占满屏幕,重排控制层实施严格的频次平铺(Space Out)与每日配额上限(Daily Cap),并且每次只针对单个兴趣轮流召回,确保所有兴趣都有露脸机会;
- 负向偏好(Not Interested In):从向量剪枝到专用 LLM 兜底的全链路漏斗:
系统在粗排阶段利用向量余弦距离直接剔除与屏蔽词过近的候选集;针对边缘弱相关候选,则通过降权惩罚将其挤出可视区域。在最终精排之后,系统部署了专门微调的专用判别小模型(Fine-tuned LLM Reranker)对最终列表进行二次巡检,精准剔除那些向量相似度不高但语义上令人反感的内容;对于用户显式指定的创作者,系统则直接在网关层执行硬编码过滤。
四、 交付时延与模型评测工程实践:补充尾部加载、端侧缓存失效与 LLM-as-a-Judge
在移动端工业级架构中,推荐内容通常会在客户端本地预先缓存数页。如果用户刚刚在设置中添加了“屏蔽足球新闻”,却在返回信息流时依然看到本地已缓存的足球短视频,体验将大打折扣。
- 补充尾部加载(Supplementary Tail Load):当用户新增“Interested In”条目时,系统会绕过常规的固定刷新节拍,在后台静默发起一次带外的补充拉取,以毫秒级时延将新兴趣候选物料注入展示队列;
- 端侧智能缓存失效(Client Cache Invalidation):当检测到“Not Interested In”发生变动时,服务端会将新规则对应的主题聚类签名(Cluster Hashes)下发给移动客户端,客户端在渲染下一屏前自动对本地队列执行瞬时校验,将命中屏蔽规则的本地缓存内容即刻从内存中蒸发;
- 基于 LLM-as-a-Judge 的自动化工程评测:由于传统的离线指标(如 AUC 或 NDCG)无法衡量“Lately 摘要是否足够传神”或“LLM Reranker 是否误杀了正常内容”,Meta 设计了独立的 LLM 裁判模型,针对海量测试用例按照预设准则进行自动化打分与回归测试,构建起了可持续迭代的 CI/CD 评估防线。
五、 传统深度推荐系统与 Meta Your Algorithm 架构指标对比
我们将传统主流基于协同过滤的推荐架构与 Meta Your Algorithm 进行核心技术指标横向对比:
| 对比评估维度 | 传统工业级深度学习推荐流水线 | Meta Your Algorithm 架构 |
|---|---|---|
| 意图获取核心渠道 | 100% 依赖点击、停留、点赞等隐式被动行为 | 自然语言显式输入 + 隐式推断双向对齐 |
| 兴趣演进响应周期 | 天级别或小时级别,依赖特征衰减与离线重训 | 秒级响应(配合补充尾部加载即刻生效) |
| 负向过滤精度与广度 | 单点关键词匹配易误伤,向量过滤易漏网 | 向量粗排 + 微调专用 LLM 精确重排二次兜底 |
| 客户端缓存同步策略 | 被动等待客户端缓存消费殆尽后刷新 | 端侧缓存智能比对与动态实时失效剔除 |
| 系统黑盒透明度 | 完全黑盒,用户无法获知为什么被推荐 | 单一可编辑视图,主题归因与近期摘要完全白盒化 |
📝 站长洞察 (Editor’s Insight)
Meta 这篇工程博客标志着工业级推荐系统正在发生一场深刻的‘认知层重构’。过去十余年,推荐工程师们竭尽全力用双塔模型、DIN 或序列 Transformer 去猜测用户的点击概率,却常常因用户一次偶然的短视频停留而推向无休止的同质化垃圾内容。Your Algorithm 最惊艳的技术突破在于:它没有停留在粗暴的关键词匹配或简单的黑名单剔除,而是将多任务轻量微调 LLM 深度织入召回前置检查、中段语义重排和后置端侧缓存淘汰的全流程中;同时创新性地引入 Supplementary Tail Load(补充尾部加载)技术,在用户按下‘保存偏好’的数毫秒内即刻并发拉取候选流,彻底攻克了传统推荐客户端预缓存与服务端动态重排脱节的顽疾。这套‘大模型意图解构 + 传统推荐高吞吐粗排 + 轻量 LLM 语义守门’的混合三层架构,为全行业从‘黑盒推荐’迈向‘透明可解释可控推荐’树立了极其坚挺的技术标杆。
Facebook Your Algorithm 是什么?
它是Meta为Facebook Feed和Reels推出的显式推荐控制系统,用户可用自然语言管理“感兴趣”和“不感兴趣”主题。系统用多任务LLM解析偏好,并把结果同步到共享存储与排序链路中。
Your Algorithm 为什么比传统推荐更可控?
传统推荐主要依赖点击、停留等隐式信号,更新慢且难表达细微意图。Your Algorithm允许用户直接输入自然语言偏好,并通过召回、重排和过滤机制即时生效,控制权更明确。
Interested In 和 Not Interested 怎么影响推荐?
Interested In会触发多路召回与重排提权,但系统会用Space Out和Daily Cap控制曝光节奏;Not Interested则进入反向过滤链路,尽量减少相关主题、创作者或内容类型再次出现。
多任务LLM如何兼顾兴趣理解与排序?
通常会把兴趣抽取、意图分类、候选打分拆成多任务联合训练,再用共享表示层对齐语义。这样既能提升自然语言理解,又能把“Interested In/Not Interested”转成可执行的排序信号,减少单模型各自为战。
双列表分层重排怎么落地才稳?
先把正向兴趣和负向排斥分开建模,再在粗排、精排、重排三层分别注入不同强度的约束。工程上要重点控制冲突信号、延迟和回退策略,避免端侧实时淘汰把召回空间压得过窄。


