

💡 站外导读:在传统SEO流量断崖式下跌与AI搜索(GEO)全面重塑流量分发格局的当下,企业营销与工程团队面临最大的痛点是“ChatGPT究竟如何采信与引用外部事实”。权威SEO分析平台Ahrefs基于6660万次生产环境交互样本与4000组Brand Radar实测数据,深度揭秘了ChatGPT构建回答的四大底层信息流:静态预训练数据、动态实时网络检索(RAG)、独家出版商商业授权与个性化上下文资产。实测揭示传统Top 10排名的重合度仅为8%,掌握Query Fan-Out分发逻辑与爬虫协议治理已成为企业在生成式智能体时代的生死线。
1. 破除黑盒迷雾:ChatGPT 生成事实的四大信息流动拓扑
在业界普遍的认知误区中,人们往往将 ChatGPT 简单视为“一个接入了必应检索的自回归文本生成器”。然而根据 Ahrefs 的系统级逆向拆解,ChatGPT 回答一个复杂问题时,其背后涉及四个高度解耦且权责分明的信息供应池。模型最终采信哪一个渠道,完全取决于用户 Prompt 的意图类型与时效性敏感度:
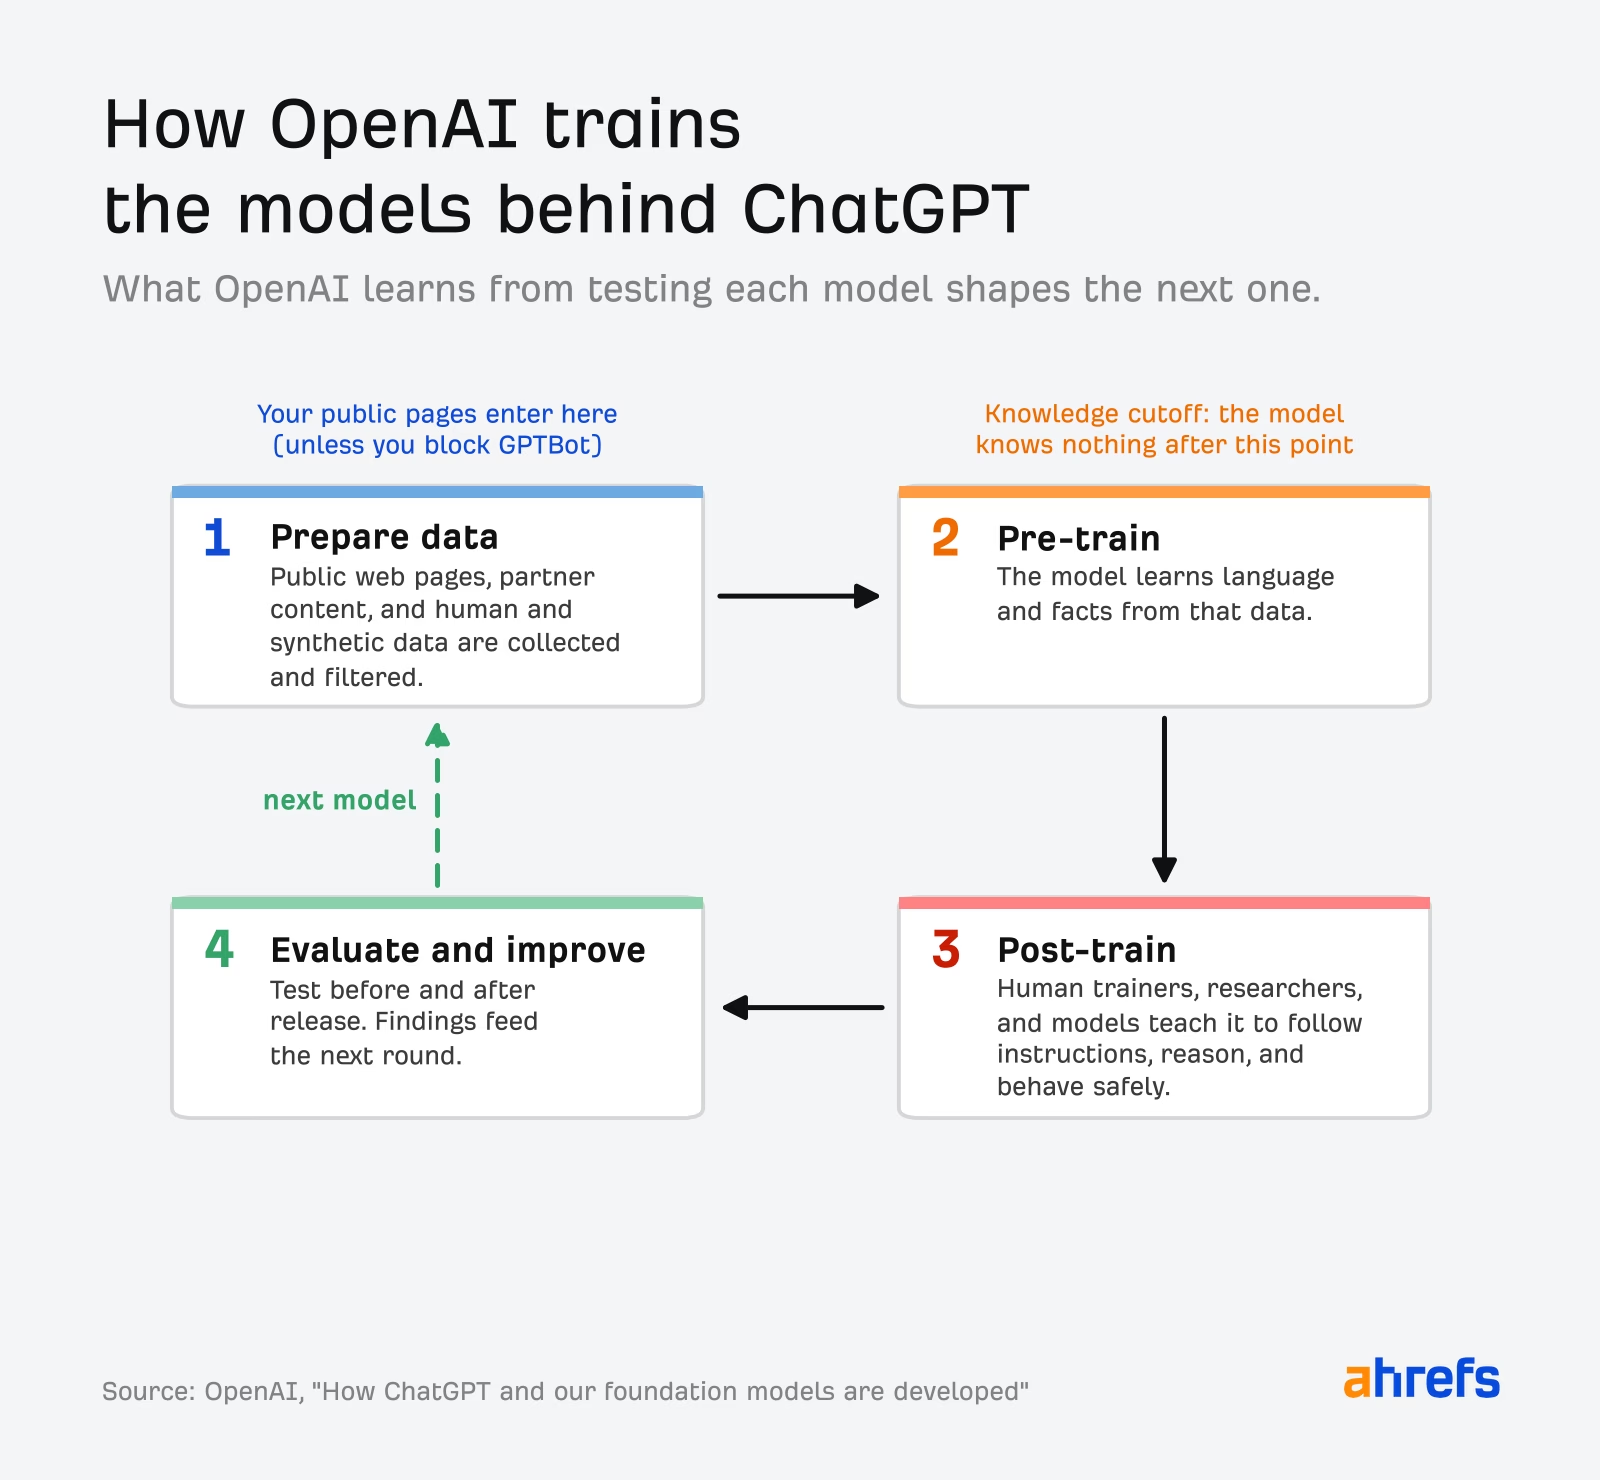
- 来源一:底层预训练数据集 (Training Data)——构成大模型的常识底座,涵盖语言学规律、代码语法、通用世界知识与事实网络。训练数据历经数据准备、无监督预训练(Pre-training)、指令微调与人类反馈强化学习(Post-training/RLHF)。需要明确的是,GPT-6 Sol 等前沿旗舰的知识截止日期(Knowledge Cutoff)通常滞后发布期数月至半年,这意味着任何时效性事实都无法单凭预训练权重直接作答。
- 来源二:实时网络检索系统 (Live Web Search / RAG)——当用户问题涉及突发新闻、动态价格、最新产品发布或显式要求提供证据来源时,检索增强生成(RAG)管道被实时唤醒。据 OpenAI 消费级产品负责人 Adam Fry 披露,ChatGPT 的联网查询体量已达到 Google 总查询量的约五分之一(约 20.2% 的消费级会话包含信息检索诉求)。
- 来源三:商业授权出版商内容池 (Licensed Publisher Content)——OpenAI 每年斥巨资与美联社、Axel Springer、新闻集团(News Corp)等顶级传媒集团签署的内容许可协议。该通道为模型注入高质量、独家且完全规避版权侵权争议的权威事实流。
- 来源四:专属用户上下文资产 (User Context & Memory)——由用户在当前会话中挂载的附件(PDF/CSV)、Prompt 指令本身、跨会话长期记忆账本(Memory),以及基于 IP 粗略估算的地理位置元数据共同构成。
2. 6600万样本深度解密:Query Fan-Out 展开机制与“8%传统重合率”真相
传统搜索引擎采用“用户输入关键词 -> 倒排索引召回 -> 网页排序”的线性链路,而 ChatGPT 在执行联网搜索时,采用的是极为精密的 Query Fan-Out(查询多路展开) 机制。系统不会机械地把用户的完整长句直接抛给搜索引擎,而是通过内置轻量化推理模块,将意图拆解为平均 1.6 个具备高度针对性的扇出子查询:
例如,当用户提问“适合小型设计工作室的最佳全栈 CRM 是哪款?”,ChatGPT 会在后台自动并发裂变为多路查询:"best CRM for small agencies 2026"、"HubSpot vs Pipedrive agency pricing" 以及 "CRM customer reviews small business"。Ahrefs 在对免费无登录状态下 6660 万次 ChatGPT 响应日志的量化审计中,发现了两个极具商业穿透力的底层规律:
- 官方网站的高优先级拦截(site: 语法占 6.8%):在所有扇出子查询中,多达 6.8% 主动使用了限制域名的
site:操作符,且其中超过四分之三直接指向具体品牌的官方网站。这表明 ChatGPT 倾向于跳过冗余的第三方中介页面,直接穿透第一方权威源头抓取第一手事实。 - “Official”权威性强校验(词频激增至 13.1%):英文查询中包含
"official"关键词的比例从 8 月份的 10.1% 迅速攀升至 9 月份的 13.1%。大模型在生成答案时,对具有官方背书的原始发布源赋予了极高的置信度权重。
更为震撼的行业实测数据来自对引用域名的对比分析:学术机构与 Ahrefs 的交叉验证显示,ChatGPT 最终引用的页面中,仅有约 8% 与传统 Google 或 Bing 的前十名(SERP Top 10)重合。即使将 Google 结果与 OpenAI 自研 Search API 的全部结果叠加,也仅能覆盖 ChatGPT 引用页面的 27% 与站点维度的 50%。这彻底粉碎了“传统 SEO 排名高就必然在 AI 时代获得推荐”的固有执念。
3. 双爬虫权限博弈:GPTBot 与 OAI-SearchBot 的防御矩阵
随着出版业与企业界对数据资产所有权意识的觉醒,越来越多的网站在 robots.txt 中部署了防爬策略。然而,混淆两种性质截然不同的 AI 爬虫协议,往往会导致企业在流量端遭受灾难性自残:
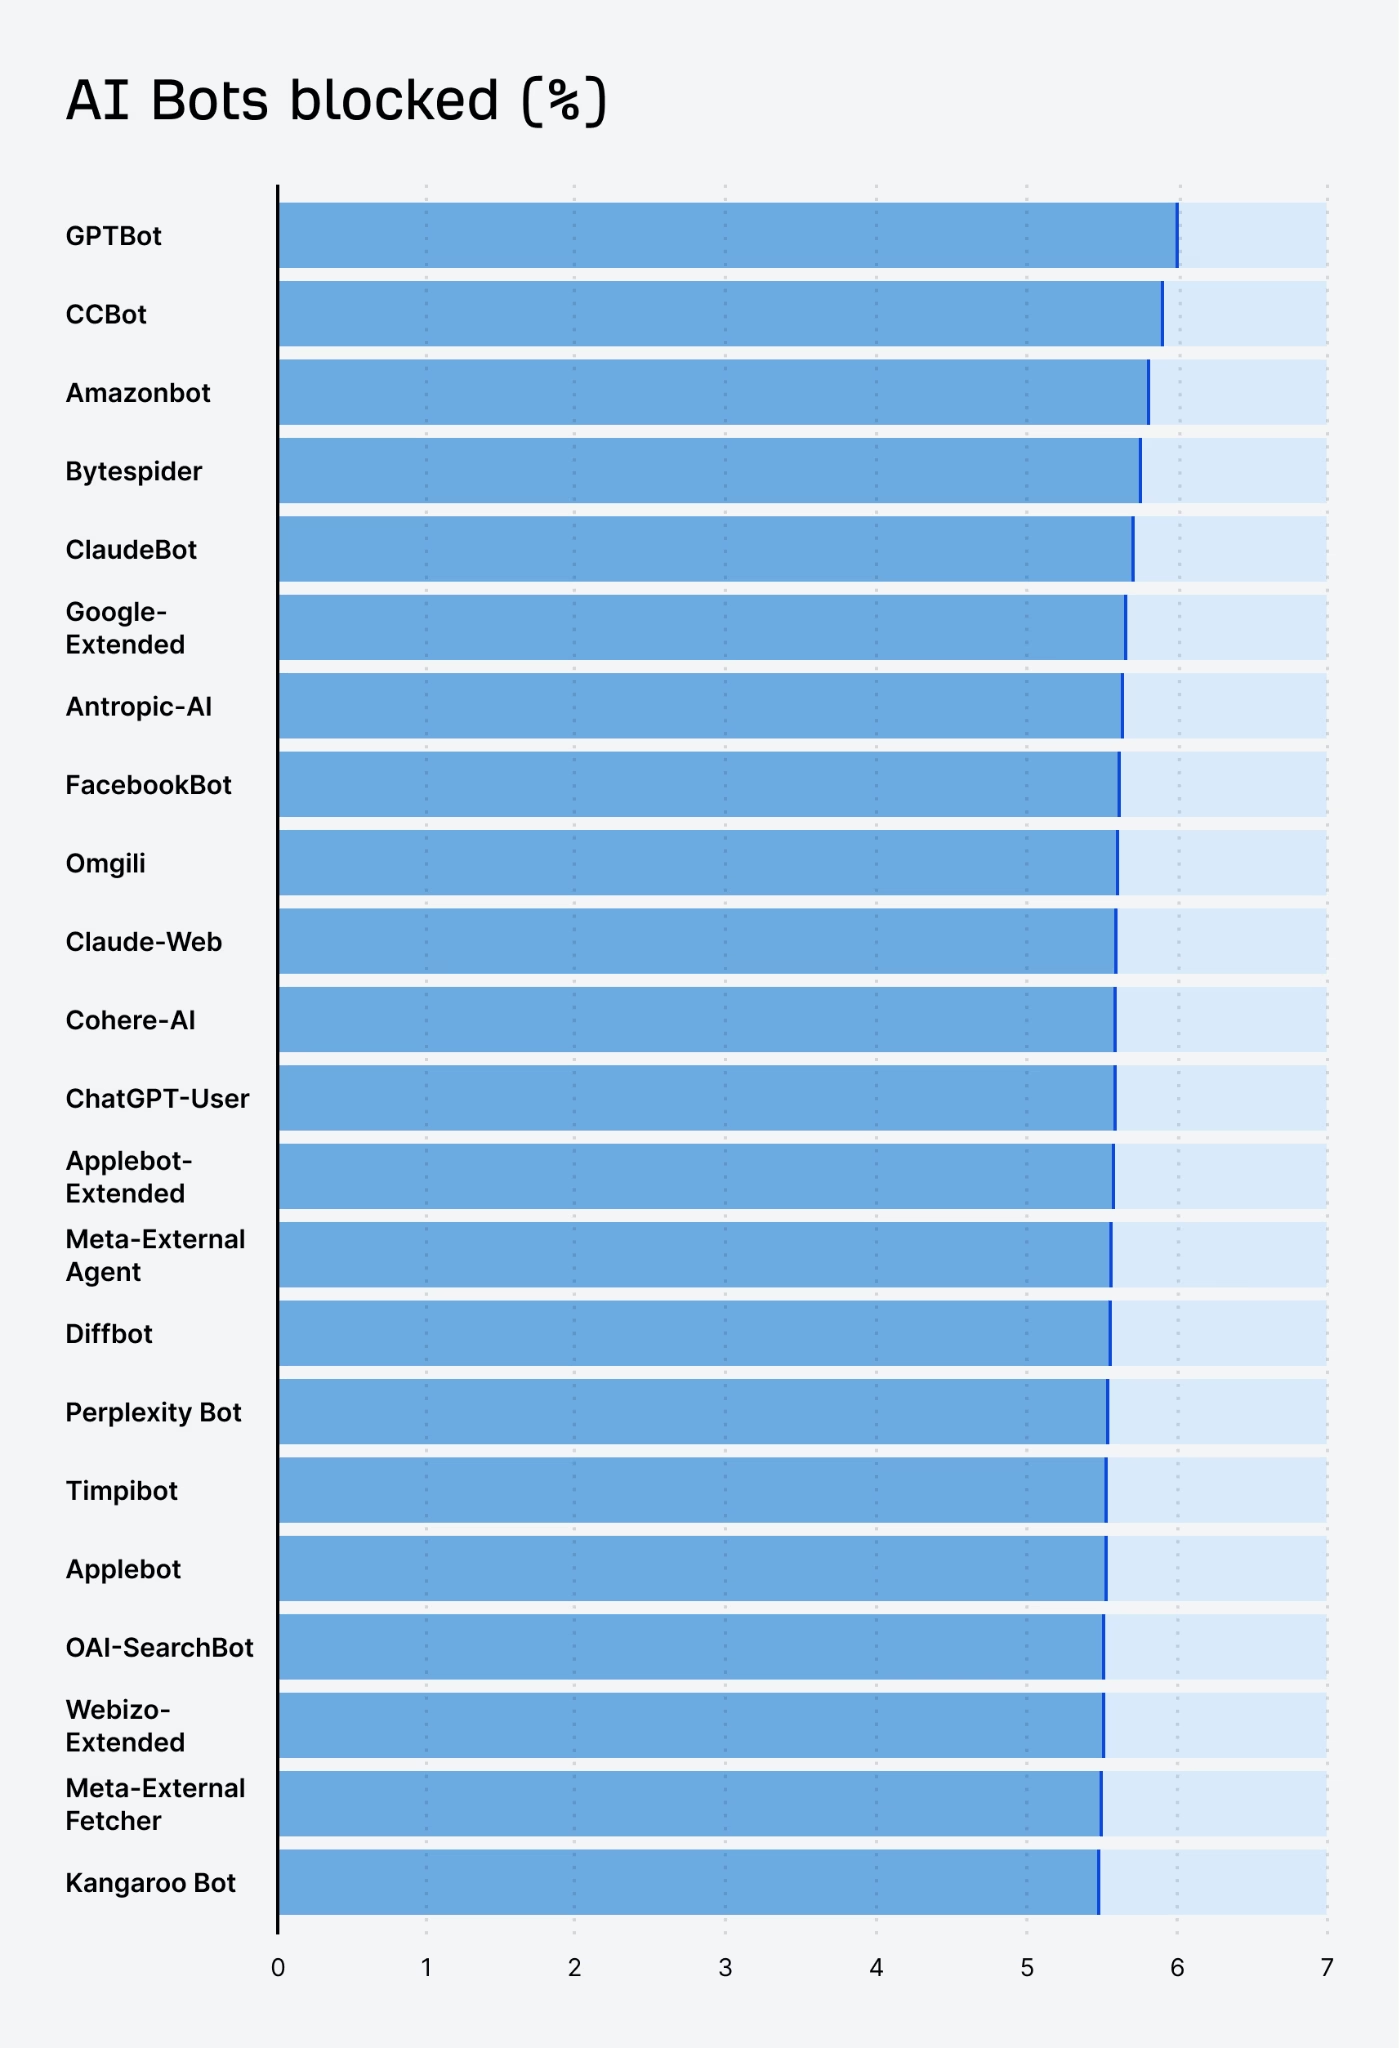
Ahrefs 针对全球约 1.4 亿个独立网站的普查数据显示,GPTBot 已经成为全网被屏蔽最严重的 AI 爬虫,约 6.0% 的站点对其设置了 Disallow,封锁率甚至超过了 CCBot、Amazonbot 与 ClaudeBot。许多站长在阻断 GPTBot 的同时,未意识到这仅代表拒绝将自身内容贡献给下一代基座模型的长期预训练池;而真正控制 ChatGPT 实时搜索引用展示的,是独立的 OAI-SearchBot(封锁率约 5.5%)。
如果企业同时封杀 OAI-SearchBot,将导致品牌在用户通过 ChatGPT 探索行业解决方案时彻底沦为“数字隐形人”。对于非头部媒体或无力达成商业授权合作的中小企业而言,明智的 SRE 策略是:严格隔离训练爬取与搜索引用通道,保持 OAI-SearchBot 的顺畅通行。
4. ChatGPT 四大信息源与传统搜索引擎机制全维度对比
为了让架构师与运营人员建立清晰的决策心智,以下梳理了 ChatGPT 内部四大信息源的核心技术特征与对应工程策略:
| 维度 / 信息流通道 | 预训练数据池 (Training) | 实时网络检索 (Live RAG) | 商业授权池 (Publishers) | 用户上下文 (Context) |
|---|---|---|---|---|
| 底层实现载体 | 神经网络静态权重 (Weights) | 实时爬虫抓取 + 向量重排 | 专有数据管道 + 特权知识库 | KV-Cache 上下文窗口注入 |
| 时效性与更新频率 | 年/季度级(严重滞后) | 秒级/分钟级动态更新 | 小时级/实时 API 同步 | 单会话即时生效 |
| 引用展现形式 | 无角标直接叙述(内化常识) | 显式带外链引用气泡与卡片 | 权威新闻摘要与富媒体卡片 | 针对用户专属痛点的量身答复 |
| 对应网络协议管控 | User-agent: GPTBot |
User-agent: OAI-SearchBot |
B2B 私有商业许可协议 | 企业租户数据隐私开关 |
| 企业 GEO 破局路径 | 沉淀高权重常识性知识图谱 | 优化官网结构化数据与即时回答 | 抢占已签约主流媒体的内容露出 | 提供轻量标准化集成引导物料 |
5. 面向 Agentic 时代的企业 GEO 落地实战准则
在厘清了 ChatGPT 的信息来源之后,企业技术人员应当如何系统性重构自身的网络资产?Ahrefs 给出了清晰的四步落地清单:
- 细粒度解耦爬虫准入控制:立即排查运维层面的
robots.txt,确保放行OAI-SearchBot。若非版权驱动型大型出版商,亦不宜盲目屏蔽GPTBot,防止未来大模型丢失对品牌的原始认知底座。 - 强化官方站点(Official Site)的语义密度:既然多达 13.1% 的查询直奔官方源,企业官网必须具备极高清晰度的技术参数、定价政策、产品架构对比与常见问题(FAQ)模块。摒弃由繁杂 JS 渲染的外壳,提供易于爬虫静态解析的 HTML 原生内容。
- 破除“确定性排名”执念,拥抱头部域名韧性:研究表明,同一 Prompt 在连续 4 周内的具体引用 URL 每日留存率仅约 25%,但顶级权重域名的整体留存率却高达 86%(变动率仅 14%)。这表明单篇页面的短期排名意义正在钝化,持续巩固整站域名的权威性与实体关联才是唯一能抵御模型非确定性波动的护城河。
📝 站长洞察 (Editor’s Insight)
Ahrefs 这份基于 6660 万真实交互与千万级爬虫拦截实测的报告,彻底撕碎了行业内“把传统 SEO 玩法平移到 AI 搜索”的幼稚幻想。最令人警醒的数据是“8% 重合率”与“13.1% official 强注入”——这宣告了中间商聚合站、伪原创内容农场与冗长废话外链的彻底破产。在 GPT-6 与多模态智能体主导的下一代分发中,模型需要的不是搜索引擎给出的“可能相关链接集合”,而是经过形式化归纳后的“因果结论证据链”。企业 CTO 与 CMO 必须清醒认识到:GPTBot 封禁与否是一场技术防御与长期心智资产的残酷博弈;而针对 OAI-SearchBot 的 GEO(生成式引擎优化)必须下沉到 API 数据层与精准事实断言。未来的互联网流量入口已不再属于排名第一的蓝链,而属于能够被 Agent 瞬间解析为确定性事实的知识图谱节点。
ChatGPT引用来源主要来自哪里?
Ahrefs拆解显示,ChatGPT主要依赖四类信息流:预训练数据、实时网络检索(RAG)、商业授权出版商内容,以及用户上下文与记忆。具体采信哪一路,取决于问题是否时效敏感、是否要求证据和上下文。
Query Fan-Out 对AI搜索优化有什么影响?
Query Fan-Out会把用户问题拆成多个更具体的子查询,再并发检索与汇总答案。因此,品牌官网、官方说明页、产品对比页和可被直接引用的事实页更容易进入AI回答链路,而不是只看传统关键词排名。
为什么传统SEO Top10不等于ChatGPT引用?
因为ChatGPT的检索与引用逻辑不同于传统搜索排序。实测中,ChatGPT最终引用页面与Google或Bing Top10仅约8%重合,说明AI更偏向官方源、直接事实和可验证内容,而非单纯依赖SERP排名。
Fan-Out分发该怎么做内容适配?
先把单页答案拆成可被检索的原子信息块:定义、对比、步骤、证据、FAQ。再用清晰标题、实体关系和可引用数据增强可抽取性,让模型更容易在多轮分发中命中你的内容。
AI引用率低时先改哪里?
优先检查内容是否缺少可验证来源、结构化摘要和明确结论。其次优化品牌实体一致性、页面权威信号与跨站提及,别只堆关键词;AI更偏向能直接回答问题且可信的页面。


