Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
阅读: 0.8B 参数如何越级碾压 2B 模型?Tether AI 开源端侧智能体 BotPsy 架构与四阶训练全解析
Share
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
BotPsy 0.8B 端侧智能体架构全景图
Prompt 语宙 > 强化 AI 学习 > 0.8B 参数如何越级碾压 2B 模型?Tether AI 开源端侧智能体 BotPsy 架构与四阶训练全解析
强化 AI 学习

0.8B 参数如何越级碾压 2B 模型?Tether AI 开源端侧智能体 BotPsy 架构与四阶训练全解析

Prompt 语宙研究院
最近更新: 2026年11月14日 下午4:06
BotPsy Qwen3.5 智能体Agent 模型蒸馏 端侧AI
Tether AI Research 开源的 0.8B 参数端侧智能体模型 BotPsy 架构图
SHARE
⚡ Prompt 语宙 AI 导读 · 30 秒核心看点
  • BotPsy 以 0.8B 参数实现端侧智能体越级表现,工具调用与多步任务能力显著增强。
  • 四阶段后训练流水线覆盖 SFT、MOPD 与双轮细粒度 RL,专门优化函数调用和长程自动化。
  • 在 BFCL、ACEBench、τ-bench、ToolSandbox 等基准上,BotPsy 多项成绩超过 2B 级模型。

💡 站外导读:在云端超大参数大模型运营成本高企、API 访问延迟波动且隐私合规风险加剧的背景下,Tether AI Research 正式开源了基于阿里 Qwen3.5-0.8B 底模打造的亚十亿参数端侧智能体模型 BotPsy。该模型针对端侧受限算力场景,首创涵盖监督微调(SFT)、多教师在线策略蒸馏(MOPD)与双轮细粒度强化学习(RL)的四阶段后训练流水线。实测数据显示,BotPsy 不仅在六大核心工具调用基准中全面超越同尺寸竞品,更在多项 Agent 指标上越级击败体量为其 2.5 倍的 2B 级模型,为隐私优先的端侧个人自主助理树立了全新工程标杆。

端侧 Agent 瓶颈突围:为何“亚十亿”参数模型成为兵家必争之地?

在当前大模型生态中,依赖云端前沿闭源旗舰(如 GPT-4.5、Claude 3.7 或 Gemini 2.0)构建智能体已显现出严重的工业化瓶颈:一方面,云端 API 调用的高昂成本难以收敛,且第三方供应商随时可能调整、限制甚至废弃接口访问;另一方面,将用户的个人隐私、商业机密、本地文件索引和高敏感设备控制权频繁上传至公共云端,面临极其严苛的数据主权与安全合规挑战。

阅读目录
  • 端侧 Agent 瓶颈突围:为何“亚十亿”参数模型成为兵家必争之地?
  • 基准跑分全景拆解:0.8B 小钢炮如何逆袭 2.5 倍体量对手?
    • BotPsy-0.8B 与主流轻量级模型核心基准性能对比表
  • 四阶段训练秘籍:SFT、多教师在线蒸馏与规则强化学习(RL)
    • 1. 阶段一:示范轨迹监督微调(SFT)
    • 2. 阶段二:多教师在线策略蒸馏(MOPD)
    • 3. 阶段三与四:双轮基于规则与验证器的强化学习(RL)
  • 边缘推理效率与安全实测:告别 Token 思考死循环与高延迟
      • 📝 站长洞察 (Editor’s Insight)

更为关键的是,真实世界中的绝大多数日常工作流——例如本地文件检索整理、系统设置调控、日程备忘录编排、轻量跨应用通知与数据清洗等,并不需要动用数百亿甚至万亿参数的通用认知能力。小型、轻量且高度专业化的端侧 Agent 既能以极低的计算功耗胜任这些日常任务,又能确保敏感凭据与数据决策 100% 留存在本地物理硬件中。Tether AI Research 推出的 BotPsy 正是这一趋势下的突破性产物。该模型基于阿里巴巴开源的 Qwen3.5-0.8B 底模,专为函数调用(Function Calling)与长程智能体自动化工作流而定制。
BotPsy 0.8B 端侧智能体架构全景图
▲ 图 1:Tether AI Research 开源的 0.8B 参数端侧个人助理模型 BotPsy 整体设计全景

基准跑分全景拆解:0.8B 小钢炮如何逆袭 2.5 倍体量对手?

在业界公认的 ≤1.2B 轻量模型分类中,BotPsy 展现出了极具统治力的工具调用与 Agent 综合性能。评测团队选取了四款最具代表性的轻量级基线模型(Qwen3.5-0.8B-Think 原生底模、LFM2.5-1.2B-Think、MiniCPM5-1B-Think 以及体量为其 2.5 倍的 Qwen3.5-2B-Think)进行了严格的同基准盲测。

实测结果表明,BotPsy 在六大工具调用与智能体基准中不仅全面刷新了同级别记录,更在其中五项基准上直接碾压了 2B 级模型:

  • 性能相比原生底模直接翻倍:在 Berkeley 函数调用基准 BFCL v4 上,BotPsy 得分从基模的 23.4 跃升至 44.0;在 ACEBench 上从 30.1 飙升至 58.7;在模拟真实电商、电信与银行场景的 τ-bench 上,综合得分由 23.2 跃升至 51.5;
  • 全面越级超越 2B 参数模型:在 BFCL v4(44.0 vs 37.7)、ACEBench(58.7 vs 55.4)、τ-bench(51.5 vs 46.5)、ToolSandbox 沙盒测试(64.6 vs 41.2)以及多步信息检索 BrowseComp-Plus(4.5 vs 2.8)上,BotPsy 均以显著优势超越了参数量为其 2.5 倍的 Qwen3.5-2B-Think,仅在 Claw-Eval 上略有落后(46.5 vs 48.9);
  • 卓越的拒识能力(Anti-Hallucination):智能体不仅要懂得何时调工具,更要清楚何时“不该调用”。在 BFCL v4 幻觉测试中(检测当环境中不存在合适工具时模型能否主动拒绝胡乱调用),BotPsy 斩获了全场最高的 86.1 分;在面对参数缺失或畸变请求的 ACEBench 特殊用例测试中,得分由基模的 13.7 暴增至 51.3 分。
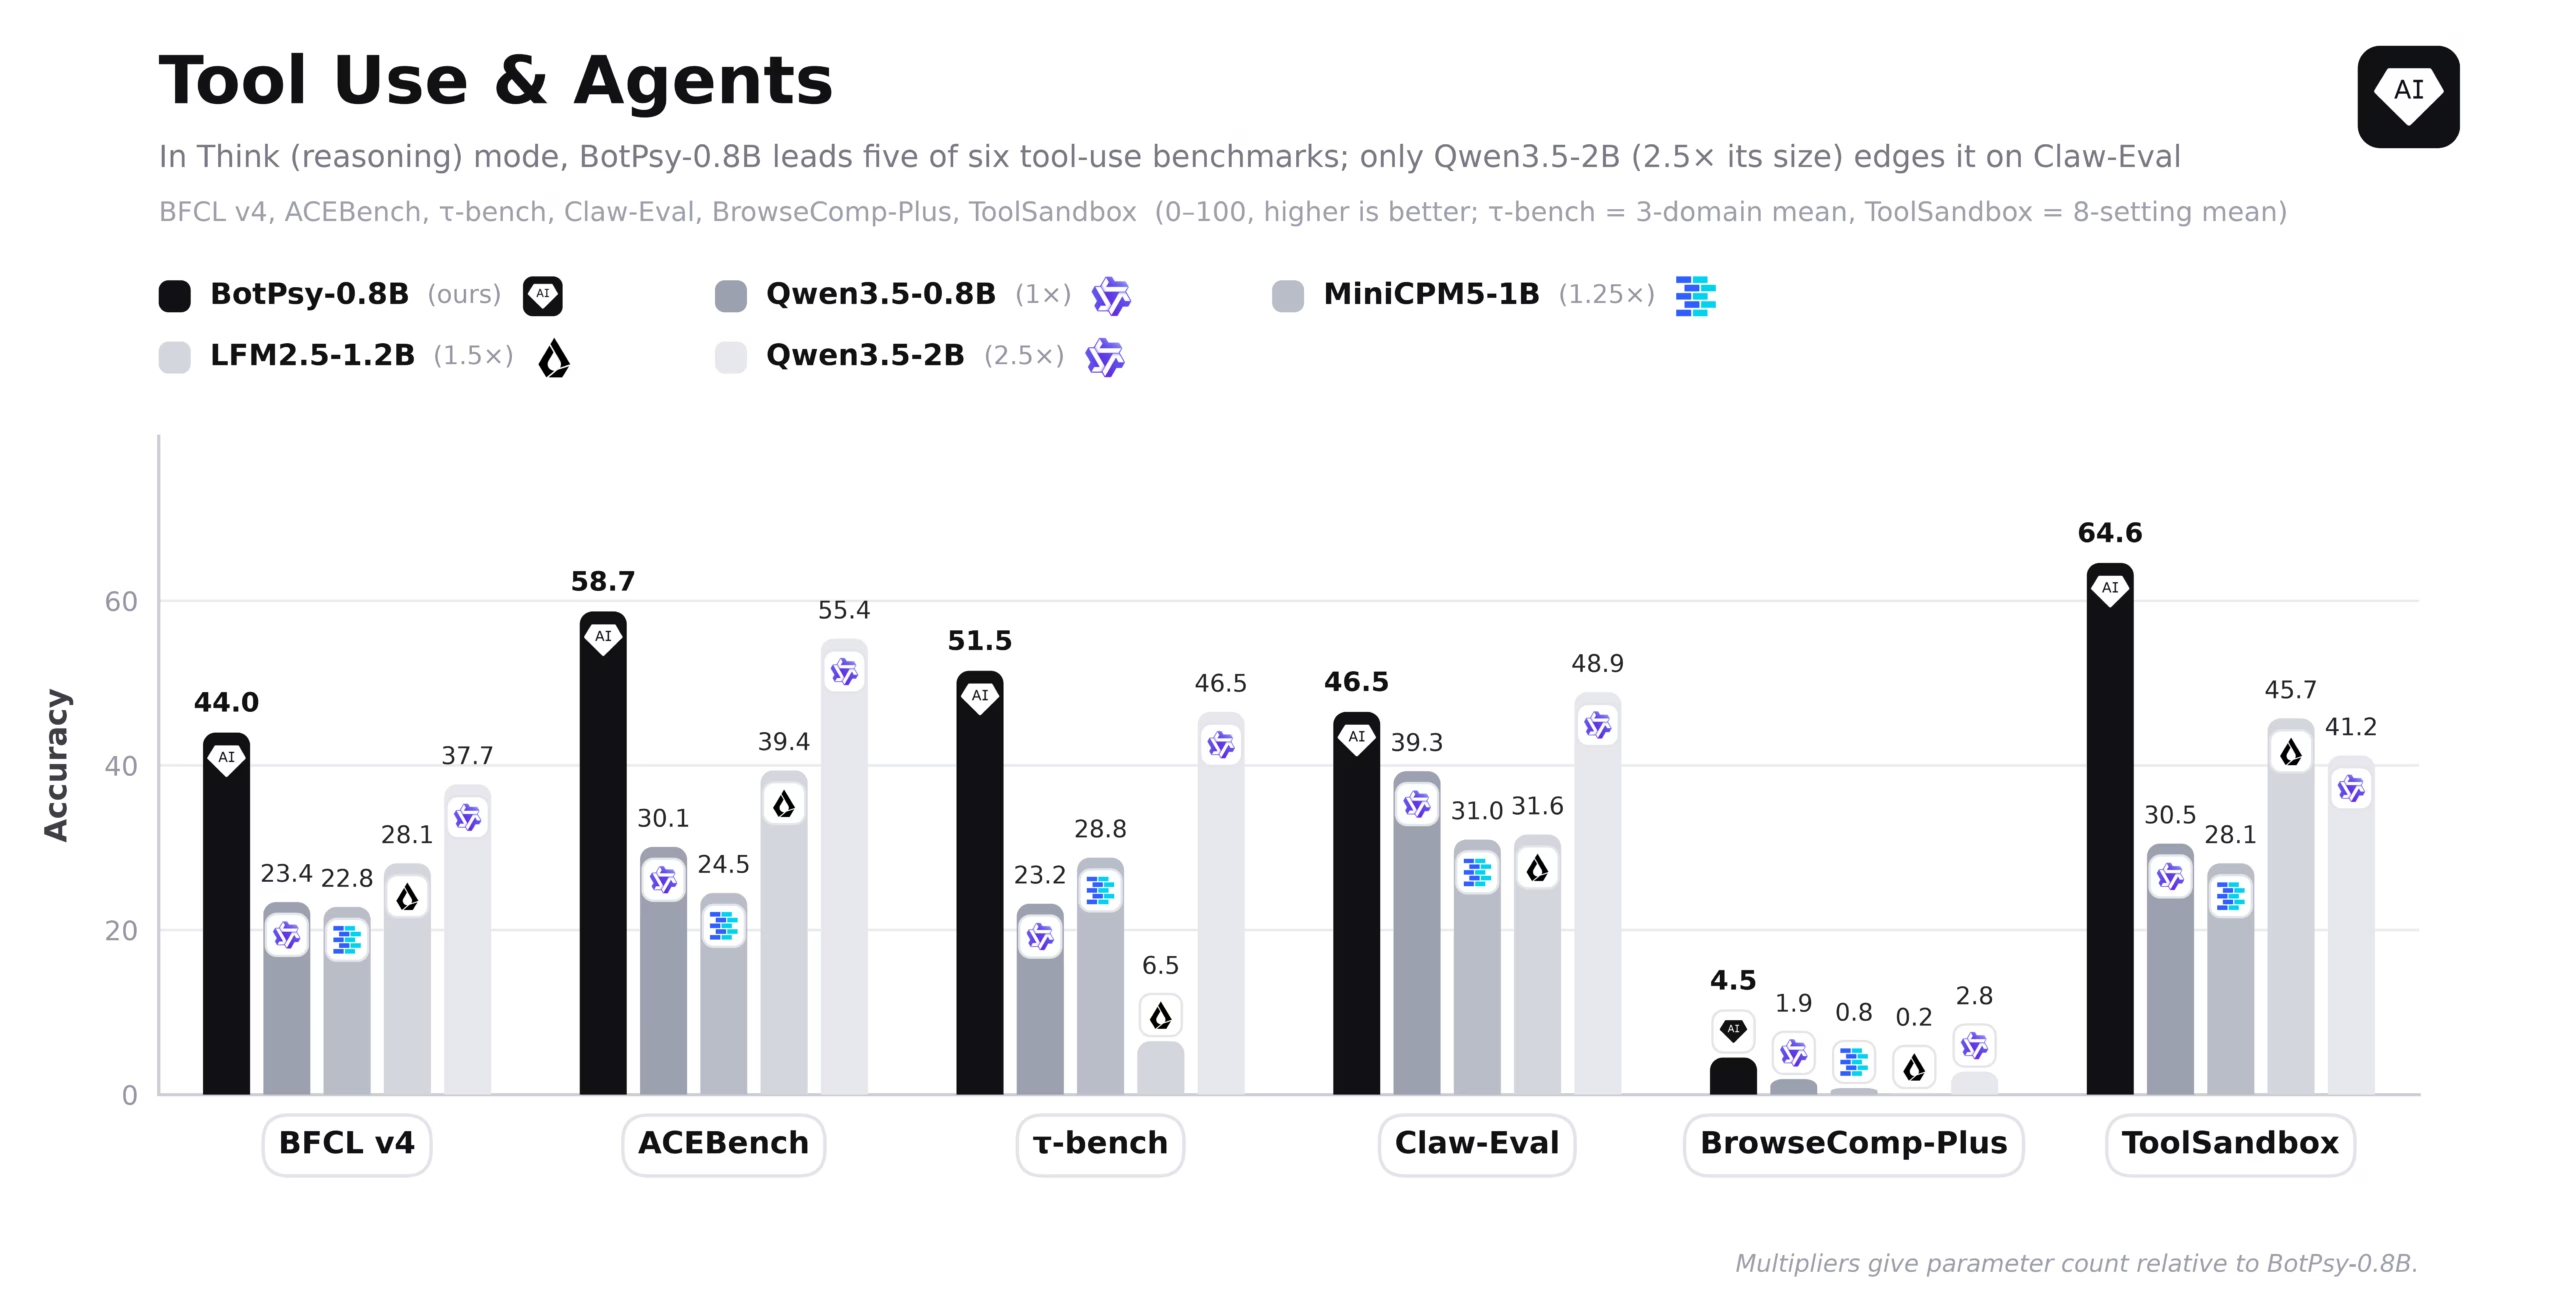
BotPsy 0.8B 与四款对比模型在 BFCL、ACEBench、tau-bench 等基准上的得分对比条形图
▲ 图 2:BotPsy-0.8B 与主流轻量级对比模型在六项核心工具调用与智能体评测中的量化跑分

BotPsy-0.8B 与主流轻量级模型核心基准性能对比表

基准评测集 (Benchmark) Qwen3.5-0.8B (底模) LFM2.5-1.2B-Think MiniCPM5-1B-Think BotPsy-0.8B (本文) Qwen3.5-2B-Think (2.5×)
BFCL v4 (工具调用总评) 23.4 32.1 29.8 44.0 37.7
ACEBench (智能体用例) 30.1 41.5 38.2 58.7 55.4
τ-bench (综合多轮履约) 23.2 36.4 31.0 51.5 46.5
ToolSandbox (沙盒自动化) 30.5 38.9 33.7 64.6 41.2
BFCL 幻觉拦截拒识率 42.8 61.0 58.4 86.1 79.3
IFEval (精准指令遵循) 59.7 72.3 68.1 90.8 80.0
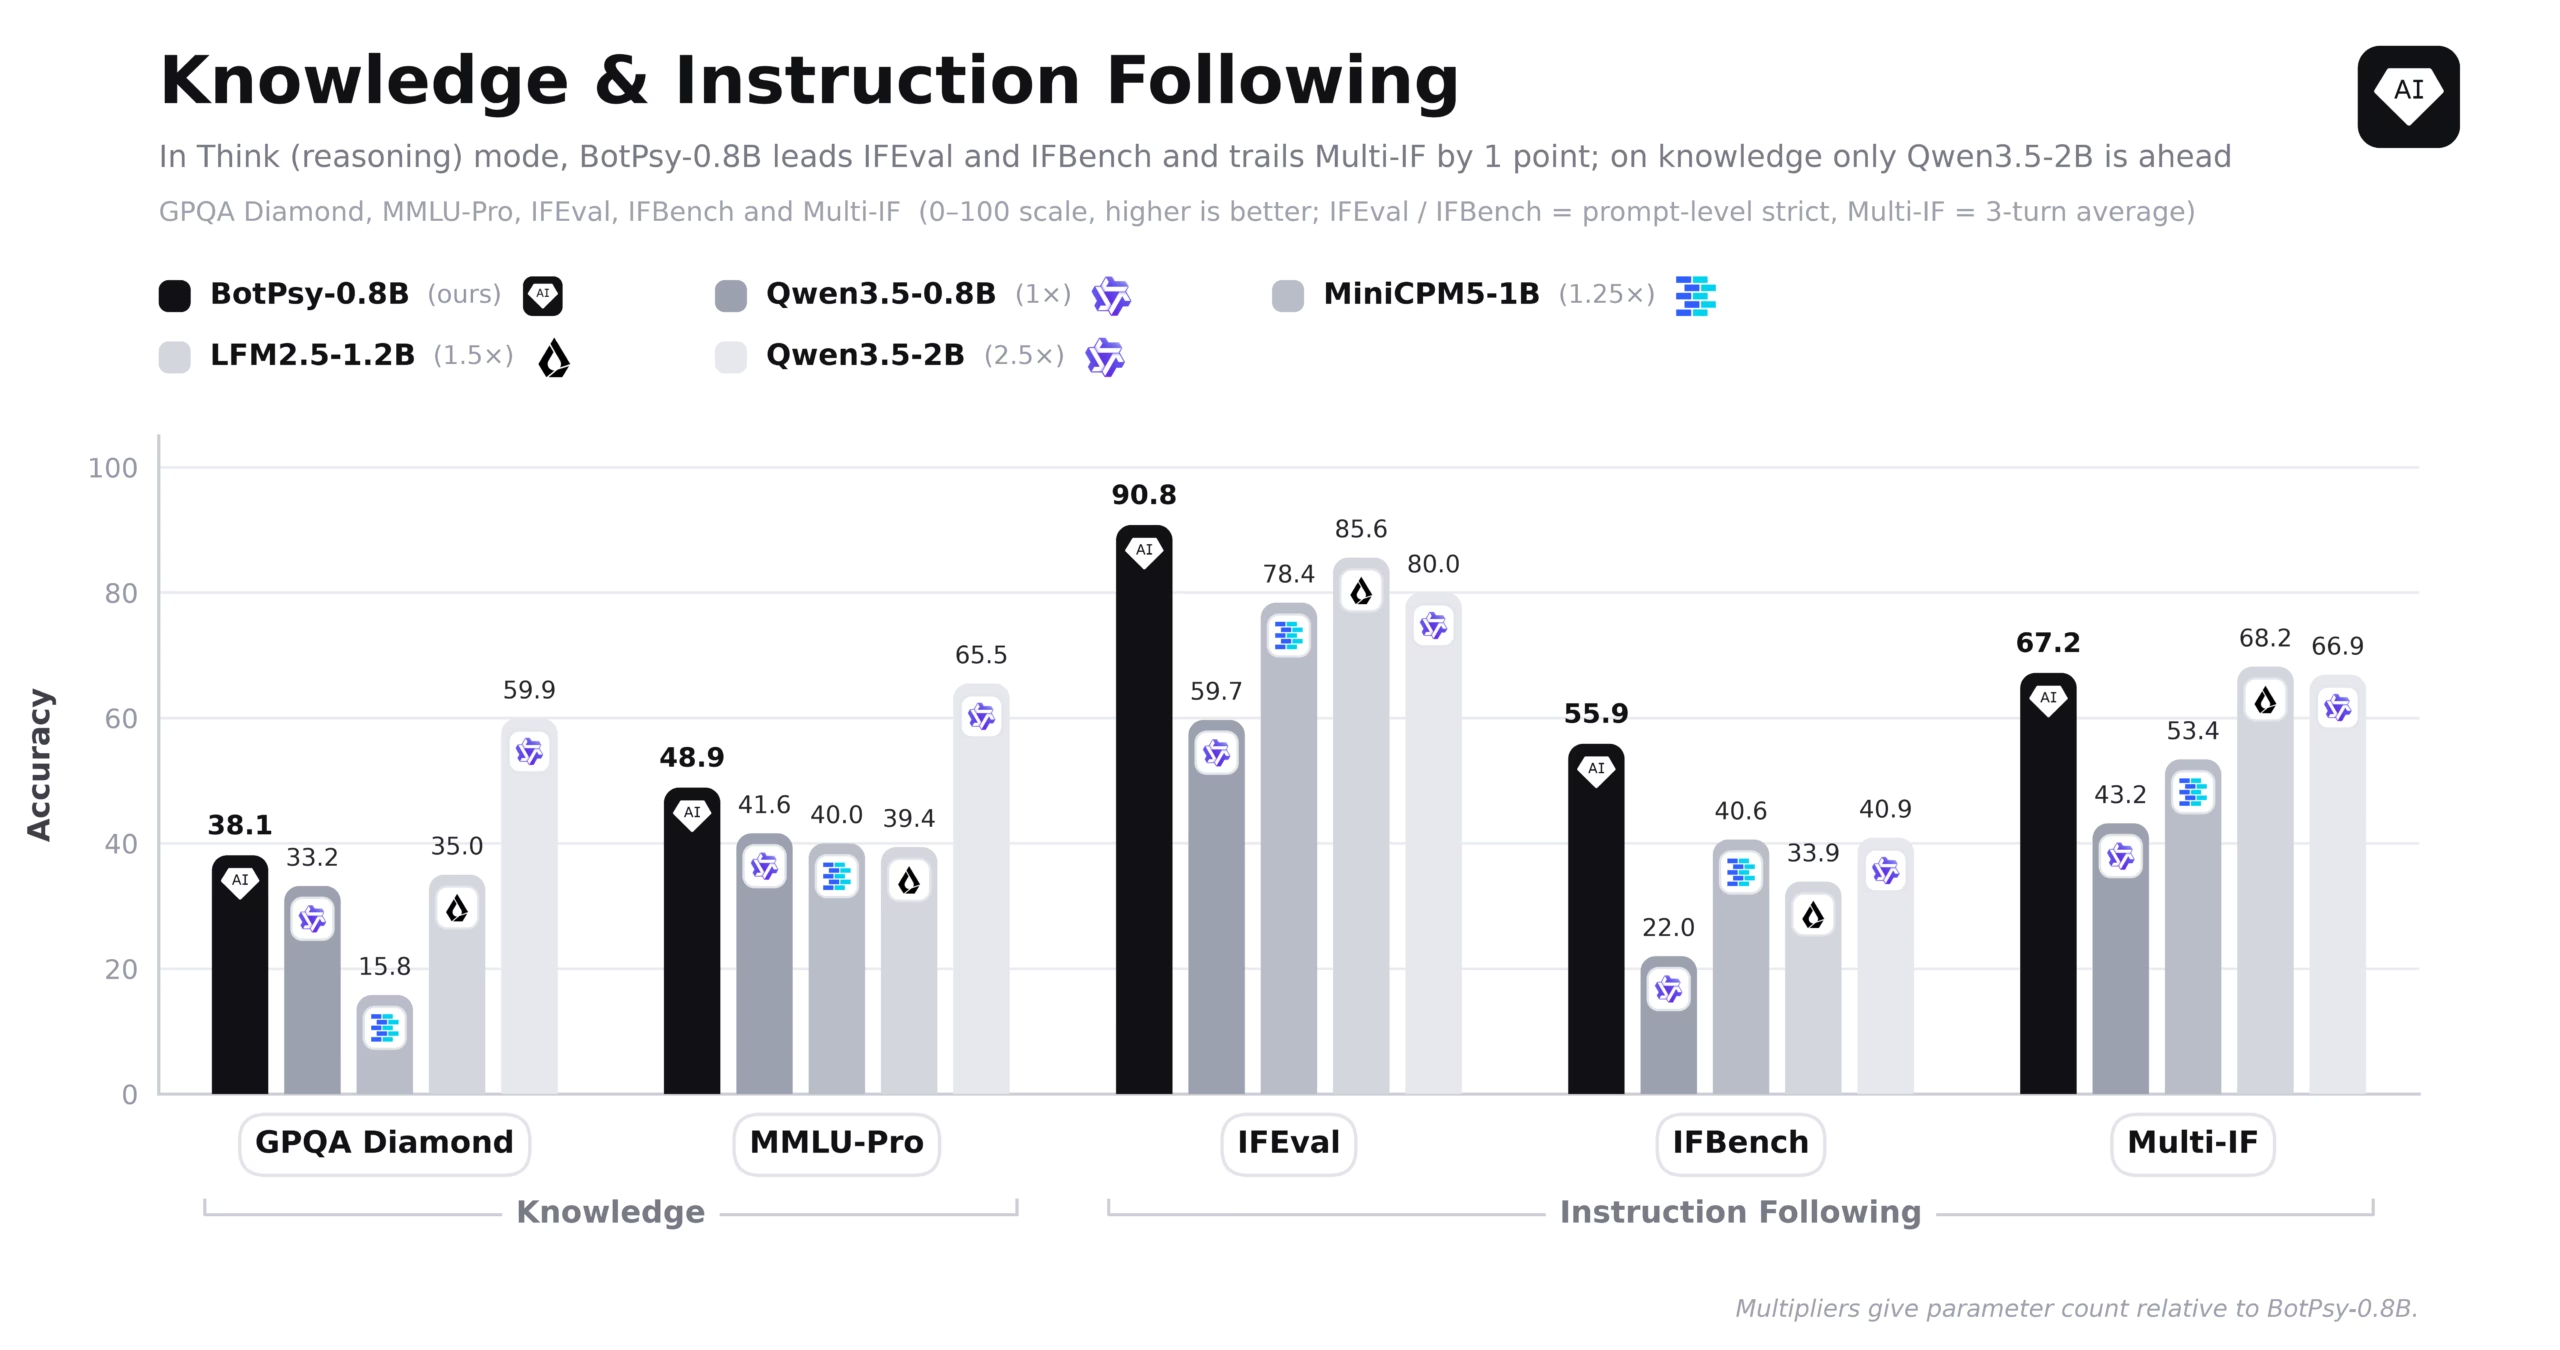
BotPsy 0.8B 在 IFEval、IFBench、GPQA Diamond、MMLU-Pro 评测得分柱状图
▲ 图 3:BotPsy-0.8B 在指令遵循(IFEval/IFBench)与通用知识(GPQA/MMLU-Pro)上的综合能力保全表现

四阶段训练秘籍:SFT、多教师在线蒸馏与规则强化学习(RL)

参数量仅为 0.8B 的小模型何以在工具调用上实现超越自身参数量极限的跃迁?研发团队揭示了其核心武器:四阶段递进式后训练流水线(Four-Stage Post-Training Recipe)。每个阶段均以上一阶段的最优 Checkpoint 为起点,融合了示范模仿、教师蒸馏与可验证奖励三大不同的学习信号。
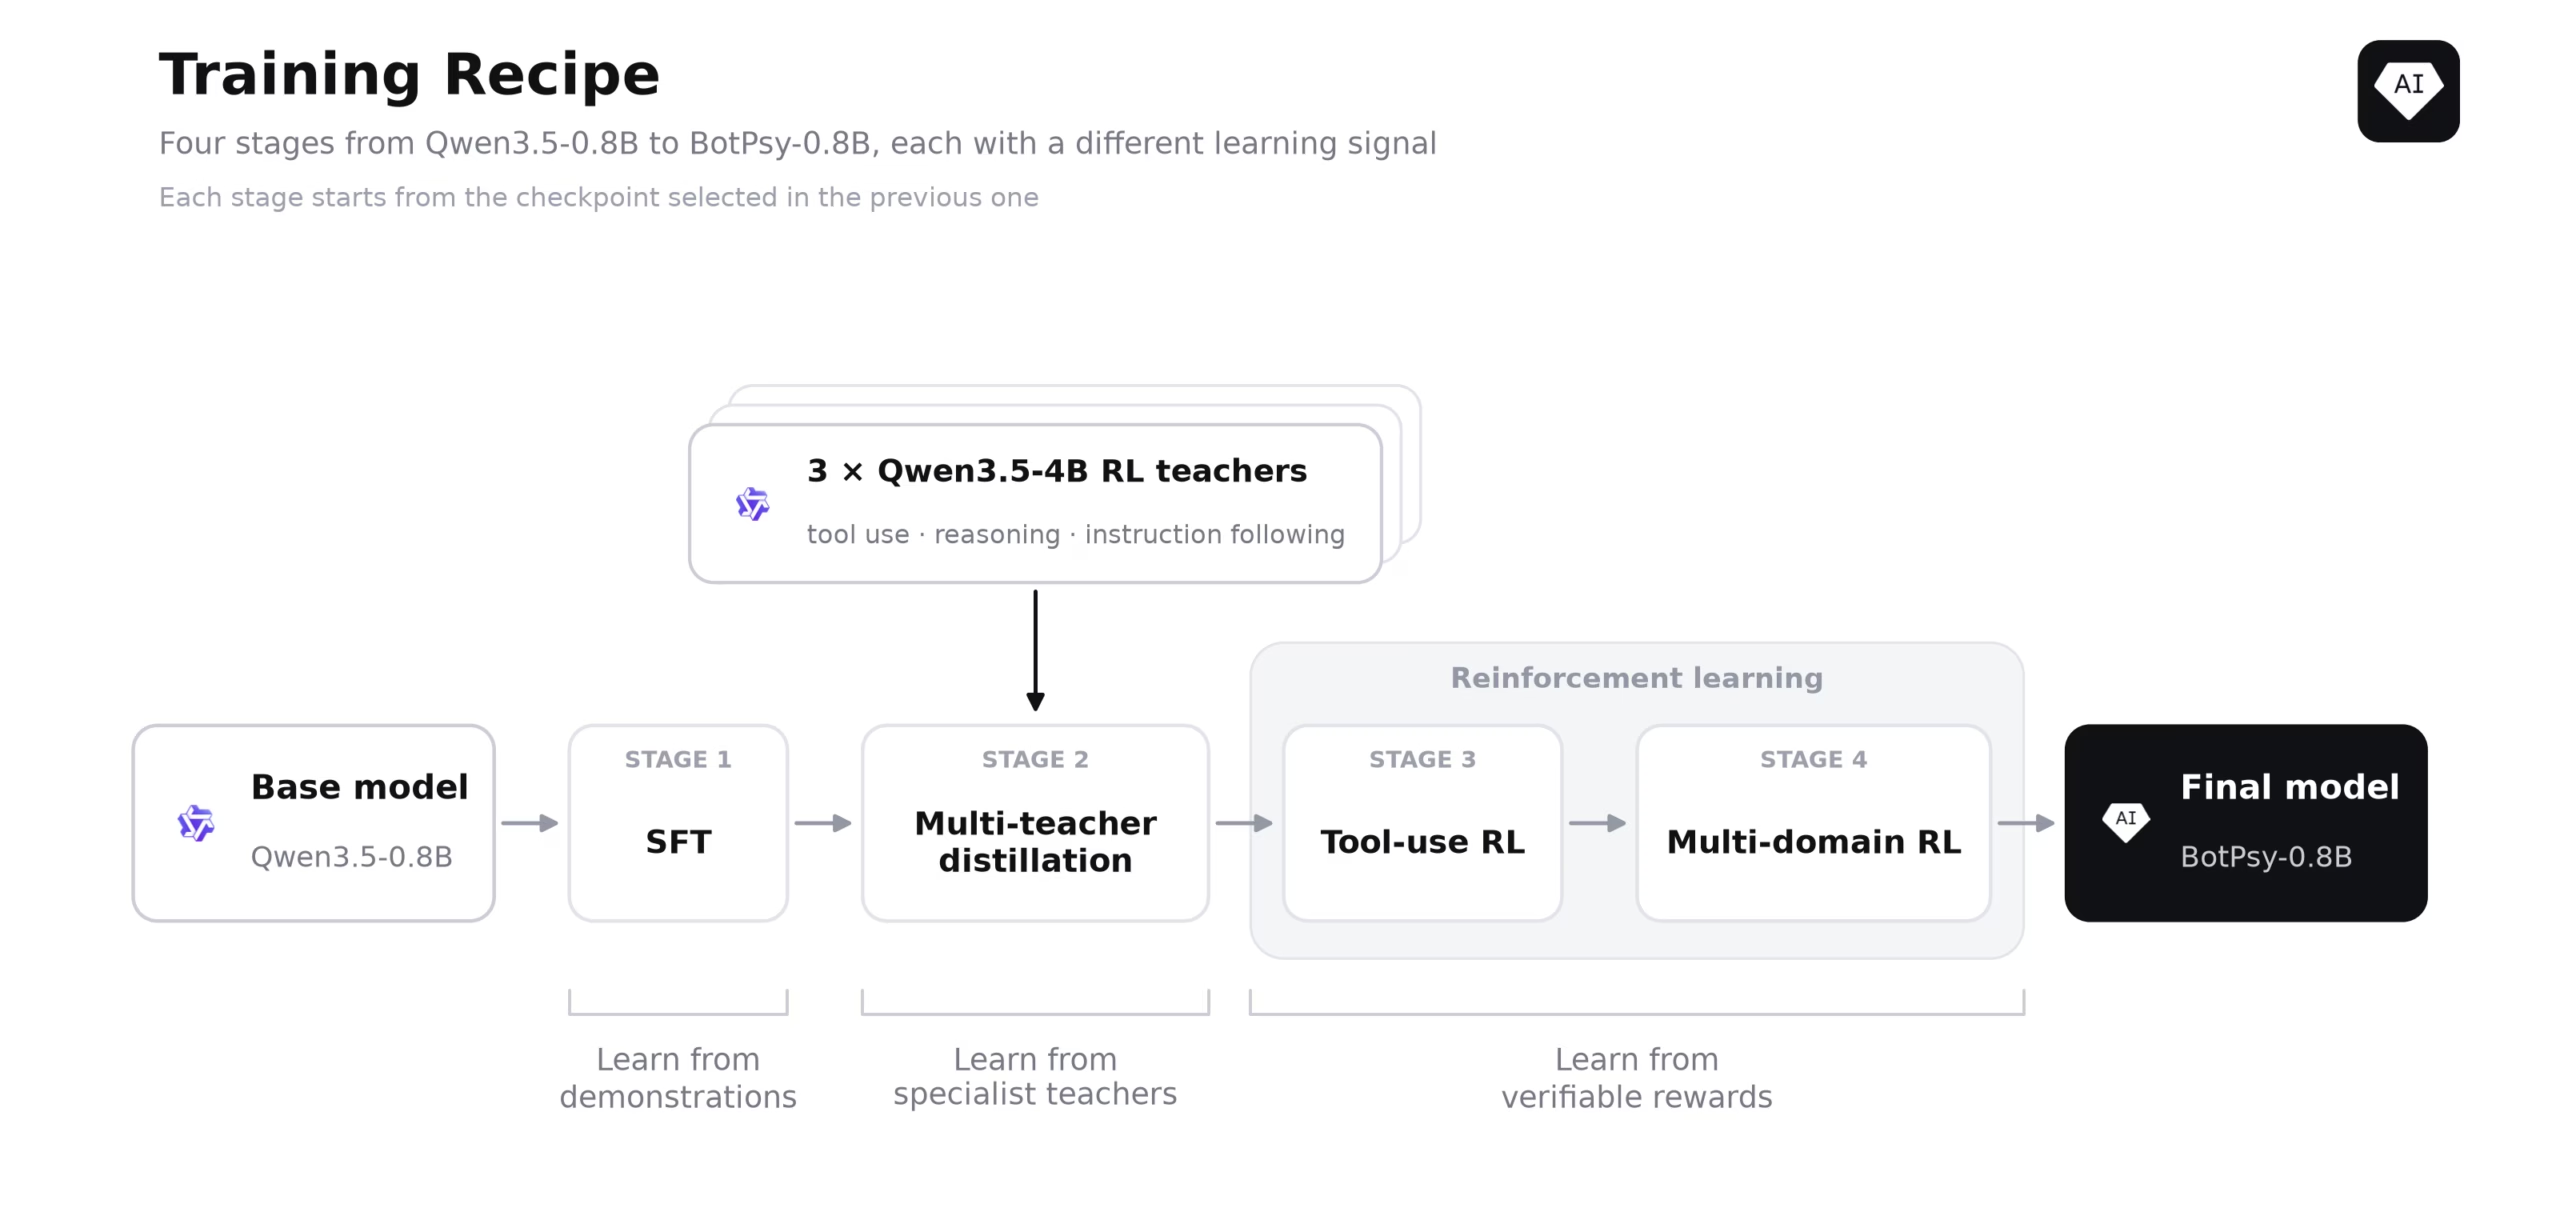
SFT、多教师在线蒸馏 MOPD 与双轮强化学习 DAPO 训练流水线流程图
▲ 图 4:BotPsy 四阶段后训练流程架构(涵盖 SFT、MOPD 在线蒸馏及双阶段 DAPO 强化学习)

1. 阶段一:示范轨迹监督微调(SFT)

在仿真智能体环境中采集高质量的多轮对话轨迹,覆盖单步调用、并行多工具调用、多步状态机转移以及负样本(何时不应调用任何工具)。在此阶段,模型快速学会了严格的 JSON Schema 函数入参格式规范。

2. 阶段二:多教师在线策略蒸馏(MOPD)

针对小模型在纯 SFT 后普遍出现的“灾难性遗忘”(通用推理与指令遵循能力急剧退化),研究团队首创了 MOPD(Multi-teacher On-Policy Distillation) 架构:

  • 预先通过强化学习分别训练了三个专精于工具调用、通用推理和指令遵循的 4B 级别专家教师模型;
  • 在学生模型(0.8B)生成自身响应时,动态将 Prompt 路由至对应领域的专家教师,利用逐 Token 级别的逆向 KL 散度(Reverse KL Divergence)作为在线策略反馈信号;
  • 该机制成功帮助模型在大幅拉升工具调用准确率的同时,彻底补齐并反超了在 SFT 阶段受损的通用知识与复杂指令遵循能力。
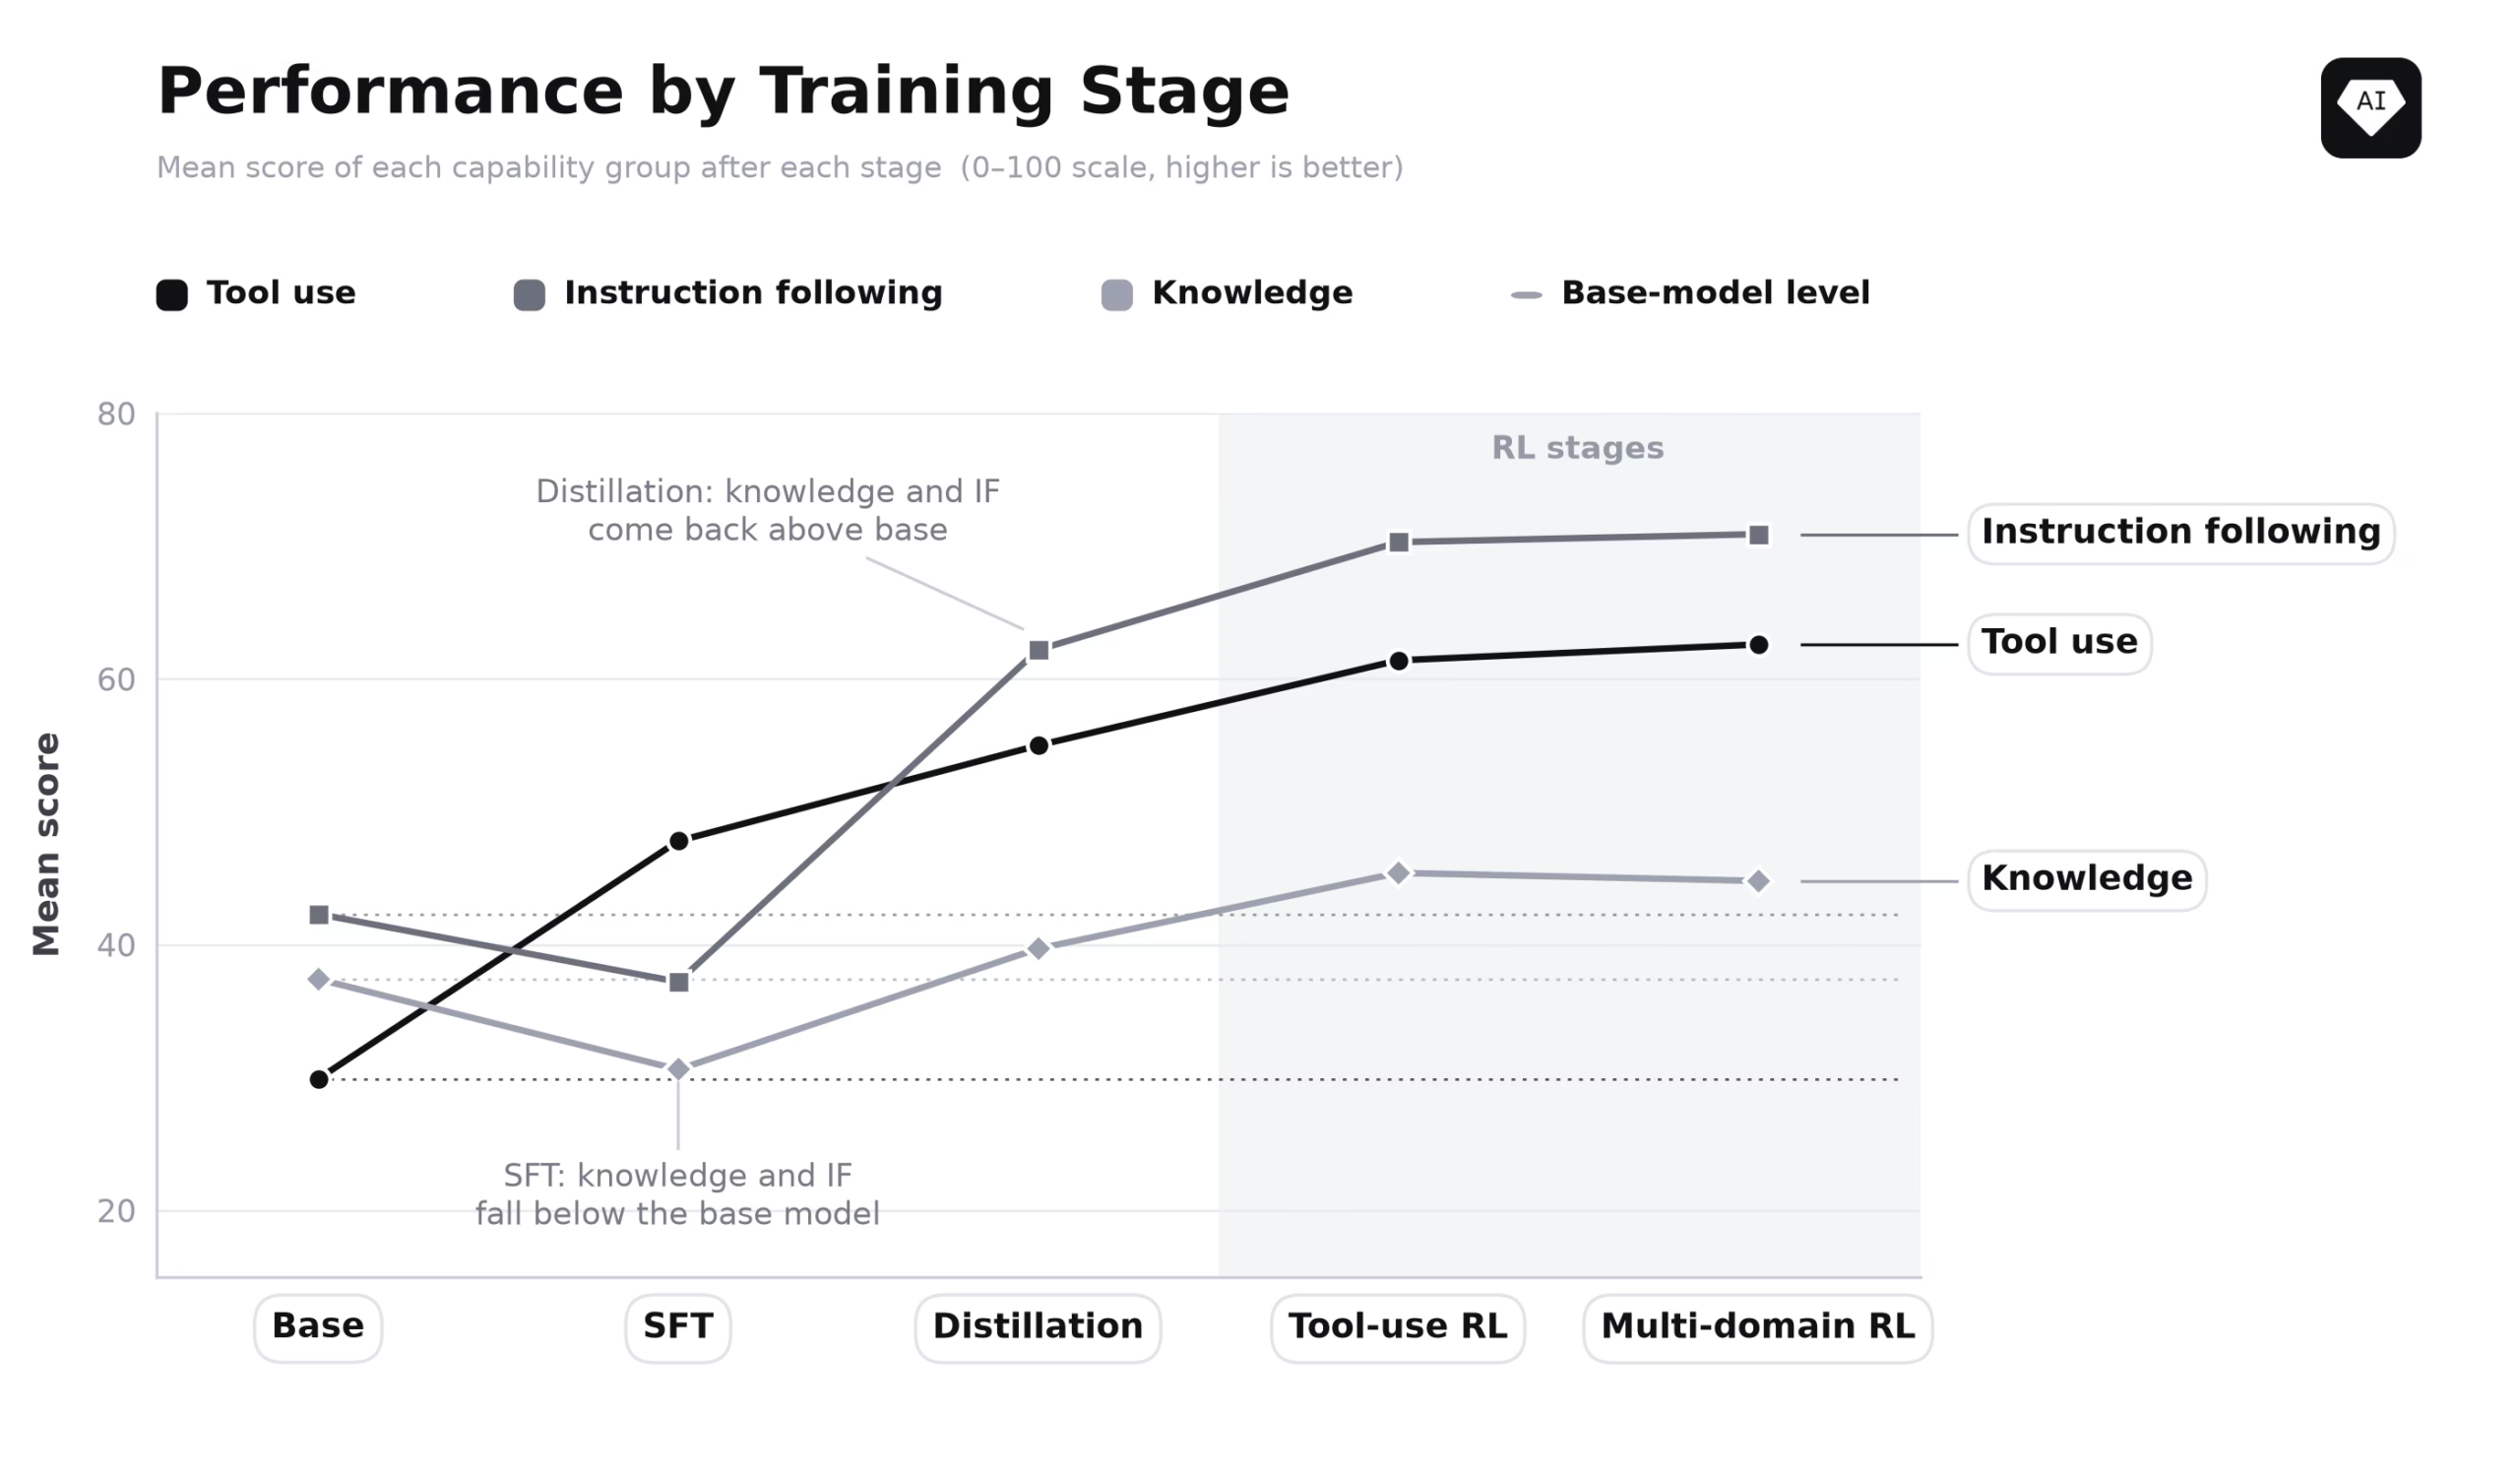
BotPsy 在 SFT、MOPD 和 RL 各阶段后能力变化的折线对比图
▲ 图 5:各训练阶段后工具调用(Tool Use)、指令遵循(IF)与通用知识得分的动态演进折线

3. 阶段三与四:双轮基于规则与验证器的强化学习(RL)

采用分布式大规模 RL 框架 DAPO 进行端到端优化,完全依赖环境验证器给出的确定性奖励:

  • 第一轮 RL(工具调用专攻):引入类似 ToolRL 的细粒度偏步奖励(Partial Credit),不同于传统粗暴的 0/1 二元成败判定,验证器会逐一校对预测的函数名、参数名和入参数值,给予渐进式奖励梯度;
  • 第二轮 RL(通用可验证领域扩充):将训练语料扩展至代码执行、数学推导、结构化输出等客观可验证场景。即便该阶段不包含多轮对话语料,模型的长程多轮函数调用鲁棒性依然获得了显著外推增益。
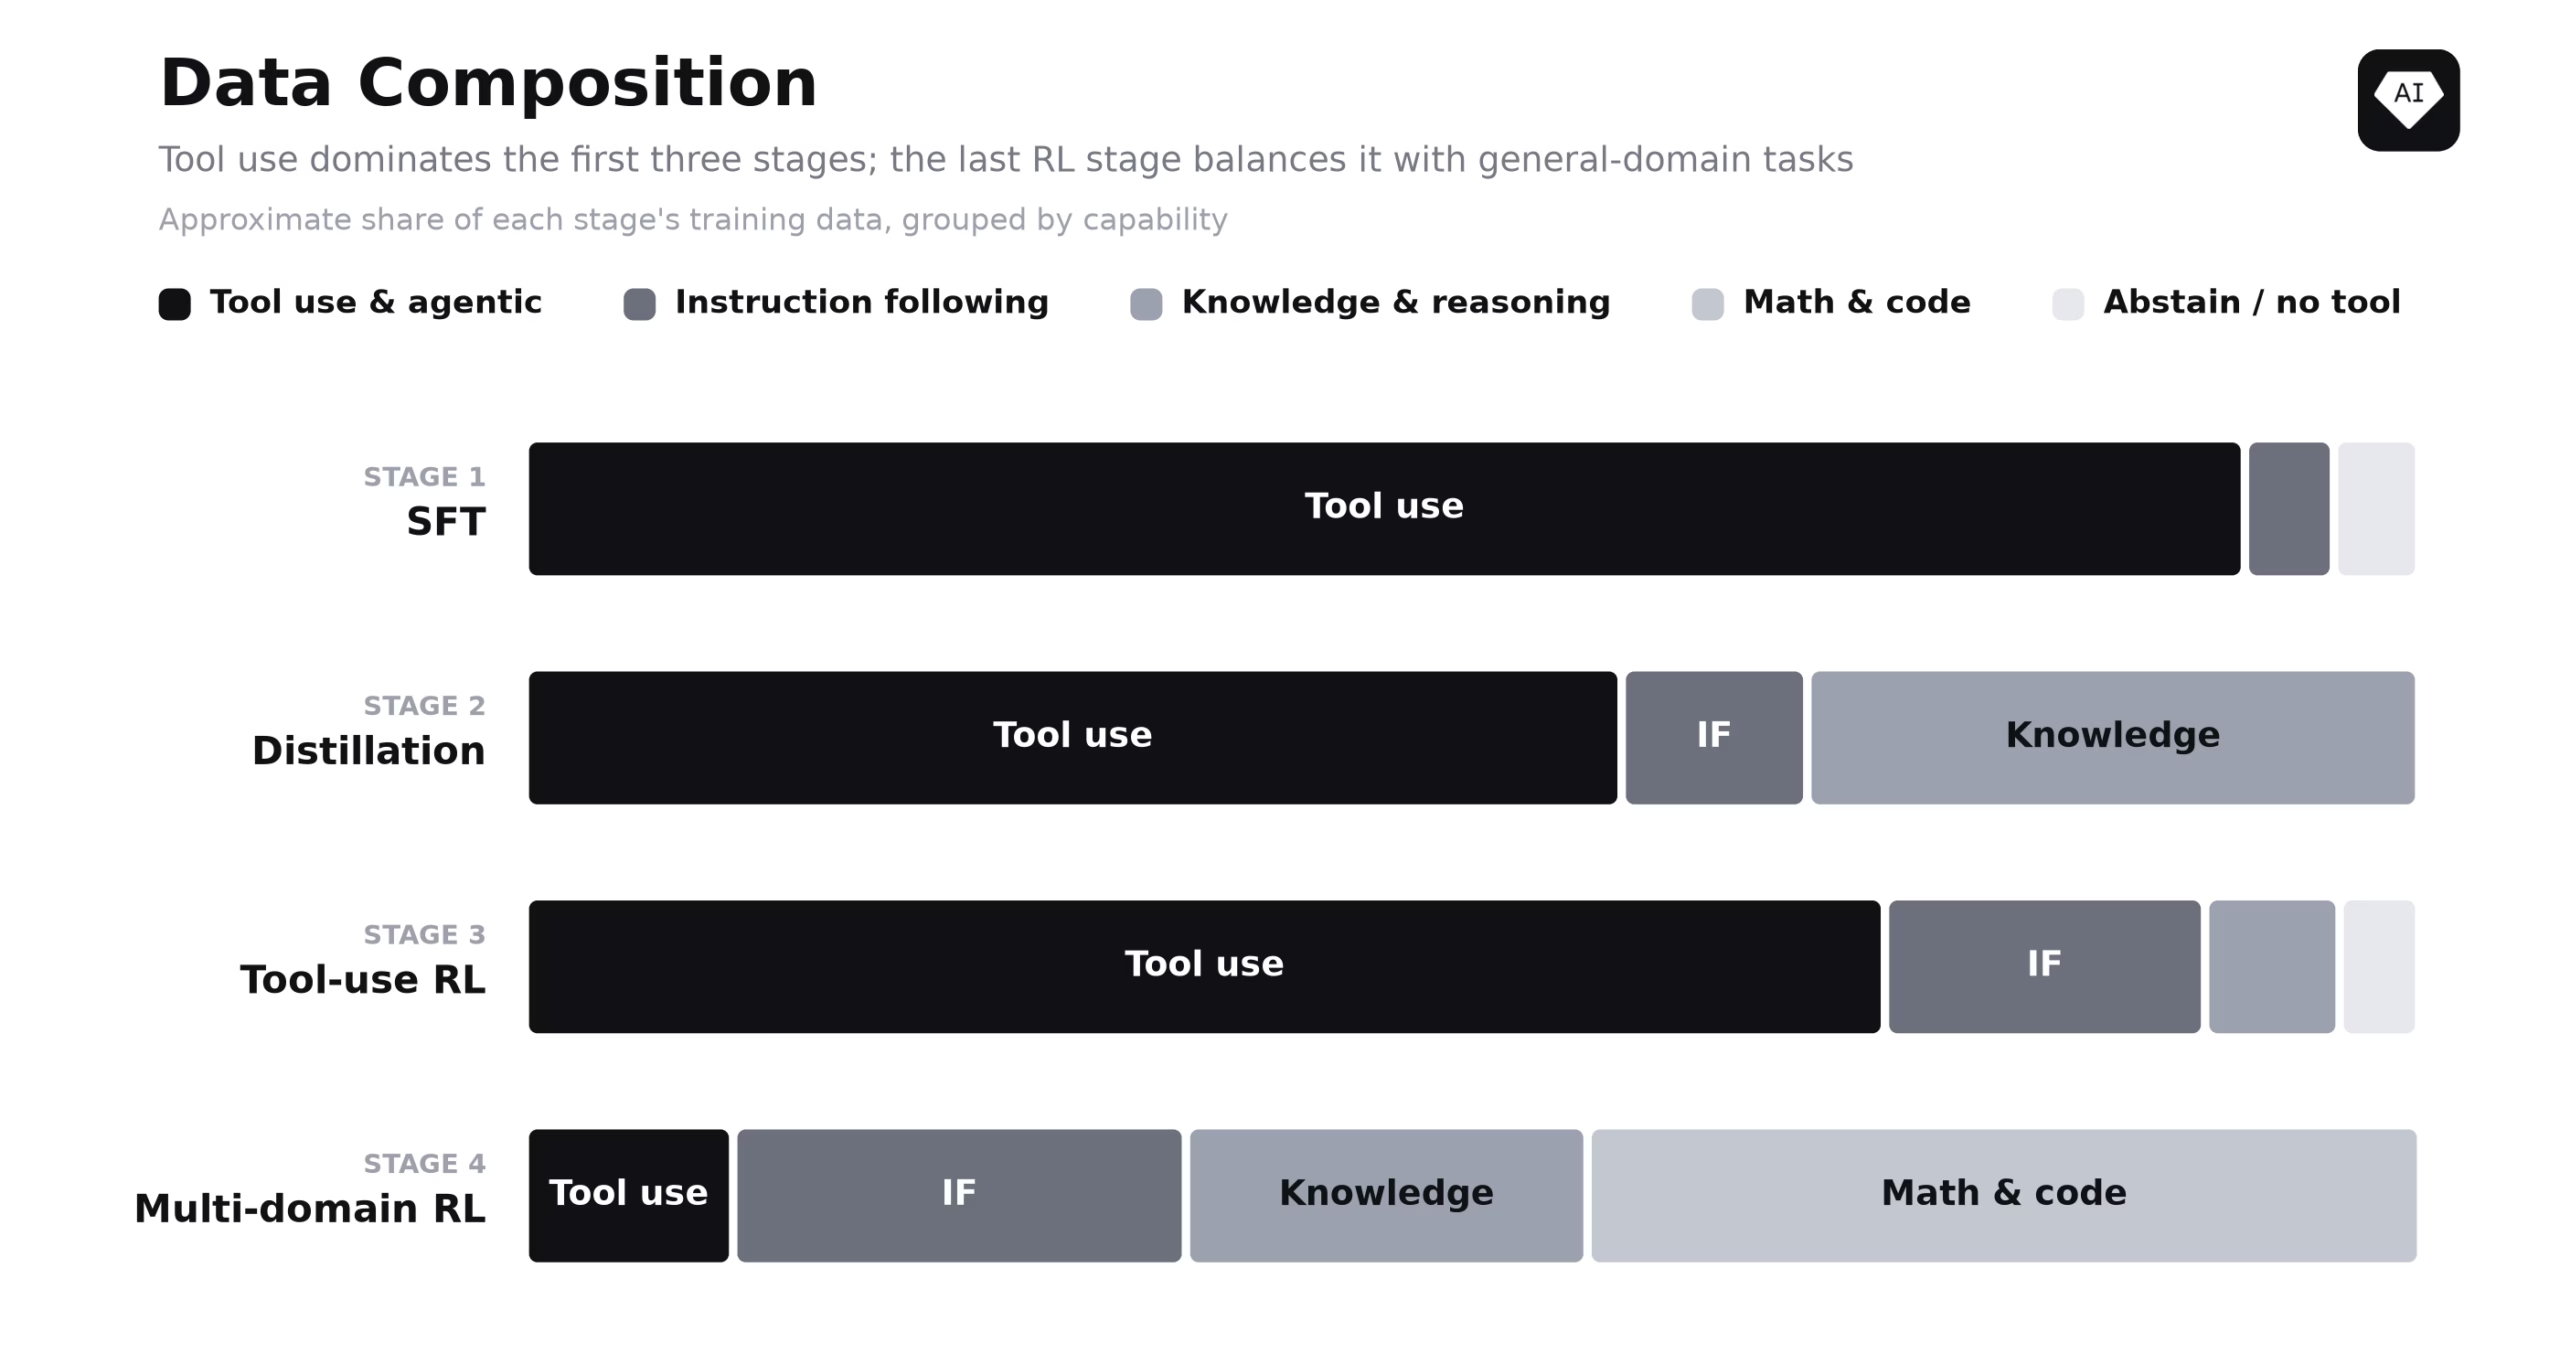
展示各训练阶段工具调用数据、通用知识与代码数据配比的堆积条形图
▲ 图 6:BotPsy 在 SFT、MOPD、RL-Round1 与 RL-Round2 四个阶段中的数据混合配比全景

边缘推理效率与安全实测:告别 Token 思考死循环与高延迟

在端侧设备的实际部署中,模型推理速度、电池续航与显存占用决定了用户体验的生死线。测试表明,BotPsy 在思考模式下的推理效率实现了质的飞跃:

  • 推理 Token 消耗锐减 3 倍:在所有模型均能正确答对的基准试题中,BotPsy 获得正确答案所需的思维链 Token 数量大幅压缩——在 GPQA Diamond 上仅消耗 3,690 Tokens(原生基模为 11,563 Tokens,减少 3.1 倍);在 MMLU-Pro 上仅消耗 1,912 Tokens(基模为 5,105 Tokens,减少 2.7 倍);
  • 彻底攻克死循环崩溃:在 IFBench 复杂测试中,小模型极易陷入机械重复的自言自语死循环,基模的死循环发生率高达 22.9%,而 BotPsy 骤降至 1.4%;因耗尽 32k 上下文窗口而崩溃的概率由 28.3% 暴降至 0.2%;
  • 端侧安全红线加固:在跨越六类危害场景的自动化红队对抗测试中,BotPsy 产生不安全响应的概率仅为 21%(基模为 36%,同尺寸竞品平均在 35%~47%);在最受关注的间接提示词注入攻击(Prompt Injection)测试中,不安全率从 46% 压降至 31%。

目前,Tether AI Research 已在 Hugging Face 社区以 Apache 2.0 商业友好开源许可证全量释出模型权重。官方不仅提供了原生 Safetensors 格式,更同步推出了经过精细量化的 GGUF(包含 bf16、Q8 与 Q4 规格),支持开发者通过 llama.cpp、Ollama 或 QVAC SDK 在 Mac、Windows PC、树莓派及各类中高端移动终端上实现零门槛极速本地直跑。

📝 站长洞察 (Editor’s Insight)

在端侧 AI 智能体开发实践中,业界长期受困于“小模型弱智跑不通 Agent、大模型烧钱烫手塞不进手机”的两难死局。Tether AI 开源的 BotPsy 最具震撼力的工业价值在于:它彻底推翻了“亚十亿参数无法胜任复杂函数调用”的固有认知。通过多教师在线逆 KL 散度蒸馏(MOPD)解决通用遗忘,再结合细粒度参数级强化学习奖励(DAPO),BotPsy 证明了通过高阶后训练流水线,小模型完全可以演化为精准、严谨且具备拒识护栏的专用外脑。这种轻至数百兆、免网络传输、杜绝隐私外泄且思考 Token 减少 3 倍的端侧智能体,才是真正能够大规模普及进每台手机与穿戴设备的个人助理终极形态。

🧭 文中关联 AI 工具官网与参数卡(语宙 AI 导航)
Claude ↗
Anthropic 打造的新一代安全人工智能模型,具备超长上下文理解能力,最强代码伴侣。
Gemini ↗
Google推出的AI聊天对话机器人Gemini。
❓ 常见问题解答(FAQ)
BotPsy 0.8B 为什么能超过 2B 模型?

核心原因是针对端侧 Agent 做了专门后训练,而不是只做通用能力堆叠。它基于 Qwen3.5-0.8B 底模,通过 SFT、多教师在线策略蒸馏和双轮细粒度强化学习,重点强化工具调用、拒识能力和多步任务执行,因此在多项基准上越级表现。

BotPsy 适合哪些本地智能体场景?

它更适合隐私优先、算力受限的端侧任务,例如本地文件检索整理、系统设置调控、日程编排、跨应用通知和轻量数据清洗等。文章强调这类工作流不一定需要超大参数模型,但需要稳定的函数调用与本地执行能力。

BotPsy 在哪些基准上表现最好?

文章提到它在 BFCL v4、ACEBench、τ-bench、ToolSandbox、BrowseComp-Plus 和 BFCL 幻觉拦截等测试中表现突出。其中在 BFCL v4、ACEBench、τ-bench、ToolSandbox 和 BrowseComp-Plus 上均超过 Qwen3.5-2B-Think,仅在 Claw-Eval 上略低。

🕸️ 语宙向量知识图谱 · 语义强关联深度内链
🤖 所属权威专题:AI Agent 智能体工作流 →
🏛️ Prompt 语宙研究院 · Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
📄 Markdown 纯净版
💡 这篇内容对您有启发吗?
📡 RSS 订阅✨ 提交 AI 工具 / 合作
🚀 Prompt 语宙 AI 创作者生态:探索 2,800+ 全球实用 AI 工具与高精度生图提示词咒语库
🧭 语宙 AI 导航 (ai.paooo.com)🎨 AI 生图 Prompt 库📚 核心专题导航⚡ AIGC 早报生成器
小语种成功“破解”了 GPT-4 的限制[译]
OpenAI 和 Elon Musk [译]
如何选择你的人生伴侣 [译]
Mixtral 8x7B — 混合专家模型(Mixtral of Experts) [译]
马斯克访谈 —— 尼古拉·坦根采访,谈 AI、特斯拉、中国电动汽车、Twitter(X)、SpaceX、中国电动汽车、企业文化与管理、火星殖民[译]
TAGGED:BotPsyQwen3.5智能体Agent模型蒸馏端侧AI
分享
Email 复制链接 打印
Share
Prompt 语宙研究院 头像
ByPrompt 语宙研究院
Follow:
Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
上一篇 黄仁勋辞职引发硅谷震荡:悬浮GPU核心裂变,算力网络重构与AI泡沫风险以光影隐喻呈现。 黄仁勋辞职引发硅谷震荡:英伟达算力投资网重构与 AI 泡沫风险深度拆解
下一篇 H200中转征税暗箱与白宫政治交易疑云!美国国会重磅调查英伟达对华芯片许可:Megaspeed通道、黄仁勋闭门质询与算力监管终局深度拆解 H200中转征税暗箱与白宫政治交易疑云!美国国会重磅调查英伟达对华芯片许可:Megaspeed通道、黄仁勋闭门质询与算力监管终局深度拆解
Ad image
Ad image

最近更新

Google Search 实装 Gemini 4 Hydrogen 搜索界面展示 Query Fan-Out 展开结果
告别单一链接与零点击死局!Google Search全面实装Gemini 4 Hydrogen:深度拆解Query Fan-Out多路并发查询、动态视觉表格与GEO站长流量新变局
AI 工具
SemiAnalysis关于黄仁勋卸任英伟达CEO及全球半导体AI供应链影响的深度研报
1.5GW芯片暗流、5300亿表外兜底与SK海力士特惠松动!SemiAnalysis万字深度复盘英伟达“无黄时代”:独家拆解60人单王结构崩解、RASA法案死锁与全球开源算力大洗牌
AIGC 资讯
GitHub Copilot 在 VS Code 与 Coding Agent 中切换 Google Gemini 4 Hydrogen 界面
多步Agentic编码提速且按量阶梯计费!GitHub Copilot全面上线支持Google Gemini 4 Hydrogen:覆盖全系用户、企业策略管控与主流IDE模型编排全景深度拆解
最新趋势
Meta Reality Labs工程团队实现Cuttlefish在Apple Silicon Mac原生架构拓扑
终结双轨分裂且让AI智能体跑进真机沙箱!Meta重磅攻克Android高保真虚拟设备Cuttlefish原生运行Apple Silicon Mac:解密vhost-user解绑、HVF内存重构与端侧验证闭环全景架构
最新趋势

相关推荐

大语言模型能取代编译器吗? [译]
强化 AI 学习

大语言模型能取代编译器吗? [译]

宝玉的分享
AI编程 ChatGPT Cursor GitHub Copilot OpenAI
国产地震大模型谛听单台站秒级快报:连续波形流入AI,深层P波特征可视化并触发预警脉冲。
强化 AI 学习

汇聚2000万连续波形且实现单台站秒级快报!国产首个地震大模型“谛听”重磅亮相:听懂地球心跳、P波深层特征提取与AI防灾减灾全景深度拆解

Prompt 语宙研究院
AI for Science 单台站预警 地震大模型 谛听 防灾减灾
为何糟糕的科研代码胜过严格遵循编程规范的代码 [译]
强化 AI 学习

为何糟糕的科研代码胜过严格遵循编程规范的代码 [译]

宝玉的分享
AI编程 大模型微调 开源大模型
Copilot for CLI 中解释字段的示例
强化 AI 学习

我们是如何利用大语言模型 (LLM) 改进 GitHub Copilot 的探索之旅 [译]

宝玉的分享
AI编程 Copilot Cursor GitHub Copilot OpenAI
/ Prompt 语宙 /

探索生成式 AI 的无限创作潜能,一站式获取前沿 AIGC 资讯、高阶 Prompt 咒语与全球实用 AI 工具。

核心专栏

  • Remaker AI
  • BGRemaker 抠图Hot
  • AIGC 工具
  • Prompt 咒语生成器
  • 去水印工具

生态与服务

  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作

标签

开源大模型 AI智能体 AI办公效率 AI绘画提示词 OpenAI 大模型微调 Midjourney AI编程 stable diffusion AI视频生成 ChatGPT 3D与空间智能 HuggingFace AI音频与语音 RAG检索增强 Claude Flux AIGC Gemini 通义千问 Anthropic Llama Cursor DeepSeek Prompt AI Agent Kimi 智谱AI YouTube GPT Image 2
Prompt 语宙Prompt 语宙
Follow US
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.