

💡 站外导读:长期以来,AI 语音合成(TTS)、声音克隆与音乐生成领域始终被两个极端撕裂:一边是昂贵且存在声纹隐私泄露风险的商业云端 API,另一边则是部署门槛极高、饱受 CUDA 版本冲突与 Conda 依赖地狱折磨的学术开源模型代码。全新开源的桌面级音频创作套件 YoVoice 彻底打破了这一僵局。它依托高效的 C++ 原生推理引擎 audio.cpp,实现双击免配置开箱即用,全功能涵盖文本转语音、3 秒无缝音色克隆、AI 完整歌曲作曲以及专业五线谱 MIDI 编曲,更原生支持 MCP 协议无缝接入 AI Agent,堪称 2026 年个人创作者与技术团队不可错过的生产力神器。
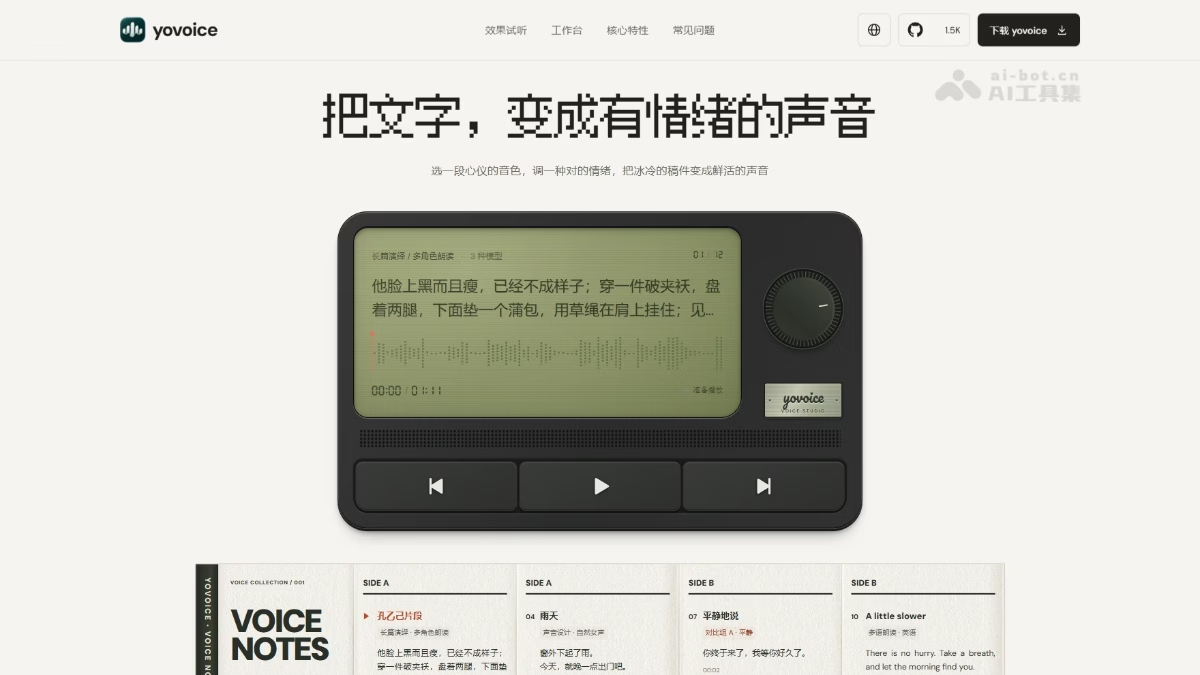
一、 架构重构:基于 audio.cpp 打造的纯本地 C++ 推理引擎
在过去的开源语音项目中,用户想要在本地跑通一个音色克隆模型,通常需要经历漫长而痛苦的环境配置:Python 虚拟环境搭建、PyTorch 与 CUDA 算子版本匹配、Conda 依赖冲突排查……动辄几十 GB 的依赖包经常让非专业开发者望而却步。
YoVoice 从底层架构上进行了彻底的颠覆。它完全摆脱了对 Python 运行时的依赖,基于高性能 C++ 编写的底层推理引擎 audio.cpp 构建:
- 极简安装体验:Windows 端提供单文件
.exe安装程序,macOS 端提供原生.dmg镜像,双击即可完成部署,告别一切终端命令与环境配置; - 深度硬件原生加速:Windows 版本内置 CUDA 12.4 与 CUDA 13.3 双运行时,自动检测并充分压榨 RTX 系列显卡 Tensor Core 算力;macOS 版本深度适配 Apple Silicon 架构,原生支持 Metal Performance Shaders,在 M 系列芯片的统一内存架构下实现极高的推断能效比;
- 100% 本地运算零隐私外泄:文本合成、声纹特征提取与波形渲染全部在用户物理机器的 CPU/GPU 上本地完成,无需连接外网,输入文稿与克隆音频绝不经过第三方服务器,从根源上杜绝了企业机密与个人生物声纹信息的泄露隐患。
二、 全功能链路解构:从 3 秒零样本克隆到五线谱 MIDI 编曲
不同于多数仅提供简陋 WebUI 的实验性开源项目,YoVoice 打造了一套媲美专业数字音频工作站(DAW)的现代化图形操作界面:
| 功能模块 | 核心技术亮点 | 创作者实战价值 |
|---|---|---|
| 零样本声音克隆 (Zero-Shot) | 仅需上传 3 至 10 秒无杂音样本音频,即可瞬时提取高保真声纹隐空间嵌入向量,无需二次微调。 | 快速为 AI 漫剧、短视频解说批量定制专属角色声线,免去高昂录音棚成本。 |
| 文本提示捏音色 (Prompt-to-Voice) | 直接输入自然语言 Prompt(如“低沉浑厚的纪录片旁白”、“充满磁性的知性主播”)生成独一无二的声音。 | 彻底规避知名公众人物声音版权争议,构建完全原创的品牌声学资产。 |
| AI 音乐与五线谱编曲 | 内置 ACE-Step 1.5 Turbo 音乐生成模型,并开创性地提供可视化五线谱编辑器与 General MIDI 渲染器。 | 既能用歌词+风格生成流行歌曲,又能手动微调旋律音符并导出分轨音频(Stems)与 MIDI 文件。 |
| 多轨工程与 Take 对比 | 支持“故事配音、语音生成、音乐、乐谱”四类工程,多次生成自动归档为独立 Take。 | 像在 Pro Tools 中录音一样并排试听对比不同语调情绪,挑选最佳演绎版本。 |
三、 深度横向对比:YoVoice 对决阿里 CosyVoice 与云端 API
为了直观评估 YoVoice 在现代音频技术栈中的工程定位,我们将 YoVoice 与主流学术模型 CosyVoice 以及常见云端 SaaS 配音服务进行了全维度对比:
| 对比维度 | YoVoice (桌面工作站) | 阿里 CosyVoice (学术模型) | 商业云端 TTS API |
|---|---|---|---|
| 部署门槛 | 极低(双击安装包即用) | 较高(需自行配置 Python/PyTorch) | 极低(开通即用) |
| 推理与使用成本 | 完全免费(零按字计费) | 自建 GPU 算力成本 | 高昂(按字符/分钟线性累加) |
| 底层推理架构 | 自研 C++ audio.cpp 引擎 | Python + PyTorch 原生生态 | 云端专有推理集群 |
| 五线谱与音乐生成 | ✅ 完美支持 (MIDI/Stems 导出) | ❌ 仅支持语音合成 | ❌ 通常需单独购买音乐服务 |
| 多智能体集成 (MCP) | ✅ 原生内置 MCP Server + CLI | 需开发者二次封装 FastMCP | 需编写专属 API SDK 适配层 |
四、 开发者与 Agent 生态:原生支持 Model Context Protocol
尤为令人惊喜的是,YoVoice 不仅是一款面向剪辑师与创作者的 GUI 软件,更在发布首日即原生支持 Model Context Protocol(MCP)服务器标准。这意味着:
在 Cursor、Claude Code、Antigravity 等支持 MCP 的 AI Agent 编程工作台中,开发者只需一键将 YoVoice 配置为本地音频 MCP 工具,即可通过自然语言直接操控 YoVoice 完成海量文档的有声化渲染、字幕自动时间轴对齐以及游戏 NPC 对白的批量生成,真正让音频创作接入了完全自动化的软件工程流水线。
📝 站长洞察 (Editor’s Insight)
从 llama.cpp、whisper.cpp 到如今驱动 YoVoice 的 audio.cpp,以纯 C/C++ 封装重构学术界 Python 原型已成为现代 AI 工具走向大规模实用化的必由之路。对于内容创作者和出海自媒体而言,传统按字计费的云端配音 API 在长视频、有声书场景下存在极大的边际成本劣势,且企业级敏感数据出境合规风险与日俱增。YoVoice 不仅通过本地算力彻底清零了推理账单,更重要的是其通过 MCP 协议打开了“多智能体音视频全自动装配线”的想象空间——脚本 Agent 编写分镜、YoVoice 本地渲染配音、ComfyUI 本地生成视频分镜,整个创作管线完全自治且零 API 开销。这是多媒体 AI 工具演进的教科书级典范。


