

💡 站外导读:在当前文生图技术的演进脉络中,尽管各类扩散模型在摄影级写实与艺术插画上已经逼近以假乱真的高度,但在面对工业级平面设计、营销长图海报、漫画对白与 UI 界面排版等商业化高频场景时,始终被“中文文字乱码变形、长段落被强行截断、图文元素空间拓扑漂移”三大死穴死死掣肘。近日,复旦大学 NLP 团队联合上海创智等顶尖实验室,正式开源了新一代图文协同生成模型 —— MOSS-Image。该模型以 5B 参数的单流 Diffusion Transformer(DiT)为底座从零展开预训练,全面支持高达 4K Token 超长提示词解析、中英文复杂长段落精准渲染以及可编辑的结构化 JSON Layout 布局控制。本文将为视觉算法工程师与前沿开发者深度剖析其技术架构与评测细节。
一、直击视觉设计工业化死穴:为什么传统扩散模型搞不定图文混排?
长期以来,商业设计师尝试将 Midjourney 或传统开源文生图模型引入生产流水线时,往往会遭遇尴尬的挫败感:画面光影细节令人惊艳,但只要在提示词中要求打上一句中文标语或排版几段产品参数,输出的文字往往变成扭曲的“符咒”或毫无意义的乱码拼贴。
这种技术断层的根源主要来自三个底层瓶颈:
- 字形高频特征与 VAE 重构失真:主流潜空间变分自编码器(VAE)在进行下采样压缩时,倾向于保留宏观色彩与轮廓,严重丢失笔画边缘等高频几何信号,导致解压生成的汉字缺胳膊少腿。
- 上下文窗口与文本编码器局限:早期模型大多依赖 CLIP 或轻量级 T5,上下文窗口普遍被锁死在 77 或 512 Token,根本无法容纳详尽的多层级文本内容与版式样式描述。
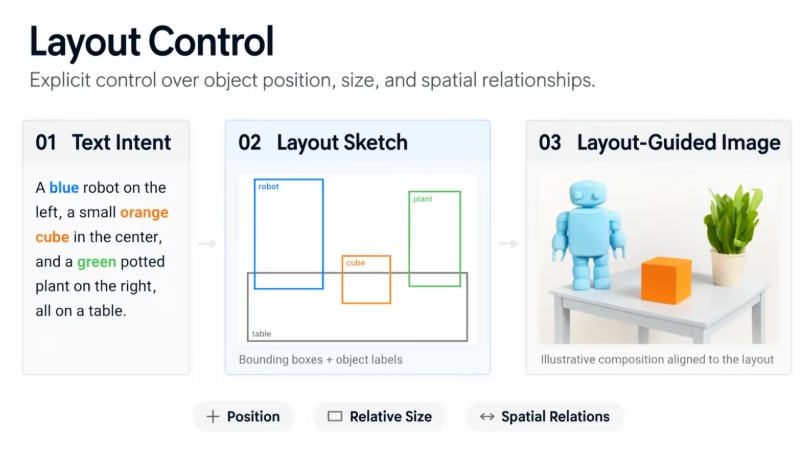
- 空间布局缺乏显式几何监督:传统 Cross-Attention 属于无约束的软对齐,模型无法精确理解“左上角距边缘 50px 放置居中小标题”等严格的工程化排版坐标。
二、5B 单流 DiT 底座:Muon–AdamW 训练配方与 Qwen3.5 协同
为了从根本上攻克这一难题,OpenMOSS 团队摒弃了缝缝补补的后处理补丁路线,选择从零预训练一套专为精准图文混排量身定制的基础架构:
- 5B 参数 Single-stream DiT 基座:采用单流扩散变换器(Single-stream Diffusion Transformer)设计,让图像潜变量与文本 Token 在相同的深层注意力空间中实现无缝的因果交互,大幅压降多流架构中的信息传递失真。
- Qwen3.5-9B 超强文本理解底座:模型破天荒地引入 Qwen3.5-9B 作为全量文本编码器,直接将文本解析能力拓展至 4K Token 上下文,无论多么冗长的多段落设计需求都能完整捕获。
- FLUX.2 VAE 高精图像解码:配合业界顶尖的 FLUX.2 VAE 架构,实现对细小文字边缘、笔锋转折与高分辨率排版网格的保真还原。
- Muon–AdamW 混合优化配方:在 3B 规模的多粒度图文数据集预训练中,团队开创性地运用了 Muon 与 AdamW 结合的创新优化算法,在保持超大规模 Batch 稳定性的同时,显著加速了文字拓扑特征的收敛速率。
| 评测基准与维度 | 主流开源文生图模型基线 | MOSS-Image 实测成绩 | 工程化突破意义 |
|---|---|---|---|
| LLTB 长文本渲染 (Mean-6) | 普遍低于 60-70 分区间 | 斩获 96.3 分(创造开源权重历史新高) | 均值 1339 字符长段落完整不截断 |
| 7Bench 检测框 mIoU | 约 0.45 – 0.55 | 高达 0.8786 (整体布局 mIoU 0.6788) | 元素空间相对位置与层级精准受控 |
| RealLayoutArena 盲测 Elo | 1600 – 1700 基准分 | 突破 1807.34 分(行业绝对领跑) | 人类审美偏好与商业排版视觉双达标 |
| 提示词上下文容量 | 77 ~ 512 Token 截断 | 支持最长约 4K Token 超长提示 | 可直接粘贴长篇营销文案与完整排版规约 |
三、端到端意图规划与可编辑 JSON Layout:代码级精确控图
除了基座模型本身的强悍素质,MOSS-Image 另一项被开发者津津乐道的利器在于其内置的意图感知提示增强(Prompt Enhancement, PE)与结构化 JSON Layout 引擎:
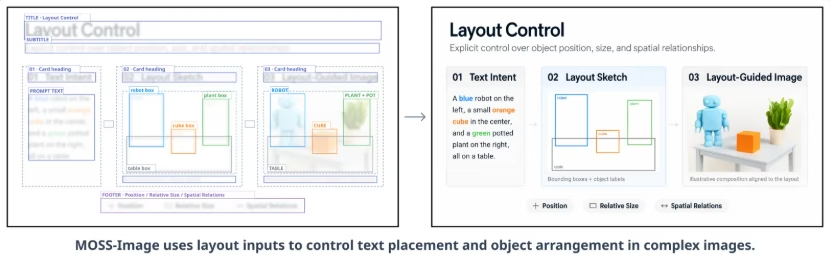
- 自动规划模块:当用户输入“帮我做一张科技感浓厚的 AI 发布会海报,标题是开源赋能未来,附带三条核心亮点”这种高度抽象的口语指令时,外部 PE 模块会自动将其拆解为包含具体字号层级、色板代码(Hex RGB)以及归一化边界框(bbox: [ymin, xmin, ymax, xmax])的详细工程定义。
- 可二次编辑的 JSON 布局:生成的结构化布局以标准 JSON 规范输出,开发者可以在前端拖拽或手动微调特定图文块的坐标,随后直接驱动模型按照新约束重绘局部,真正实现了“像写代码一样可复现、可版本控制”的工业级控图工作流。
四、生态适配与边界声明:Apache-2.0 开源与落地考量
在生态整合方面,MOSS-Image 展现出了极高的工程成熟度。官方发布的 Base 与 SFT 权重均采用完全商用友好的 Apache-2.0 协议 开源,并第一时间打通了 Hugging Face Diffusers、Gradio WebUI 以及当下火热的 ComfyUI 节点生态,支持低显存设备通过 LoRA 以及全量参数微调快速构建垂直行业资产。
同时,研发团队也极其坦诚地标明了现阶段的技术边界:MOSS-Image 当前版本定位为纯文生图(Text-to-Image)模型,暂不原生支持垫图参考(Image-to-Image)或局部重绘 Inpainting 功能,且提示增强模块目前依赖外部语言模型辅助推理。但即便如此,其在带字设计图渲染领域的断层领先优势,足以使其成为全球开发者本地部署与商业排版落地的首选标杆。
📝 站长洞察 (Editor’s Insight)
复旦团队开源的 MOSS-Image,吹响了生成式 AI 视觉从‘抽卡玩具’迈向‘工业生产力工具’的关键号角。在过去两年里,AI 绘图虽然在 Midjourney 的引领下展现了惊人的视觉张力,但由于无法解决文字渲染与排版受控的硬伤,平面设计流水线依然严重依赖人工二次修图与排字。MOSS-Image 创造性地将 Qwen3.5 的长文本认知力注入单流 DiT,并首创可编辑 JSON Layout,不仅在技术上跨越了字符边缘与空间拓扑的双重高墙,更为‘Design as Code’的自动化流水线铺平了物理道路。完全合规的 Apache-2.0 开源协议,势必将在海报自动化生成、跨境电商多语言主图以及营销内容工厂等领域引发新一轮降本增效的海啸。
MOSS-Image 主要解决什么问题?
它主要解决文生图在工业级图文混排中的三大痛点:中文乱码、长段落截断、图文元素位置漂移。模型面向海报、漫画对白、UI 排版等场景,强调可控生成与高保真文字渲染。
MOSS-Image 为什么适合长文本排版?
因为它支持最长约 4K Token 超长提示词,并结合 Qwen3.5-9B 文本理解底座,能完整解析多段落文案、版式要求和层级信息,避免传统模型因上下文过短而截断内容。
JSON Layout 在 MOSS-Image 里怎么用?
模型可输出结构化 JSON 布局,包含字号、颜色和 bbox 坐标等信息。开发者可在前端手动调整后再驱动模型局部重绘,实现可编辑、可复现、可版本控制的排版流程。
5B 单流 DiT 为何适合排版?
单流结构把文本、布局和视觉生成放进同一时序建模里,减少多阶段对齐误差;DiT 对长上下文和全局结构更友好,适合同时处理段落层级、图文关系和版式一致性。落地时要配合约束解码,否则容易“整体对了,局部乱了”。
可编辑 JSON Layout 怎么接入工作流?
建议把 JSON 当成中间表示层:先由模型生成结构化布局,再由前端或排版引擎渲染,最后允许人工改字段回写。这样既能保留自动化效率,又能让设计、运营和内容团队按字段级别微调,而不是整张图重做。
🌐 English Executive Summary — MOSS-Image Open-Source: 5B Single-Stream DiT for Long-Text Image-Text Layout
Fudan University and partners open-source MOSS-Image, introducing a first-of-its-kind 5B single-stream DiT architecture for image-text typesetting with editable JSON Layout. The system supports ~4K-token long prompts without truncation and delivers strong layout control and aesthetics, achieving LLTB 96.3, layout mIoU 0.8786, and Elo 1807.34. Built for engineering workflows, it includes positional encoding plus drag-and-drop fine-tuning and local redraw, validated across LLTB, 7Bench, and RealLayoutArena.
- 5B single-stream DiT with editable JSON Layout enables precise, non-truncated long-form image-text typesetting.
- Reported benchmarks: LLTB 96.3, layout mIoU 0.8786, Elo 1807.34, with consistent gains on LLTB/7Bench/RealLayoutArena.
- Practical pipeline features include PE, engineering-friendly drag-and-drop fine-tuning, and local redraw for iterative editing.


