

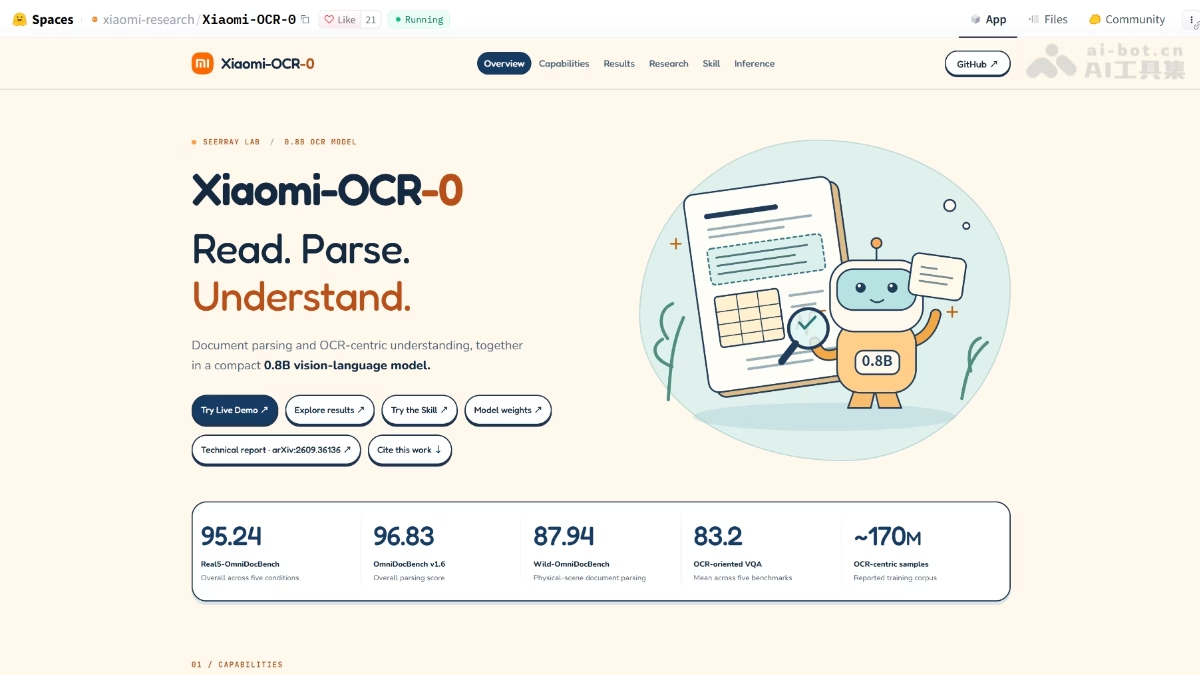
💡 站外导读:传统文档 OCR 长期受制于“级联管道割裂、复杂版式走样、端侧算力吃紧”三大工程死穴。当业界普遍认为高精度文档理解必须堆叠百亿以上超大视觉模型时,小米大模型团队反其道而行之,以数据工程革新突破参数规模桎梏。Xiaomi-OCR-0 凭借 0.8B 极小参数体量,在 Real5-OmniDocBench 斩获 95.24 分夺得全球第一。本文带你全景拆解其异构专家共识标注、渲染反思校验机制以及端侧超级小爱的落地实操。
破除大模型参数迷信:0.8B 端侧轻量底座的降维打击
在多模态大模型狂飙突进的今天,文档解析与图表理解领域却长期面临一个棘手的“工程悖论”:以 GPT-5.2、Qwen3-VL-235B 为代表的通用百亿乃至千亿多模态模型虽然具备出色的泛化能力,但其高昂的算力开销、百毫秒以上的端到端延迟以及隐私合规限制,几乎不可能直接常驻手机、平板等移动终端;而传统的“版面分析 + 规则过滤 + 单行文字识别”级联小模型,在面对折痕、屏幕反光、倾斜拍摄、多列混排与复杂 LaTeX 公式时,往往频现断行与语义割裂。
针对这一行业痛点,小米大模型研发团队正式开源了 Xiaomi-OCR-0。该模型以轻量级的 Qwen3.5-0.8B 作为基座,将文档全页解析、关键信息抽取(KIE)与 OCR 视觉问答(OCR-VQA)三大核心能力深度熔铸于单一自回归网络中,仅用 0.8B 参数就在工业级真实场景评测中实现了对诸多百亿级甚至千亿级视觉大模型的逆袭。
核心算法机制深度剖析:从专家共识到渲染反思自校验
Xiaomi-OCR-0 能够以小博大的核心密码,在于其彻底舍弃了盲目依靠模型参数死记硬背的低效路径,转而构建了一套闭环自净化的“顶级数据工厂”:
1. 异构专家共识标注(ETC,Ensemble Teacher Consensus)
为了从根本上消除单一 OCR 教师模型的固有偏见与幻觉标注,小米设计了由 8 个不同架构、训练数据和推理策略的 OCR 专家组成的委员会。委员会对复杂文档区域进行独立推断,并针对不同模态分别引入严苛的统计评估协议:
- 文本区域:基于归一化编辑距离(Normalized Edit Distance, NED)计算字符相似度;
- 表格区域:基于树状编辑距离算法(Tree-Edit Distance for Structured Data, TEDS)对比单元格嵌套结构;
- 公式区域:基于字符度量矩阵(CDM)评估 LaTeX 表达式拓扑一致性。
系统自动筛选出两两一致性最高的三元组,并取其中间众数作为基准伪标签。只有两两一致度超过 0.90 的高置信样本才被直接收入训练集,从数据源头上筑牢了零噪音防线。
2. 渲染引导双阶段校验(Render-Guided Refine-and-Judge)
对于专家意见出现微小分歧的模糊或复杂版式样本,传统做法要么强行丢弃造成数据浪费,要么人工介入导致成本剧增。Xiaomi-OCR-0 独创了“渲染反思校验”机制:调用 Qwen3.5-122B-A10B 将候选解析出的 Markdown/LaTeX 脚本重新渲染为高分辨率位图,随后在像素级和版式拓扑级与原始输入图像进行差分比对。若发现行对齐偏移、单元格跨度错误或符号丢失,模型会进行最多 3 轮的自迭代修正。对于依旧不收敛的极难长尾样本,则记录完整的校验演进轨迹,进入“诊断—修正—验证”状态机,唯有重新在专家池达成绝对共识才被正式采信。
3. 渐进式三阶段训练流水线
在训练策略上,模型没有采用粗暴的端到端混训,而是遵循认知规律划分为三个清晰阶段:
- Q-Mask 文本空间锚定预训练:在海量图文对中建立字符 Token 与图像 2D 坐标格点之间的细粒度空间几何对齐;
- 多任务全页持续预训练(CPT):统一输入输出格式为自回归序列,在海量真实扫描件、电子文档与翻拍样张上扩展全页阅读顺序、跨层级嵌套识别与区域级定位;
- 难例驱动混合强化学习(Mix-RL):在通过专家分歧挖掘出的重难案例集上,采用 DAPO 风格的端到端可验证奖励机制(Verifiable Rewards),对逻辑推理准确性与版式结构完整性施加梯度惩罚,彻底激发出 0.8B 参数的极限表征潜能。
极限基准实测与工业级竞品全景横评
在权威的多模态文档理解基准测试中,Xiaomi-OCR-0 展现出了令人惊艳的泛化韧性:
| 对比维度 / 评测指标 | Xiaomi-OCR-0 (小米) | TeleOCR (阿里通义) | GPT-5.2 / 工业通用大模型 |
|---|---|---|---|
| 激活参数量 (Parameters) | 0.8B 极轻量 | 1.2B | 数百亿至万亿级 |
| Real5-OmniDocBench (抗畸变真实翻拍) | 95.24 (全球第 1) | 未进前列 | 88.60 ~ 91.20 |
| OmniDocBench v1.6 (综合文档解析) | 96.83 (全球第 2) | 96.87 (全球第 1) | 93.40 |
| 五项 OCR-VQA 复杂视觉推理均分 | 83.2 (同级最高) | 未主打问答能力 | 85.10 |
| 复杂跨行表格解析 (TEDS) | 95.11 | 97.05 | 91.80 |
| 端侧工程生态支持 | MCP + Agent Skill + 手机端 | 标准服务器权重开源 | 商业云端 API 专有调用 |
值得重点关注的是,在涵盖纸张折皱弯曲、屏幕摩尔纹翻拍、高反光阴影、倾斜广角变形及严重低光照五大复杂物理干扰的 Real5-OmniDocBench 基准中,Xiaomi-OCR-0 凭借 95.24 分夺冠,充分印证了其在真实手机手持抓拍环境下的极致鲁棒性。
工程落地生态:原生打通 MCP 协议与手机端超级小爱
区别于以往单纯开源 PyTorch 权重即告结案的学院派项目,小米为 Xiaomi-OCR-0 配备了完整的生产级工具链生态:
- 手机端“超级小爱”深度集成:模型已作为核心视觉基座内置于澎湃 OS(HyperOS)中。用户在浏览微信、短信、外卖及航班应用时,系统可对屏幕上的取件码、核销二维码、登机口、账单明细等关键信息进行毫秒级零延迟提取,并无缝流转至负一屏或系统灵动岛胶囊;
- 标准 Model Context Protocol (MCP) 与 Agent Skill 支持:官方仓库提供了现成的 MCP Server 适配实现。开发者可将 Xiaomi-OCR-0 作为智能体的一个轻量视觉感知工具,在本地搭建“屏幕感知—提取 JSON—自动触发下一步执行”的闭环自动化流水线;
- 高性能推理引擎部署:全面兼容
vLLM与SGLang等现代化推理框架,单张消费级显卡(如 RTX 4060 或 Mac M 系列芯片)即可轻松承载并发请求,显著降低了中小团队搭建私有化文档资产库的算力门槛。
📝 站长洞察 (Editor’s Insight)
在边缘计算与 Personal Agent 概念全面爆发的当下,端侧本地执行正在成为大模型工业化落地的必争之地。小米开源 Xiaomi-OCR-0 的战略意义,在于以铁一般的工业级实测数据验证了“高质量数据飞轮远胜于盲目堆叠模型参数”的工程哲学。通过 8 个异构专家模型多维校验与像素级渲染反思,小米用 1.7 亿条经过严格过滤的纯净样本,硬生生将一个仅 0.8B 的端侧模型推到了比肩数百亿云端闭源模型的水准。更难能可贵的是,小米将其原生接入 MCP 协议与 Agent Skill,打通了从手机屏幕感知到后台自动化决策的完整执行链。这不仅让个人移动终端摆脱了对云端高额 Token API 调用的依赖,杜绝了敏感票据泄露风险,也为全球轻量级垂直大模型的工程实践树立了标杆。


