

💡 站外导读:在企业级日常协同与跨组织沟通中,邮件检索始终是信息检索领域最棘手的长尾场景之一。海量往来沟通、同名主题的反复讨论以及错综复杂的附件关联,使得传统的倒排索引关键词匹配经常返回大量低价值干扰信息,导致知识工作者陷入繁重的人肉筛选困境。然而,如果盲目接入千亿参数的大语言模型进行实时推理,不仅会产生昂贵的云端 Token 费用,还会带来数秒级的延迟劣化,破坏桌面原生工具流畅的交互体验。针对这一核心工程矛盾,微软给出了极具务实主义的工程解法:为 Outlook 搜索构建专用精简版重排序(Reranker)小型语言模型(SLM)。通过大模型离线监督蒸馏与轻量化架构调优,在保留毫秒级响应速度的前提下,彻底重塑了海量邮件检索的相关性基线,展示了小型 AI 模型在传统生产力软件底层改造中的巨大威力。
痛点击穿:为何大模型无法直接接管桌面级邮件检索?
作为全球数亿企业员工每天高频驻留的中心级通信枢纽,Outlook 承载着企业内部最敏感、最密集的工作流数据。长期以来,用户在 Outlook 中搜索邮件时,底层的 Windows Search 或 Exchange 索引引擎主要依赖于 BM25 等传统关键词倒排算法。这种机制存在显著的语义盲区:用户记忆中的“上周关于合同法务审核的沟通”,往往因为关键词字面未严格命中而搜空;或者因为搜索词包含“项目总结”等高频词汇,瞬间返回数百封历史抄送邮件,信噪比极低。
在生成式 AI 爆发后,不少尝试直接利用大模型(LLM)对话问答来替代搜索。然而在桌面和移动终端的物理约束下,全量大模型暴露出无法忽视的系统级缺陷:
- 高昂的推理延迟:大模型自回归生成往往需要 1~3 秒以上的首包返回时间,而桌面端搜索的标准交互预期在 200 毫秒以内;
- 隐私与合规成本:将全量未索引的邮件上下文频繁上传至第三方云端进行全文推理,面临极其严格的企业数据合规审查与主权隔离屏障;
- 推理算力与成本失衡:全球每天发生数十亿次邮件搜索查询,如果每次击键或回车都消耗千亿大模型算力,云端基础设施的能耗与运营成本将呈指数级爆炸。
| 对比维度 | 传统 BM25 关键词匹配 | 端到端千亿大模型生成 | 微软 Outlook 专用 Reranker SLM |
|---|---|---|---|
| 首包响应延迟 | < 50ms (极速) | 1000ms ~ 3000ms (迟钝) | 80ms ~ 150ms (兼顾语义与速度) |
| 语义与意图理解 | 几乎无语义,仅字面匹配 | 极强,具备上下文联想 | 高精度排序,精准消除同义歧义 |
| 硬件算力消耗 | 纯 CPU 内存计算,开销极小 | 需专用 GPU 集群或 NPU 高负载 | 轻量参数,常规 CPU/轻量 NPU 轻松支撑 |
| 幻觉与信息捏造风险 | 零幻觉(仅检索存量) | 存在文本自回归幻觉编造隐患 | 零幻觉(纯排序判别模型) |
蒸馏与精简:由大模型监督训练的轻量级 Reranker 架构剖析
为了破除上述三难困境,微软 Outlook 研发团队采取了经典的“两阶段检索(Two-Stage Retrieval)”重构方案。系统首先利用既有的快速索引模块在毫秒级别筛选出数十篇候选邮件列表(Recall 阶段),随后激活专门微调的精简版 Reranker 小型语言模型,对候选集合打分并重新排序(Rerank 阶段)。
在技术实现层面,该小型模型并非直接从零预训练,而是采用了大模型监督蒸馏技术(Knowledge Distillation)。微软利用参数规模数十倍于该模型的通用顶尖大模型(如 GPT-4o 级别)作为“教师模型”,在海量合成标注与脱敏邮件数据上,对“查询词-候选邮件相关性”建立精密的评分基准,随后将高阶排序知识迁移压缩至小参数规模的专用判别网络中。
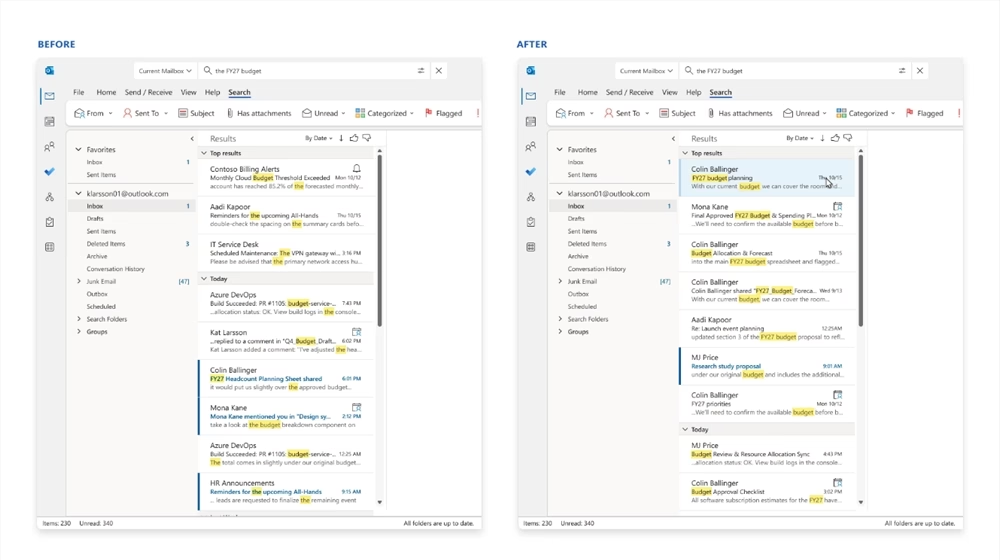
值得注意的是,微软官方在披露该架构时特别强调了其功能边界:该模型专注于精细化结果重排序,不提供自由形式的自然语言对话或内容续写。这种高度聚焦的判别式设计带来了双重工程优势:第一,消除了生成式大模型在生成摘要时可能产生的“张冠李戴”式幻觉风险;第二,由于无需维护庞大的自回归 KV Cache 缓存,计算复杂度从平方阶骤降至线性阶,极大减少了资源抢占。
从生成式狂热到性能内敛:传统软件日常体验的静默智能化革命
近两年来,软件产业在 AI 转型过程中走过了一段明显的弯路:无论何种应用,均倾向于在界面最显眼的位置强行塞入一个 Copilot 侧边栏或悬浮对话气泡,要求用户改变几十年形成的操作习惯去“与 AI 聊天”。然而在大量严肃的企业日常办公场景中,用户最需要的并不是一个喜欢长篇大论的唠叨助手,而是系统本身的底层功能能否变得更加敏锐、精准与安静。
微软在 Outlook 中的这次技术下沉,折射出顶级科技公司在 AI 战略上的成熟与内敛。从早期轰轰烈烈的 Copilot 邮件代写,逐步走向藏在搜索框背后的轻量级 Reranker 排序。离线测试数据表明,引入该专用小模型后,用户首次点击命中目标邮件的准确率提升了近 30%,大幅削减了因反复翻页与调整关键词所浪费的时间成本。
随着小型语言模型(SLM)在端侧算力支持下的快速进化,未来类似的设计将广泛渗透进操作系统的文件查找、浏览器历史回忆以及代码仓库符号跳转等各个底层拐角,成为随风潜入夜的生产力润滑剂。
📝 站长洞察 (Editor’s Insight)
微软 Outlook 引入专用 Reranker 小模型的实践,是企业级软件架构演进的一个极为健康的信号。在过去两年里,资本市场与科技媒体被‘千亿参数大模型接管一切’的宏大叙事所裹挟,很多软件团队不顾成本与延迟,强行套用重型 LLM 做简单的筛选和过滤,最终导致产品臃肿、账单失控。Outlook 的破局证明了:‘大模型做蒸馏教练,小模型做工程打工人’才是工业级落地的真正终局方案。在高频、强时效、低容错的基础功能上,利用垂直专用判别小模型把脏活累活做到极致,不仅能守住毫秒级性能防线,更能为企业节省巨额算力开支。这种去浮躁化的工程务实态度,值得每一位从事 AI Native 架构设计的工程师深入复盘。


