

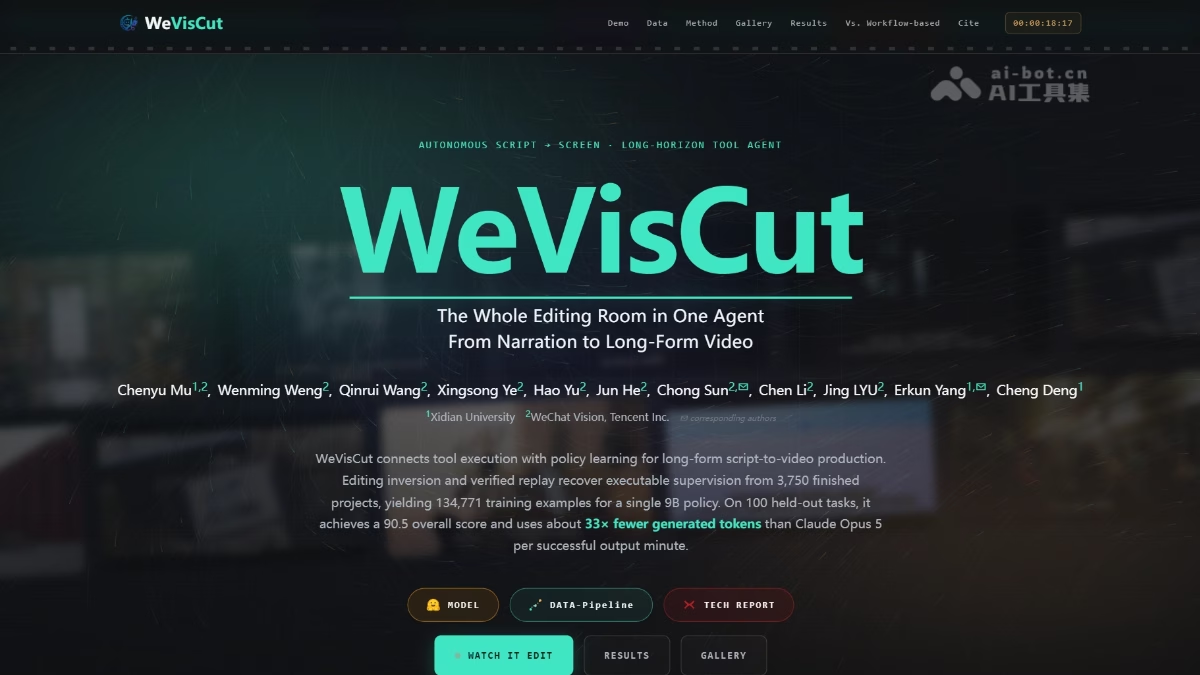
💡 站外导读:长视频(长达数分钟)的自动化剪辑与合成一直是多模态智能体领域的深水区:传统流水线方案因跨阶段频繁序列化上下文,导致 Token 消耗随分镜数呈指数级膨胀,且局部错误难以回滚修复。腾讯微信视觉团队近日重磅开源长视频剪辑智能体 WeVisCut,以惊人的架构创新彻底打破僵局:仅凭一个 9B 参数的轻量策略模型,通过独创的状态化 Harness 运行时与三角色合一机制,不仅在剪辑质量上力压多阶段流水线并比肩 Claude Opus 5,更将 Token 消耗狂降 33 倍、单分钟成片成本击穿至 0.09 美元。本文全景拆解其底层论文架构与工程落地细节。
一、 长视频智能体困境:为什么多阶段工作流会沦为“算力黑洞”?
在视频内容生产中,将一段几千字的旁白或知识性脚本转化为数分钟的高质量视频,是一个涵盖分章、分镜拆解、音画同步、多源素材检索、复杂转场合成以及全片质检的极其漫长且高度耦合的生产链条。在传统的多智能体(Multi-Agent)方案中,行业普遍采用“阶段流水线架构”:
[剧本 Agent] ➔ [分镜 Agent] ➔ [检索 Agent] ➔ [合成 Agent] ➔ [质检 Agent]这种粗暴切分在面对长视频时面临着致命的物理瓶颈:
- 上下文序列化膨胀:每个阶段为了做出正确决策,必须反序列化前面所有阶段产生的镜头、时间线与素材元数据。随着成片长度增加,单次请求携带的上下文呈二次方膨胀,Token 账单直接失控;
- 节奏割裂与局部优化陷阱:每个镜头的孤立匹配是正确的,但整片连贯起来却节奏死板、风格漂移;
- 雪崩式重试成本:一旦质检阶段发现第 12 个镜头音画不同步或素材版权违规,由于缺乏局部隔离,往往需要整条流水线推倒重跑,造成巨大的算力浪费。
二、 核心架构突破:状态化 Harness 与单一策略三角色路由
为了从根本上击穿这一工程瓶颈,微信视觉团队抛弃了冗余的多 Agent 堆砌,提出了“极简单一策略(Single Policy)+ 强状态宿主(Stateful Harness)”的优雅架构:
1. 状态化生产运行时(Stateful Production Harness)
系统在内存中维护一份强类型、持久化的全局生产状态(Production State)。Harness 严格扮演“安全看门狗”角色:模型对时间线、轨道或素材的任何修改,都必须通过固定包含 12 项原子能力的工具注册表执行,且只有经过静态类型校验与合法性回放的动作,才会被写入状态机。模型自身无需在 Prompt 中反反复复背负历史会话,实现“模型推理无状态、生产环境强状态”的极致解耦。
2. 9B 策略模型分饰三角:编排者、生成者与批评者
WeVisCut 并没有针对不同阶段使用多个模型,而是由一个经过严密蒸馏微调的 9B 小参数模型,通过动态系统角色路由(Role Routing)一人分饰三角:
- 编排者(Planner):拆解全局节奏,生成时间线骨架与分镜时序约束;
- 生成者(Actor):基于当前状态执行精准的素材检索、语音合成与轨道对齐;
- 批评者(Critic):在渲染前快速审查视觉语义重叠度、字幕截断与音画节拍。
3. 闭环质检与有界局部自愈(Bounded Local Recovery)
当批评者或运行时检测到渲染异常时,WeVisCut 不会触发全局重算,而是启动局部有界自愈机制。策略模型仅针对出现冲突的特定轨道或分镜区间重新下达修正指令,已渲染确认成功的镜头被完全保留并固化,彻底避免重复劳作。
三、 数据反演管线:Editing Inversion 与 13.4 万条实战轨迹构建
训练一个 9B 模型具备如此老练的剪辑水准与自愈能力,其核心在于高质量的训练数据。但成片往往只展示最终视觉结果,无法直接展现剪辑师的中间试错与决策意图。作者首创了 Editing Inversion(编辑反演)+ Verified Replay(验证回放) 四阶段数据合成管线:
- 意图逆向推导:从 3,750 部高分成熟短片中反向推导剧本脚本与分镜剪辑逻辑;
- 运行时可执行重放:在 Studio 真实沙箱环境中尝试逐步执行并物化工具链;
- 主动缺陷注入与有界修复:在重放过程中人工或算法注入失败(如素材缺失、字幕溢出),迫使反演策略学会定位并执行局部修复;
- 高质量轨迹物化:最终成功提炼出 134,771 条带有真实工具反馈与纠错闭环的可执行监督数据。
在经过 SFT、引导式在线策略蒸馏(Guided-OPD)以及相对偏好强化学习(RCF-DAPO)三阶段渐进训练后,模型在长程任务的五维综合得分从基座的 74.5 飙升至 90.5。
四、 性能基准与工业级实测:WeVisCut vs 主流方案深度对比
在由 100 项涵盖科技科普、财经分析、历史讲解等真实长视频剪辑任务的基准盲测中,WeVisCut 展现出了震撼性的断层优势:
| 对比指标 | WeVisCut(微信视觉 9B 单策略) | Crayotter(工业级工作流系统) | Claude Opus 5(巨型多阶段方案) |
|---|---|---|---|
| 系统架构与参数 | 单一 9B 参数策略 + 状态化 Harness | 任务匹配的传统硬编码流程 | 数百亿闭源超大模型 + 多级 Agent 阶段 |
| 每分钟成片生成 Token | 仅需 2,377 Token(节省 33 倍) | 无对应 Token 指标(规则驱动) | 约 78,500+ Token(多次全量上下文序列化) |
| 每分钟成片成本 | $0.09(约合人民币 0.65 元) | $0.97 | $3.20+ |
| 成片耗时(Wall-clock) | 2.1 分钟 / 每输出分钟(提速 4.1 倍) | 8.6 分钟 / 每输出分钟 | 12.4 分钟 / 每输出分钟 |
| 脚本保真度(SCF) | 88.4 分 | 81.6 分 | 87.9 分 |
| 全片综合完成度 Overall | 90.5 分 | 84.9 分 | 89.8 分 |
| 开源协议与部署自由度 | Apache-2.0 全量开源(权重/代码/沙箱) | 商业封闭 | API 调用,受限于速率与云端审计 |
五、 部署与生产实操:8 轨时间线与导演对话式改片
WeVisCut 官方不仅开源了 9B 权重,更直接交付了具备工业级可用性的 Studio 交互式运行时:
- 8 轨并行可视化:支持主视轨、画中画轨、特效层、主音轨、环境音效轨与字幕轨的多层级独立视听对齐;
- 导演对话式改片(Director Chat):首轮成片交付后,创作者无需进入复杂剪辑软件逐帧剪断,只需在侧边栏像与剪辑师沟通一样下达修改指令:“第 3 分钟讲解芯片架构的地方,把背景音乐换得更有科技感,并把配图替换为晶圆微距切面”,模型便会自主定位目标区间并精准局部重渲染;
- 全链路私有化:9B 模型单卡消费级 GPU(如 RTX 4090)即可轻松拉起完整推理沙箱,极大保护了企业未公开视频内容资产的安全。
📝 站长洞察 (Editor’s Insight)
腾讯微信视觉团队在 WeVisCut 上的技术突破,给当下行业严重浮躁的“多智能体(Multi-Agent)大干快上”风气当头泼了一盆冷静的凉水。许多技术团队在缺乏深度状态治理能力的前提下,为了看起来高大上,动辄拼凑由七八个通用超大模型构成的松散流水线,结果往往导致通信延迟爆炸、Token 账单失控,且局部微小幻觉层层累加演变为不可挽回的灾难。WeVisCut 雄辩地证明:“小参数专精策略 + 强类型状态持久化 Harness”才是多模态 Agent 走向商业落地与成本收敛的唯一正确答案。将系统状态完整下沉给宿主运行时,让模型只专注于最精炼的单步合法决策与局部自愈,不仅将工业级长视频制作成本降到了常人难以想象的每分钟不到 1 毛钱,更为下一代端侧具身智能与长程自治系统的系统架构开辟了崭新道路。


