

💡 站外导读:在云端 GPU 算力租金居高不下、核心代码与商业机密上传云端大模型面临严重数据合规风险的背景下,苹果全资子公司 Claris 正低调探索一条极具颠覆性的端侧私有算力路径。据开发者逆向披露,Claris 正在内测一款名为 Harbor 的革命性本地 AI 运行底座。该工具不仅能让单台搭载 M 系列芯片的 Mac 瞬间化身高性能本地 AI 推理服务器,更能通过物理雷雳 5(Thunderbolt 5)高速线缆,借助最新系统底层的 RDMA(远程直接内存访问)技术,将办公室内多台闲置 Mac 串联成高带宽、统一显存池的分布式 AI 计算集群,为中小企业与极客开发者推开了本地运行数百亿乃至上千亿参数大模型的新大门。
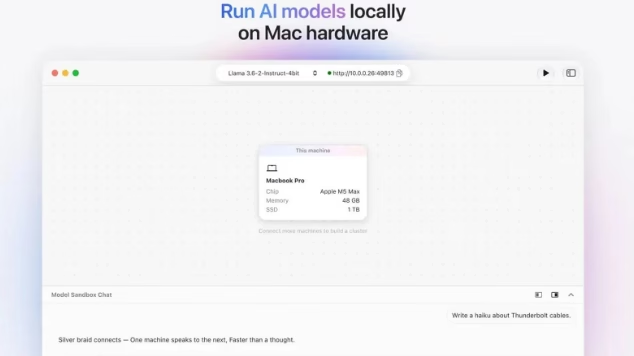
一、打破单机统一内存天花板:苹果为什么让 Claris 押注本地算力集群?
众所周知,苹果 Mac 产品线自全面切换至自研 Apple Silicon(M 系列芯片)以来,其独步业界的统一内存架构(Unified Memory Architecture, UMA)让配备 64GB、128GB 乃至 192GB 内存的高配机型成为了运行大语言模型(LLM)的绝佳利器——其内存既是 CPU 运行内存,也是 GPU 的高带宽显存,避免了传统 PC 显卡显存容易见顶(OOM)的致命软肋。
然而,对于想要在本地完整加载 DeepSeek 67B、Llama 70B 乃至千亿级稠密参数模型的研发团队而言,购买顶配 Mac Studio 或 Mac Pro 的一次性硬件投入依然不菲;而团队工位上往往散落着多台 M2/M3/M4 系列的 MacBook Pro 或 Mac mini。Claris 开发 Harbor 的终极目的,正是要打破硬件单体孤岛,将这些原本分散、闲置的端侧硬件,在局域网内通过超高速物理总线熔铸为一个按需扩展的私有算力资源池。
二、核心黑科技解密:macOS Tahoe 26.2 雷雳 5 RDMA 底层跨机内存互通
将多台电脑连成集群运行分布式大模型并非新鲜概念,但过去基于以太网(TCP/IP)的网络通信往往伴随着极高的封包协议开销与毫秒级通信延迟,在进行矩阵张量并行(Tensor Parallelism)计算时,网络往往成为最严重的计算瓶颈。Harbor 之所以能够取得工业级突破,核心在于其深度激活了 macOS Tahoe 26.2 底层的全新硬核特性:
- 雷雳 5 高达 120Gbps 的单向物理带宽:借助雷雳 5 的超宽传输物理通道,跨设备数据吞吐量相较传统千兆以太网提升了两个数量级,直接媲美工业级服务器背板总线;
- Thunderbolt RDMA(远程直接内存访问):这是 Harbor 最关键的技术底层。RDMA 允许 A 设备的 Neural Engine / GPU 直接绕过 CPU 与操作系统内核,对 B 设备的统一内存空间进行纳秒级直接读写,从物理架构层面彻底消除了数据跨机搬运时的内存重复拷贝开销;
- 自适应层级模型切片(Pipeline & Tensor Slicing):Harbor 底层调度器会自动嗅探集群内各节点的芯片规格与可用内存容量,智能将超大模型的不同 Transformer 模块流水线式分发至不同节点,实现“多芯如一芯”的协同推理。
三、应用形态与极客工作流:自动拓扑发现与开放权重模型一键拉取
尽管底层涉及极其复杂的分布式并行计算与驱动交互,Harbor 在用户体验层却延续了苹果生态一贯的极简哲学:
| 指标与考量维度 | Harbor + Mac 雷雳 5 集群 | 云端 GPU 租赁 (如 AWS/RunPod) | 自建消费级双卡/四卡 PC 塔式机 |
|---|---|---|---|
| 数据安全与合规边界 | 100% 局域网物理物理隔离,零外泄风险 | 数据必须上传远端,面临合规与审查风险 | 本地内网隔离,具备高度私密性 |
| 长期算力边际成本 | 利用存量办公电脑,硬件与电费成本极低 | 按小时/Token 持续计费,长跑成本极其高昂 | 初始购机昂贵,满载功耗 1500W+ 电费明显 |
| 部署与运维复杂度 | GUI 拓扑自识别,插线即用、一键拉取 | 需要配置 VPC、SSH 密钥与防火墙安全组 | Linux 驱动、CUDA 版本与水冷维护极其折腾 |
| 运行噪声与办公环境 | 超静音运行,适合放在桌面与开放式工位 | 机房托管无需考虑噪声,但受公网带宽制约 | 风扇暴力狂转,噪音严重影响办公沟通 |
工程师只需用雷雳 5 数据线将两台或多台 Mac 物理互联,启动 Harbor 应用后,软件便能自动完成对等节点握手并计算总可用统一显存容量。应用内置了经过量化适配的主流开放权重开源模型目录(覆盖 DeepSeek、Llama、Qwen 等前沿模型),用户轻点下载即可在本地直接拉起媲美云端体验的 OpenAI 兼容 API 端点。
四、从边缘计算到私有 AI 网格:苹果对企业级端侧智能的长远算盘
虽然 Harbor 目前尚处于极早期受限测试阶段(此前曾短暂现身 Mac App Store 后迅速下线),但这一动作释放出的战略信号极度深远。长久以来,苹果在生成式 AI 领域被外界贴上“依赖外部模型服务”的被动标签;然而,Harbor 的曝光证明,苹果正凭借其在硬件芯片、统一内存带宽与操作系统驱动级的垂直整合优势,暗度陈仓地构筑起一套“去中心化本地私有 AI 计算网络”。
对于律所、金融投研、医疗健康以及硬核软件研发等对数据隐私具备严苛合规要求的高价值行业,Harbor 展现出极其诱人的应用前景:企业无需花费数十万美元采购喧闹笨重的数据中心机柜,只需将会议室或研发工位的 Mac 设备插上雷雳线,即可在断网状态下拥有一座安全、可控、零泄密隐患的专属 AI 智算中心。
📝 站长洞察 (Editor’s Insight)
Claris Harbor 的研发动向,揭示了端侧 AI 演进的一条截然不同却极具生命力的技术路线:大模型推理不一定非要被束缚在耗电数十兆瓦的云端巨型算力中心里。苹果凭借其在 M 系列芯片上多年积累的统一内存架构与雷雳 5 RDMA 驱动优势,正在以极其优雅的极客方式,将单机消费级电子产品升维为可弹性横向扩展的微型分布式超算集群。一旦该技术成熟并随后续 macOS 稳定版全量普及,不仅将盘活全球数千万台存量 Mac 的沉睡算力,更将对当前高溢价的云端 API 商业模式发起一次极具杀伤力的降维打击。


