

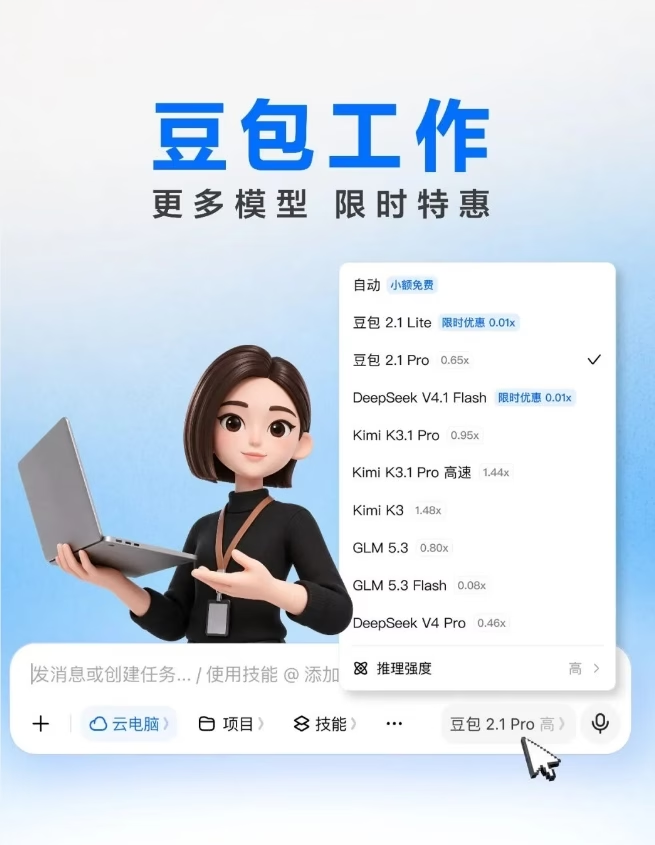
💡 站外导读:在过去两年的生成式人工智能落地潮中,主流大厂推出的协同办公 Agent 往往充当着自家大模型的封闭护城河——无论用户面对的是简单的会议纪要整理,还是深度的长程代码重构,系统底座均被死死锁定在自研单一模型上。然而,随着不同大模型在垂直领域的推理性价比、长上下文召回以及数学逻辑表现上呈现出结构性差异,“强推自研全家桶”正在引发企业对算力浪费与任务瓶颈的强烈焦虑。字节跳动旗下“豆包工作”在此次版本升级中做出了极具魄力的解绑举措:在保留自研豆包 2.1 Lite/Pro 的同时,全面引入 Kimi K3.1Pro、GLM5.3 和 DeepSeek V4.1Flash,并率先在前端呈现“额度消耗倍率”系统,让多模型分层路由与精细化成本控制第一次真正进入主流白领的工作流视野。
一、打碎自研单模型茧房:AI 办公从“封闭绑定”迈向“多元生态聚合”
长期以来,无论海外微软 Copilot 对 OpenAI 模型的独家依赖,还是国内各大云厂商围绕自有模型构建的办公套件,“模型即产品、产品即模型”的垂直一体化策略一直占据着主导地位。这一模式虽然有利于厂商构建闭环数据飞轮与技术壁垒,但却忽视了实际企业办公场景的异构复杂性:在真实的日常业务流程中,没有任何一款通用大模型能够在响应速度、长文本理解、代码生成质量以及每百万 Token 综合成本这四个维度上同时达成全局最优。
字节跳动旗下 豆包工作 的最新升级直接撕开了这层伪装。作为一款主打“自主任务规划、跨应用工具调用与长流程交付”的生产力 Agent,豆包工作此前依托自研的豆包 2.1 架构。而在此次迭代中,系统彻底解除了单一引擎限制,正式吸纳了外部最具代表性的三大旗舰级大模型:
- 月之暗面 Kimi K3.1Pro:凭借 2.8 万亿级参数与卓越的长程上下文保持能力,专攻百页合同审计、海量行业研报穿透与复杂文档多轮因果梳理;
- 智谱 AI GLM5.3:具备成熟的工具调用(Function Calling)与系统级推理能力,在企业结构化数据查询与自动化脚本编排中表现稳健;
- DeepSeek V4.1Flash:继承了高并发、极低推理延迟与高性价比的基因,在日常邮件撰写、文本润色与高频对话交互中展现出极佳的吞吐表现。
这一举措标志着国内主流企业级 Agent 平台开始承认:“Agent 是任务的编排者与执行者,而底层模型不过是按需采购的水电基础设施。” 平台核心竞争力的重心,已经从“我拥有多么强大的单一模型”演变为“我能否在恰当的时机以最低的成本调度最合适的模型”。
二、首创“额度消耗倍率”选择器:将黑盒算力转化为精准 ROI 决策
在企业引入生成式 AI 的落地过程中,最大的“暗礁”往往不是算法效果,而是不可预测的 Token 资费支出。由于不同模型参数规模与 API 计费标准千差万别,普通员工在面对“模型下拉菜单”时往往无所适从——出于本能,多数人倾向于无脑选择顶配的 Pro 级模型,直接导致企业的算力配额在处理低价值任务时被迅速蚕食殆尽。
为解决这一痛点,豆包工作在交互界面上推出了创新的“额度消耗倍率系数(Consumption Multiplier)”机制:
系统将企业账户中的统一点数作为标准锚定物,根据底层模型的真实推理开销,为每一个可选模型动态标定消耗系数(例如,轻量级模型系数设为 0.5x~1.0x,旗舰级高推理模型设为 3.0x~5.0x)。系数越低,完成单次任务所扣除的额度越少。通过这一设计,以往抽象晦涩的 Prompt Token / Completion Token 概念被彻底降维为员工一看即懂的直观成本信号。
更进一步,豆包工作还配合上线了时段动态调控与分级特惠计划:在工作日低谷时段及节假日,平台针对豆包 2.1 Lite 和 DeepSeek V4.1Flash 实行进一步的费率下调与折扣倾斜,驱动用户将高频、批量、耗时长的离线数据清洗任务自动迁移至低成本时段运行,从而在系统层面上构建起了类似现代云计算负载均衡的“算力错峰调度”体系。
三、核心模型在 Agent 办公工作流中的实测性能与选型矩阵
为了让不同岗位角色的企业用户能够依据任务特征精准选型,我们对豆包工作首批支持的核心自研与第三方大模型进行了系统化的技术解构与横向评测:
| 模型名称 | 架构属性 | 平台计费倍率 | 典型优势办公场景 | 平均首字延迟 | 任务推荐指数 |
|---|---|---|---|---|---|
| 豆包 2.1 Lite | 自研轻量级 MoE | 0.5x(基础超省) | 会议纪要速记、短文草拟、简单格式转化 | < 350ms | ★★★★★(日常标配) |
| 豆包 2.1 Pro | 自研通用旗舰 | 1.8x(均衡稳健) | 飞书/办公全生态工具调度、跨应用流程协同 | ~ 680ms | ★★★★☆(办公通吃) |
| DeepSeek V4.1 Flash | 第三方开源蒸馏 | 0.8x(高性价吞吐) | 代码局部重构、多语言文档快翻、高频检索 | < 420ms | ★★★★★(极客首选) |
| Kimi K3.1 Pro | 第三方超大参数 MoE | 3.2x(重型推理) | 50万字以上长文档穿透、合同风险交叉对比 | ~ 1100ms | ★★★★☆(长文核武) |
| 智谱 GLM 5.3 | 第三方多任务基座 | 2.2x(逻辑严密) | 深度行业分析拆解、多步骤指令规划、合规审查 | ~ 850ms | ★★★★☆(分析专员) |
四、从单打独斗到超级枢纽:AI 办公 Agent 商业模式的终局演进
豆包工作的这一转变,实际上折射出整个 AI Agent 软件工程在架构设计理念上的深刻成熟:
第一,同一工作流内“按步骤切分模型”成为工程现实。 在复杂的长程任务中,Agent 可以先调用低成本的 DeepSeek 或豆包 Lite 模型进行前置的意图解析与原始网络信息检索过滤;待整理出结构化框架后,再将关键逻辑与上下文交付给高倍率的 Kimi K3.1Pro 执行精细化的跨文档推理;最后由自研模型编排结果并直接渲染至飞书文档或无限画布中。这种“混合流水线”相比全程使用单一昂贵模型,能够帮助企业在维持最终成果质量不变的同时,压降多达 60% 至 75% 的整体算力消耗。
第二,平台定位从“技术展示橱窗”演进为“算力交易与应用枢纽”。 当大厂不再执着于强迫用户只用自家模型,而是将选择权与透明定价机制归还给用户,它反而能够牢牢占据用户的“工作台桌面入口”。正如 Windows 操作系统不会限制用户只能运行微软自研的办公软件一样,未来的 AI 办公超级入口,必然是能够海纳百川、高效路由全球顶尖模型能力的统一操作系统。
📝 站长洞察 (Editor’s Insight)
从 SRE 架构与企业级算力治理的冷酷视角审视,豆包工作此次接入 Kimi、智谱与 DeepSeek 绝非单纯的产品功能更新,而是一次极具战略野心的“降维打击”。对于大模型企业而言,最容易陷入的战略误区就是“自嗨式地把所有场景都当成验证自研模型刷榜的舞台”。然而对于真实买单的 B 端企业 CTO 与财务部门来说,他们从不在意底层到底是哪家模型在跑,他们在乎的是单位产出成本、任务交付成功率以及避免被单一供应商锁死(Vendor Lock-in)的系统弹性。字节跳动选择在自家核心的 Agent 办公产品中主动公开模型调用倍率,本质上是在用“算力证券化与透明计量”建立起行业事实标准。一旦用户习惯了在同一个工作台内依据性价比自由切换模型,那些依然坚持封闭自研单一底座、计费黑盒且缺乏灵活调度能力的办公工具,将在极短的时间内被市场用脚投票彻底淘汰。
豆包工作为什么要接入多个大模型?
因为不同模型在长文本理解、推理性价比、工具调用和响应速度上各有优势。豆包工作通过接入Kimi、GLM和DeepSeek,把模型能力按任务拆分,避免所有场景都强行使用单一自研模型造成成本浪费或效果瓶颈。
“额度消耗倍率”是什么意思?
它是把不同模型的实际推理成本换算成统一的倍率系数,员工能直观看到一次任务会消耗多少额度。这样比直接看Token更容易选型,也能引导低价值任务优先用低倍率模型,提升企业ROI。
长文档和日常办公分别该选哪个模型?
日常会议纪要、短文草拟和高频对话更适合豆包2.1 Lite或DeepSeek V4.1 Flash;50万字以上长文档穿透、合同审计和复杂推理更适合Kimi K3.1 Pro;深度分析、合规审查可优先考虑GLM 5.3。
如何按任务类型配置模型路由?
先把任务拆成检索、改写、长文总结、复杂推理四类,再按延迟、上下文长度和单次成本设默认模型。高频轻任务走低价快模型,长文与推理再切高能力模型,并保留人工一键升级入口。
倍率选择器怎样避免成本失控?
把倍率当预算闸门而不是自由放大器:为每个工作流设上限、为高倍率操作加二次确认、记录每次调用的token与结果质量。定期回看“单位产出成本”,把低效链路直接降级或合并。


