

💡 站外导读:伴随大模型长程自主任务(Agentic Workflows)在工业级复杂系统中的广泛铺开,开发者们正集体遭遇一场由“上下文窗口膨胀(Context Bloat)”引发的系统性危机:盲目暴力检索导致数十万 Token 瞬间吞噬显存,海量过时或无关的噪音上下文在会话中持续发酵并引发级联幻觉。对此,LangChain 官方工程团队发表重磅技术长文,系统性定调了面向生产级智能体的上下文工程(Context Engineering)全新工程范式。文章指出,构建具备稳健长期记忆的智能体绝非盲目扩容上下文窗口,而必须从源头重构检索范式。本文深度拆解基于 Deep Agents 运行时的“文件系统前置过滤”、“大结果集指针卸载”以及“检索-卸载-委托(Retrieve, Offload, Delegate)”全栈架构。
一、智能体的“开卷考试困境”:上下文膨胀引发的三大系统性故障
LangChain 在长文中形象地指出:赋予大模型一个超大上下文窗口并塞入全部可能资料,就如同让一个考生参加一场无限资料的开卷考试——理论上所有答案都在手中,但浩瀚无序的信息反而让人无法在规定时间内找到正确答案。在长程智能体执行过程中,信息检索往往在三个致命维度上发生崩溃:
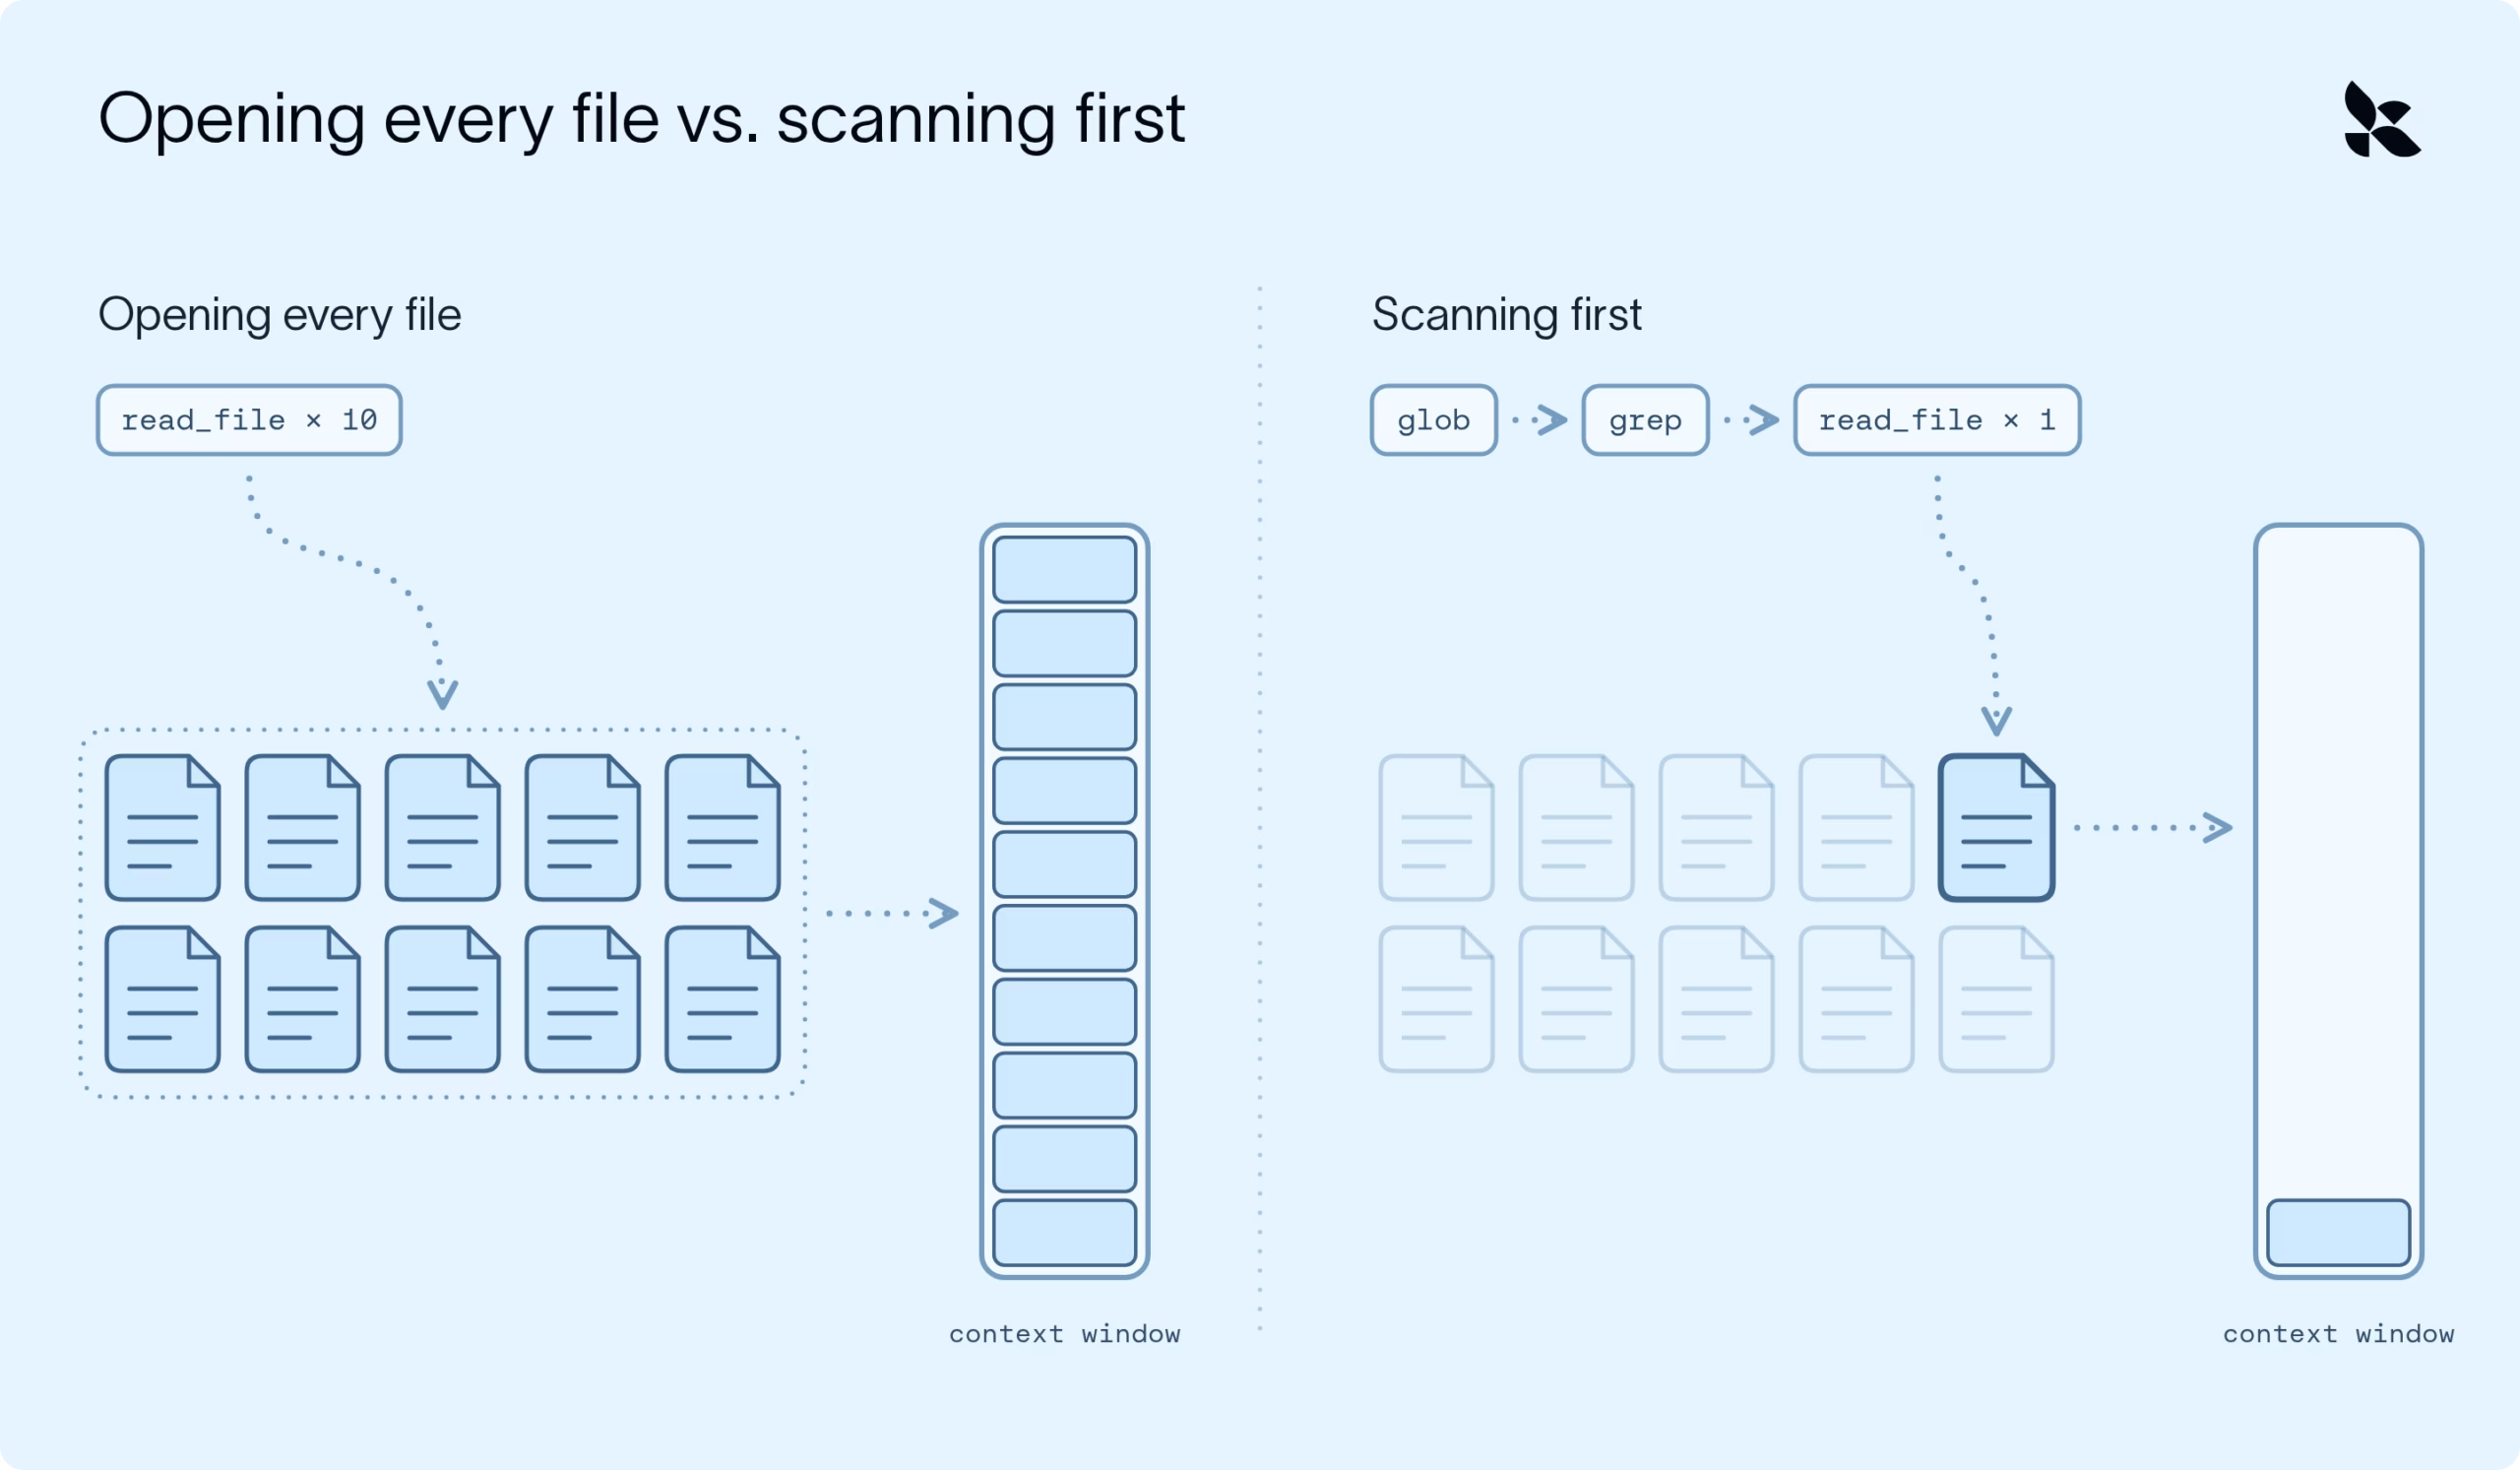
- 低效且重复的盲目搜索(Inefficient Searching):智能体如果缺乏确定性的检索指引,往往会陷入“反复尝试打开所有文件看一遍”或“不断微调提示词反复搜索”的低效自旋中。在真正编写出一行业务结论之前,整个上下文窗口就已经被连篇累牍的无效搜索日志填满。
- 单次检索结果瞬间打爆上下文(Too Much Context at Once):例如在分析市场财报时,智能体只需要某家公司的一个季度营收数字,但如果底层工具直接将包含 4 万行交易记录的完整数据导出表倾泻入上下文,单次工具调用即可导致上下文彻底见顶,丧失后续推理能力。
- 陈旧与无关上下文引发级联幻觉(Irrelevant or Stale Context):过时或偏差的非相关文本对大模型而言具有与真理同等的诱惑力。一旦脏数据被加载进上下文,智能体便会在此基础上进行多轮推演,导致错误如同滚雪球般在后续每个决策步中扩散。
二、架构级防御第一步:文件系统原语与确定性工具前置扫描
为破解低效搜索,LangChain 的 Deep Agents 基础设施在默认运行时中强制内置了一套轻量级操作系统文件工具集,遵循“先扫描索引、再按需读取(Scan Before Read)”的核心铁律:
正如人类在查阅百科全书时会先看目录与索引页一样,智能体在探查文件系统时严禁直接调用 read_file 暴力通读。相反,Deep Agents 提供了两级确定性轻量工具:
glob命名模式过滤:支持通过通配符(如**/company-a*.md)秒级筛选候选文件路径,在零 Token 文本加载消耗的前提下精准锁定目标文件集合。grep物理行过滤:直接在底层存储端执行字面量文本匹配,仅向智能体返回匹配的文件路径列表、匹配行文本或出现频次。智能体无需将几万字的文件载入内存,即可确认关键线索是否存在。- 分段分页读取(Paginated Read):即使必须读取文件,内置的
read_file也强制采用分页机制(默认每次 100 行),支持指定行偏移量(offset)与读取上限(limit),实现外科手术式的高精度提取。
三、“检索-卸载-委托”范式:通过文件指针与子 Agent 隔离上下文污染
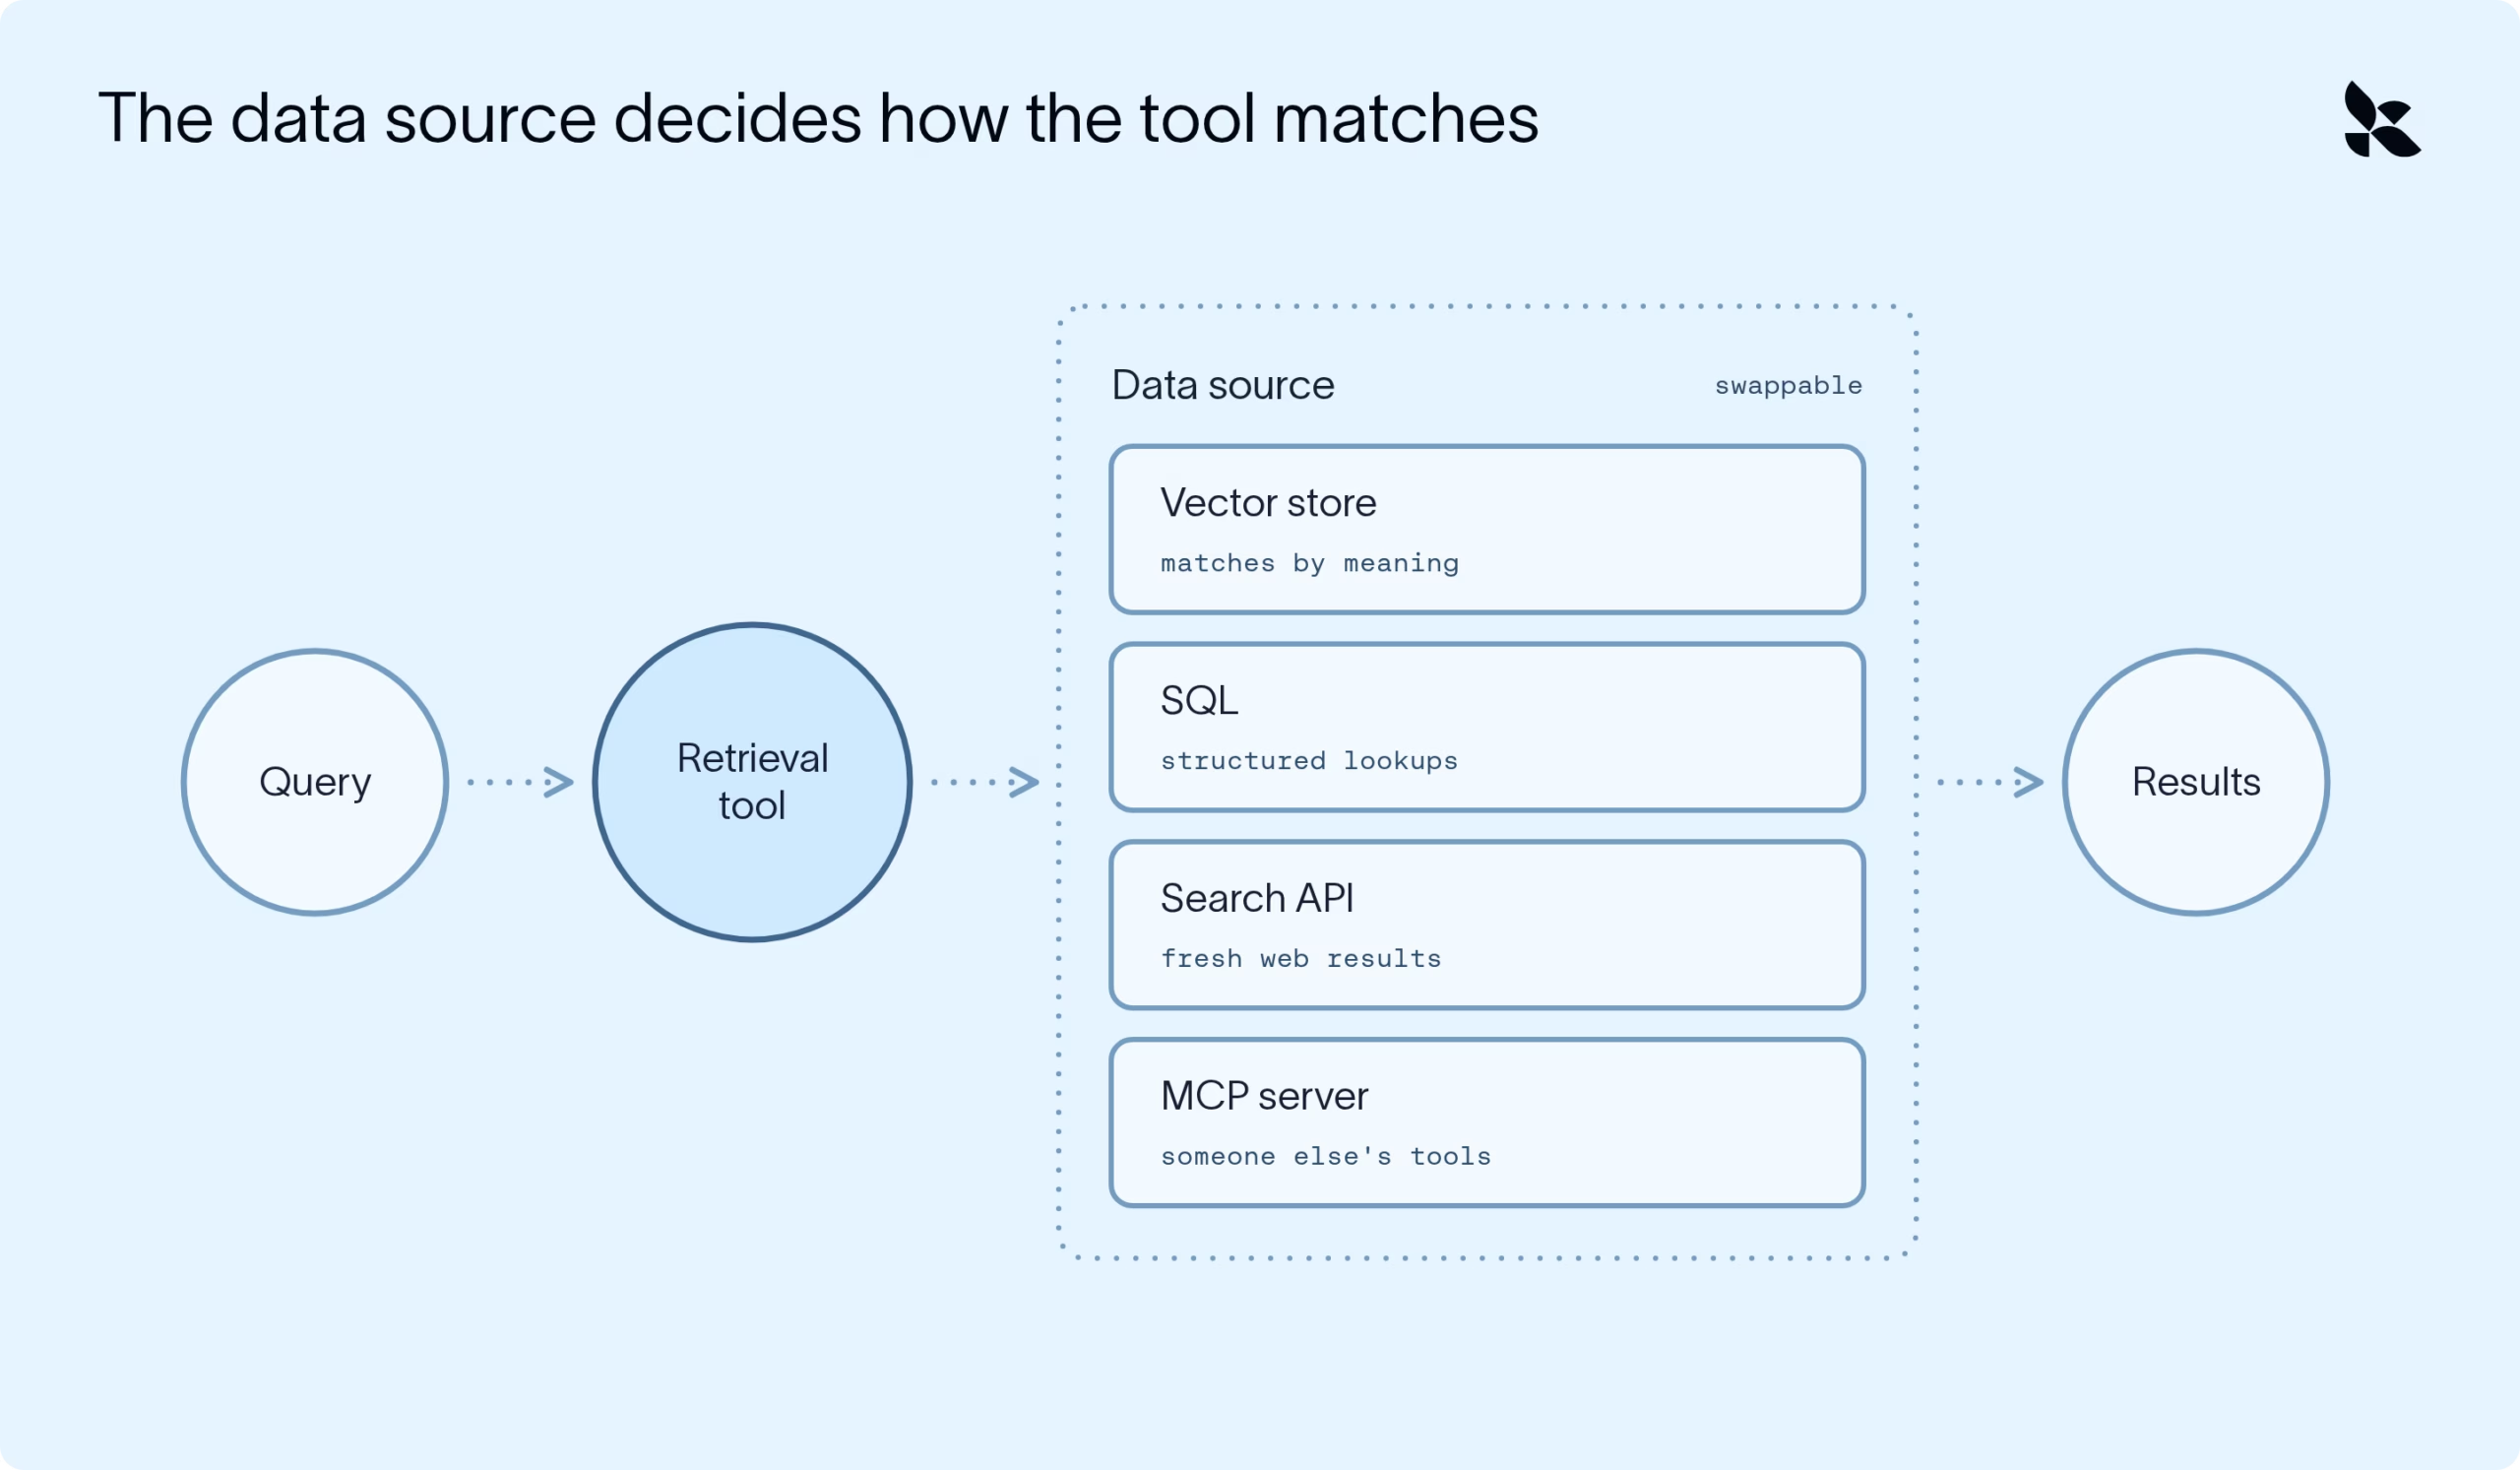
当必须处理非结构化长文本或模糊语义查询时,确定性的关键词匹配已无法满足诉求。此时必须引入基于向量数据库的语义检索工具(Retrieval Tools)。但如果语义检索每次召回的 4 到 10 篇完整文章全部直接注入主智能体,上下文窗口依然会迅速枯竭。为此,LangChain 提出了颠覆性的 “检索-卸载-委托(Retrieve, Offload, Delegate)” 三层工程模式:
1. 检索与文件指针卸载(Retrieve & Offload)
自定义检索工具在向量数据库或搜索引擎中完成 Top-K 召回后,绝不将文档正文直接作为 Tool Result 文本返回给主模型。相反,底层工具将每一篇原始检索结果写入持久化存储或沙箱文件系统(例如 /retrieved/result_{i}.md),并仅向主智能体返回极其轻量的文件路径字符串:
# LangChain 官方推荐的指针卸载检索工具范式
@tool
def search_news(query: str) -> str:
    """在新闻知识库中执行语义检索并将完整文档卸载至独立文件存储"""
    docs = vector_store.similarity_search(query, k=4)
    # 将长篇文档内容写入状态后端文件系统中
    files = [(f"/retrieved/result_{i}.md", doc.page_content.encode()) for i, doc in enumerate(docs)]
    backend.upload_files(files)
    # 仅向主智能体返回文件路径列表,实现上下文零膨胀
    return "已检索到候选文档并安全卸载至: " + ", ".join(path for path, _ in files)
2. 子智能体并行分级委托(Delegate)
主智能体拿到文件路径列表后,依然无需亲自逐一开窗阅读,而是将具体的阅读与提炼任务委托给轻量级子智能体(Subagents,如 chunk-analyst)。每个子智能体在完全独立的隔离上下文中运行,只负责读取一个指定文件,提炼出 1~2 句与原始问题直接相关的核心事实,并仅向上层汇报这一提纯后的结论。主智能体始终保持上下文窗口的绝对清爽,彻底免疫噪音干扰。
四、架构演进对比:传统 Agent 方案 vs LangChain 检索上下文工程
为直观呈现这一体系的技术优势,我们将三种主流智能体信息检索方案进行量化对比:
| 架构维度 | 传统简单 RAG (Two-step RAG) | 暴力 Agent 直推模式 | LangChain 检索上下文工程 |
|---|---|---|---|
| 检索决策灵活性 | 极差:仅在起始阶段执行一次硬检索 | 良好:循环调用工具,但缺乏边界 | 自主且自律:Agentic 循环 + 技能渐进式披露 |
| 上下文 Token 消耗 | 固定 2k~8k Tokens | 失控式膨胀:数轮内迅速打爆 128k+ | 极低:仅在主窗口留存指针与提纯摘要 |
| 长程决策抗干扰性 | 中等,无法处理多步骤长程任务 | 极差:过时脏上下文引发级联幻觉崩溃 | 极高:子智能体隔离执行,噪音 100% 物理阻断 |
| 大文件与巨型数据处理 | 完全无力处理,直接截断或 OOM | 容易触发 API Payload 限制或崩溃 | 基于 offset/limit 分页与沙箱文件指针存储 |
| 生产级综合可维护性 | 低,仅适用于简单 FAQ 场景 | 极差,不可预测的账单与超时 | 极佳,标准化的工业级 Agent Harness 模式 |
📝 站长洞察 (Editor’s Insight)
在过去两年中,大模型厂商一直在进行一场“百万上下文窗口”的军备竞赛,但真实的工业界工程落地无情地证明了:**上下文窗口越大,不加节制的暴力直塞反而死得越快**。LLM 在长程上下文中的“迷失在中间(Lost in the Middle)”以及对陈旧线索的偏执注意力,是导致大多数复杂 Agent 无法迈过 90% 生产可用性门槛的核心根源。LangChain 此次提出的上下文工程,本质上是将现代操作系统的分层存储架构(虚拟内存、文件句柄、进程隔离)复刻进了大模型运行时:通过文件路径充当句柄指针、让子智能体充当微内核线程。这种将确定性系统工具与概率性语言模型严密解耦的设计哲学,才是让 AI 智能体走出玩具阶段、真正在高可用企业系统中扛起业务重任的唯一解。
LangChain智能体为什么要先用glob和grep?
因为它们能在不加载全文的情况下先做确定性筛选:glob负责快速缩小文件范围,grep负责按行匹配关键字。这样可以显著减少无效读取、节省上下文窗口,并降低后续推理被噪音干扰的概率。
什么是检索结果指针卸载?
指检索到的长文档不直接返回给主智能体,而是先写入持久化存储或沙箱文件系统,只把文件路径等轻量指针返回给模型。这样可以避免一次召回多篇长文导致上下文瞬间膨胀。
子Agent分级委托能解决什么问题?
它把复杂任务拆分给不同子Agent处理,让主智能体只保留必要结论和指针,不承载全部原始材料。这样能隔离脏数据和过时信息,减少级联幻觉,更适合长程自主任务。
glob/grep前置过滤怎么落到代码里?
先把文件系统搜索前移到最小候选集:用glob缩小目录范围,再用grep做关键词命中,最后只把命中文件的片段送入模型。关键是把“全量读”改成“先筛后读”,并记录过滤规则便于复用与回放。
指针卸载与子Agent如何分级设计?
高频、低风险信息适合用指针卸载,只保留引用和摘要;复杂推理、跨文件决策再交给子Agent。建议按任务成本和错误代价分层:检索层负责找,执行层负责改,主Agent只做编排与验收。


