


💡 站外导读:随着AI应用向实时化、复杂化演进,模型推理效率与成本成为落地关键瓶颈。阶跃星辰最新发布的Step 3模型,正是瞄准这一痛点,通过MoE架构与系统创新,在保持321B总参数强大能力的同时,将激活参数控制在38B,并在国产及主流芯片上实现推理效率数倍提升。这标志着多模态大模型正从“能力竞赛”转向“效能竞赛”,为大规模行业应用铺平道路。
Step 3是什么
Step 3 是阶跃星辰最新发布的新一代基础大模型,专为推理时代设计,兼具高性能与极致成本效益。采用 MoE 架构,拥有 321B 总参数量 和 38B 激活参数量,是首个全尺寸、原生多模态推理模型,具备强大的视觉感知和复杂推理能力,能在多个领域实现高效应用。通过 AFD 分布式推理系统 和 MFA 注意力机制,实现了推理效率的大幅提升。在国产芯片上,推理效率可达同类模型的 3 倍,在 NVIDIA Hopper 架构芯片上吞吐量提升超 70%,显著降低了推理成本。Step 3 将于 7 月 31 日 正式开源,为全球开发者和企业提供最强的多模态推理模型。
Step 3的主要功能
-
视觉感知:Step 3 能准确识别和分析图像和视频中的复杂信息,例如在反光严重的菜单识别中,依然能准确还原内容。
-
复杂推理:支持跨领域的复杂知识理解、数学与视觉信息的交叉分析,例如结合微信群聊天记录和购物小票自动计算 AA 制消费分摊。
-
多模态任务处理:作为原生多模态模型,Step 3 能处理语言、视觉等多种模态的任务,满足多样化应用场景需求。
-
高效推理:通过系统架构创新,Step 3 在推理效率上表现出色。在国产芯片上,推理效率最高可达 DeepSeek-R1 的 300%,在 NVIDIA Hopper 架构芯片上吞吐量提升超 70%。
-
硬件友好:Step 3 适配多种硬件平台,包括主流和国产芯片,能显著降低推理成本,提升资源利用率。
Step 3的技术原理
- MoE 架构:Step 3 采用了 MoE(Mixture of Experts)架构,是高效的模型并行化方法。通过将模型分解为多个“专家”模块,根据输入动态选择合适的专家进行计算,MoE 架构能在保持高性能的同时显著降低计算资源的浪费。
- AFD 分布式推理系统:将模型中的注意力(Attention)和前馈网络(FFN)计算任务分配到最适合的硬件上,提升整体效率。
-
Attention 计算:极度消耗内存带宽的任务,分配给内存带宽大的 GPU 集群。
-
FFN 计算:极度消耗算力的任务,分配给算力强大的 GPU 集群。
-
-
MFA 注意力机制:优化算术强度,适配主流和国产芯片的性能特征,实现跨硬件平台的高效推理。
Step 3的项目地址
- Github仓库:https://github.com/stepfun-ai/Step3
Step 3的应用场景
- 智能终端 Agent:Step 3 可以应用于各种 IoT 设备,如智能家居、智能穿戴设备等,提供智能语音助手和视觉识别功能。
-
金融财经:Step 3 可以用于金融风险评估、智能客服、市场分析等场景。通过多模态数据处理,模型能更准确地分析市场趋势和用户需求。
-
内容创作:Step 3 可以辅助内容创作者生成创意文案、图像和视频内容。例如,结合视觉和文本信息生成高质量的广告文案或视频脚本。
-
视觉识别:Step 3 能处理复杂的视觉任务,如反光菜单识别、图像分类、目标检测等。
-
复杂推理:Step 3 支持跨领域的复杂知识理解,例如结合微信群聊天记录和购物小票自动计算 AA 制消费分摊。
-
自然语言处理:Step 3 在自然语言处理任务中表现出色,能理解并生成高质量的文本内容。
📝 站长洞察 (Editor’s Insight)
Step 3的发布精准抓住了当前大模型发展的核心矛盾:如何在模型能力与推理成本间取得最优解。其采用的MoE架构与AFD分布式系统,本质是将工程优化提升到算法同等重要的位置,这或许是下一阶段AI竞争的关键。特别值得注意的是其对国产芯片的适配与效率提升,这不仅是技术亮点,更是战略考量,为国产算力生态注入强心剂。开源决策也将加速技术民主化,推动推理成本进一步下探,催生更多实时、交互式的AI原生应用。
Step 3 是什么模型?
Step 3 是阶跃星辰发布的新一代基础大模型,定位为推理时代的原生多模态推理模型。它采用 MoE 架构,拥有 321B 总参数和 38B 激活参数,兼顾能力与推理效率。
Step 3 在推理效率上提升了多少?
文中给出的结果显示,Step 3 在国产芯片上推理效率最高可达同类模型的 3 倍;在 NVIDIA Hopper 架构芯片上,吞吐量提升超过 70%。
Step 3 什么时候开源?
文章明确提到,Step 3 将于 7 月 31 日正式开源。项目地址为 GitHub 仓库:https://github.com/stepfun-ai/Step3
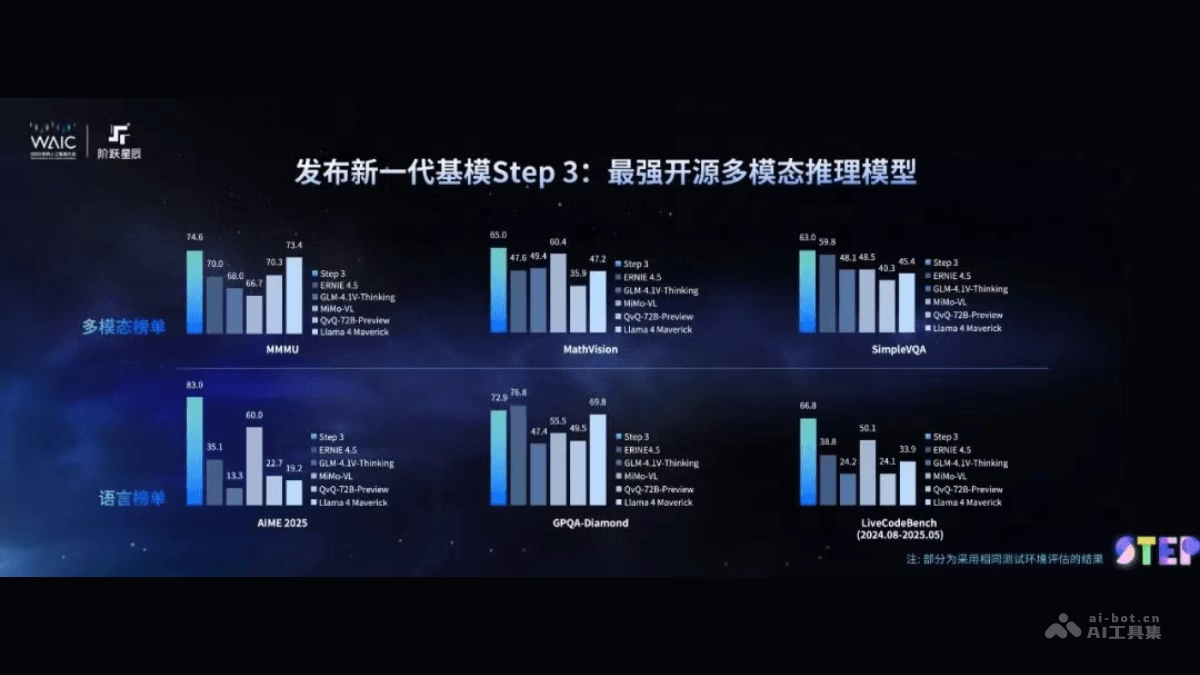
📊 Step 3 与竞品在多模态与语言基准上的对比跑分(AI 视觉结构化提取)
核心发现:图中显示 Step 3 在 MMMU、MathVision、SimpleVQA、AIME 2025 和 LiveCodeBench 上均取得最高分,但在 GPQA-Diamond 上略低于 ERNIE 4.5。
| 基准 | Step 3 | ERNIE 4.5 | GLM-4.1V-Thinking | MiMo-VL | QvQ-72B-Preview | Llama 4 Maverick |
|---|---|---|---|---|---|---|
| MMMU | 74.6 | 70.0 | 68.0 | 66.7 | 70.3 | 73.4 |
| MathVision | 65.0 | 47.6 | 49.4 | 47.2 | 35.9 | 60.4 |
| SimpleVQA | 63.0 | 59.8 | 48.1 | 48.5 | 40.3 | 45.4 |
| AIME 2025 | 83.0 | 35.1 | 13.3 | 60.0 | 22.7 | 19.2 |
| GPQA-Diamond | 72.9 | 76.8 | 47.4 | 55.5 | 49.5 | 69.8 |
| LiveCodeBench (2024.08-2025.05) | 66.8 | 38.8 | 24.2 | 50.1 | 24.1 | 33.9 |
MoE和MFA为什么能提升推理效率?
MoE通过稀疏激活减少每次计算量,MFA则优化注意力计算和跨模态对齐开销。真正的收益取决于路由质量、专家负载均衡和推理框架适配,训练好不等于部署就快。
国产芯片上部署这类模型要注意什么?
重点看算子支持、通信带宽、显存容量和并行策略。建议先做量化、分层缓存和张量并行适配,再评估吞吐与延迟;否则模型参数再大,硬件利用率也上不去。


