Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
阅读: Wall-OSS-0.5 – 自变量机器人开源的国产具身智能模型
Share
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
Wall-OSS-0.5 – 自变量机器人开源的国产具身智能模型
Prompt 语宙 > AIGC 资讯 > Wall-OSS-0.5 – 自变量机器人开源的国产具身智能模型
AIGC 资讯

Wall-OSS-0.5 – 自变量机器人开源的国产具身智能模型

Prompt 语宙研究院
最近更新: 2026年6月7日 下午6:07
3D与空间智能 AI智能体 大模型微调 开源大模型
SHARE
⚡ Prompt 语宙 AI 导读 · 30 秒核心看点
  • 采用 Gradient-Bridge 协同训练,把离散动作、多模态预测与 Flow Matching 融合进同一套 VLA 框架。
  • 支持桌面双臂、移动操作等 20 多种机器人形态,预训练检查点可直接上真机零样本部署。
  • 在 15 项真实任务微调后平均进度达 60.5%,较 π0.5 提升 17.5 个百分点,且保留基础视觉语言能力。

Wall-OSS-0.5是什么

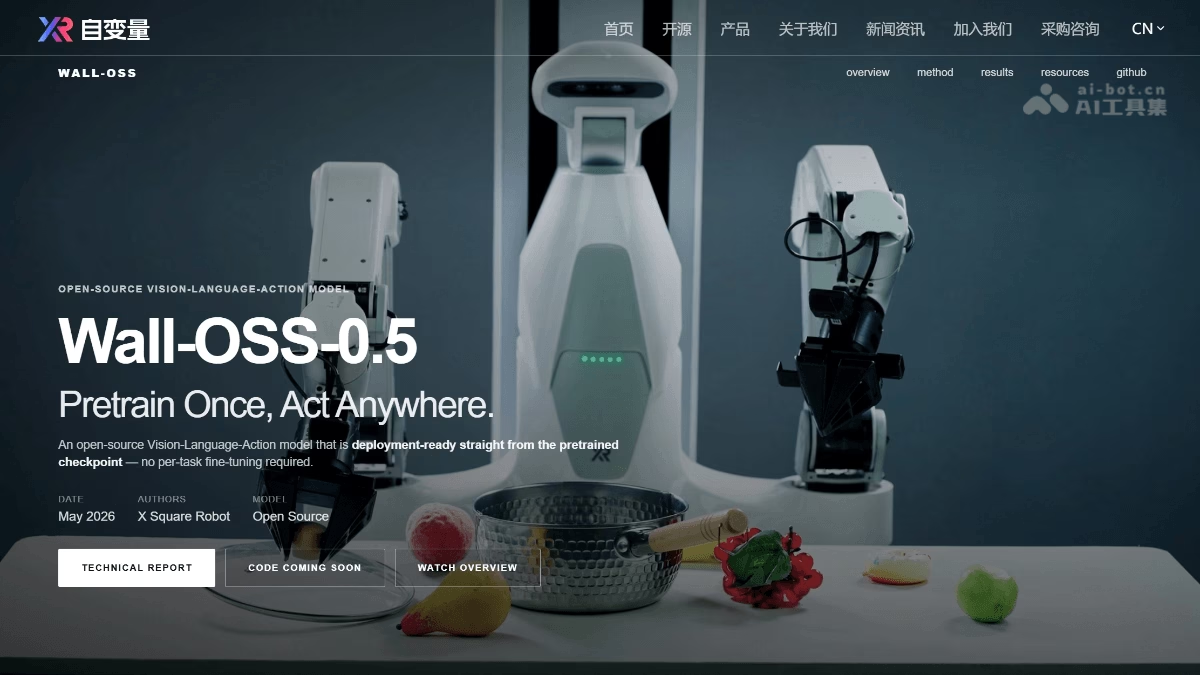
Wall-OSS-0.5是自变量机器人开源的国产具身智能模型,属于视觉-语言-动作(VLA)大模型,具备无需任务微调即可在真实机器人上部署的”零样本”能力。模型通过创新的Gradient-Bridge协同训练方法,将动作能力融入基础模型backbone,使机器人能直接执行搬运、分拣等17个真实任务,其中4个任务完成率超过80%。

阅读目录
  • Wall-OSS-0.5是什么
  • Wall-OSS-0.5的主要功能
  • Wall-OSS-0.5的技术原理
  • 如何使用Wall-OSS-0.5
  • Wall-OSS-0.5的核心优势
  • Wall-OSS-0.5的项目地址
  • Wall-OSS-0.5的同类竞品对比
  • Wall-OSS-0.5的应用场景

Wall-OSS-0.5

Wall-OSS-0.5的主要功能

  • 零样本真实机器人操作:预训练检查点可直接部署到物理硬件,无需针对特定任务微调即可执行抓取、排序、整理等操作,实现”预训练即可部署”。
  • 多形态统一适配:单个预训练检查点即可适配桌面双臂、移动操作等 20 多种机器人形态,打破传统模型需为每种硬件单独训练的局限。
  • 三目标协同训练:通过离散动作预测、多模态预测与连续流匹配三者互补优化,形成”梯度桥接”,让动作学习与视觉语言理解互不干扰、协同提升。
  • 混合专家架构(MoT):视觉-语言令牌由 VL Expert 路由处理,连续动作计算由 Action Expert 负责,联合注意力机制实现端到端梯度流动,兼顾语言理解与动作生成。
  • 视觉语言能力保持:动作训练不会侵蚀基础 VLM 能力,实体 grounding 能力提升 21.8 个百分点,通用视觉-语言理解与推理能力完整保留。
  • 高效微调适配:在 LeRobot 数据集上微调后,15 项真实机器人任务平均进度达 60.5%,领先同类模型 π0.5 达 17.5 个百分点。
  • 强泛化与长程执行:在 3 项未见过的任务(如变形物体操作)上依然保持高进度,支持多阶段连续操作(如绳索收紧、抹布折叠、果篮整理等长程任务)。

Wall-OSS-0.5的技术原理

  • 4B 参数 VLA 架构:基于 30 亿参数的 Qwen2.5-VL 视觉语言模型作为骨干,叠加动作生成组件,总参数量达 40 亿,实现视觉感知、语言理解与机器人动作生成的端到端统一。
  • 混合专家路由(MoT):采用 Mixture-of-Experts 架构,视觉-语言令牌通过 VL Expert 路由处理,连续动作计算通过独立的 Action Expert 处理,二者通过联合注意力机制实现端到端梯度流动,避免动作训练干扰语言理解。
  • 梯度桥接协同训练:创新性地将离散动作预测、多模态预测与连续流匹配(Flow Matching)三者作为互补优化目标进行协同训练,形成”梯度桥接”,使动作策略学习与视觉语言预训练知识相互增强而非冲突。
  • 连续流匹配动作生成:使用 Flow Matching 技术对连续动作空间进行建模,相比传统的离散化或回归方法,能够更精确地生成平滑、高维的机器人控制信号。
  • 预训练即部署设计:通过大规模异构数据预训练,使模型在预训练阶段就习得通用的物理操作先验,检查点可直接在真实机器人硬件上执行零样本推理,无需任务特定的微调后处理。
  • 大规模异构训练数据:覆盖 20 多种机器人形态,每轮训练包含超 100 万条真实机器人轨迹;同时融合 9000 万条多模态语料(含 1200 万实体桥接样本),实现约 60% 自采数据与 40% 开源数据的任务平衡采样。
  • 联合注意力与端到端优化:VL Expert 与 Action Expert 共享注意力计算图,确保语言指令、视觉场景与动作输出在特征层面深度耦合,梯度可跨模态双向传播。
  • 能力解耦保持机制:通过三目标协同与专家分离设计,动作训练不会侵蚀基础 VLM 能力,实体 grounding 能力提升 21.8 个百分点,同时完整保留通用视觉-语言理解与推理能力。

如何使用Wall-OSS-0.5

  • 环境准备:创建 Python 3.10 的 conda 环境,安装 PyTorch 等基础依赖,并确保安装 Flash Attention 2.7.4 及以上版本以加速推理。
  • 安装 LeRobot 库:克隆 Hugging Face 的 LeRobot 仓库,checkout 到指定兼容版本后执行 pip install -e . 完成安装。
  • 安装 Wall-X 工具链:克隆 wall-x 开源仓库,运行 git submodule update --init --recursive 拉取子模块后,执行安装命令完成工具链部署。
  • 下载预训练权重:从 Hugging Face(x-square-robot/wall-oss-0.5)下载官方发布的预训练模型检查点。
  • 配置机器人参数:根据目标机器人类型(如桌面双臂、移动操作等)设置自由度(DOF)配置、模型路径、数据路径及训练超参数。
  • 执行微调(可选):如需针对特定任务优化,在 LeRobot 格式的数据集上运行微调脚本(如 bash ./workspace/lerobot_example/run.sh)以提升任务表现。
  • 部署到真实硬件:加载预训练或微调后的检查点,在真实机器人硬件上执行零样本推理或微调后推理,直接输出可执行的机器人控制策略。

Wall-OSS-0.5的核心优势

  • 部署即用:区别于传统 VLA 模型必须微调后才能使用,预训练检查点直接产生可执行的机器人策略。
  • 高效适应:在 15 项真实机器人任务上微调后平均进度 60.5%,比 π0.5 的 43.0% 高出 17.5 个百分点。
  • 强泛化能力:在 3 项未见过的任务(如变形物体操作)上依然保持高进度,绳索收紧任务达 82%。
  • 视觉语言能力保持:动作训练不会侵蚀基础 VLM 能力,实体 grounding 能力提升 21.8 个百分点,通用 VL 能力完整保留。
  • 数据规模领先:覆盖 20+ 种机器人形态,每轮 100 万+ 轨迹,9000 万多模态样本。

Wall-OSS-0.5的项目地址

  • 项目地址:https://x2robot.com/oss#resources
  • Github仓库:https://github.com/X-Square-Robot/wall-x
  • 论文地址:https://x2robot.com/api/files/file/wall_oss_05.pdf

Wall-OSS-0.5的同类竞品对比

对比维度 Wall-OSS-0.5 π0.5 OpenVLA
开发机构 自变量机器人(X Square Robot) Physical Intelligence(PI) Stanford 等学术机构
参数规模 40 亿(3B Qwen2.5-VL 骨干) 未公开(基于 π0 架构扩展) 70 亿(LLaMA 2-7B 骨干)
核心架构 MoT 混合专家 + 梯度桥接协同训练 Transformer 分层推理 + 动作专家 Prismatic VLM(SigLIP + DINOv2 + LLaMA 2)
动作生成方式 离散 token 与连续流匹配协同优化 高层离散 token 自回归 + 低层流匹配去噪 将动作视为语言模型词汇表中的离散 token 预测
训练数据规模 20+ 种机器人形态,每轮 100 万+ 轨迹,9000 万多模态样本 网络数据 + 跨机器人经验 + 口头指令多源协同 Open X-Embodiment 数据集 97 万条轨迹
零样本部署能力 预训练检查点直接部署,17 项任务中 4 项进度超 80% 预训练后需后训练/微调,不直接支持零样本硬件部署 预训练模型需任务特定微调,不支持直接零样本部署
微调后性能 15 项真实任务平均进度 60.5%,领先 π0.5 达 17.5 个百分点 真实家庭环境任务成功率 60%-88%,复杂指令遵循率高 WidowX / Google Robot 多任务成功率领先 RT-2-X 16.5%
开源程度 完全开源(权重、训练代码、配方、消融实验) 研究发布,部分技术细节公开 完全开源(模型权重、代码、LoRA/量化微调方案)
核心创新点 梯度桥接实现预训练即部署,动作与 VL 能力协同增强不互损 开放世界泛化与层次化推理(高层语义规划 + 低层动作执行) 首个全面开源的通用 VLA,验证 VLM 直接微调生成动作的可行性
VLM 能力保持 实体 grounding 提升 21.8%,通用 VL 理解与推理能力完整保留 依赖网络数据维持语义理解,动作训练后需专门保持 基于预训练 VLM 微调,语言能力基线较高

Wall-OSS-0.5的应用场景

  • 家庭服务:积木排序、水果分类、抽屉整理、戒指堆叠等日常家务操作。
  • 柔性物体处理:绳索收紧、抹布折叠、插花等变形物体操作任务。
  • 工业装配:精密零件抓取、颜色分类、工具归位等重复性制造流程。
  • 双臂协作:需要双手配合完成的复杂装配、整理及长程组合动作。
  • 长程任务执行:多阶段连续操作,如果篮整理等多步骤需要持久注意力的任务。
❓ 常见问题解答(FAQ)
Wall-OSS-0.5 可以直接部署到真实机器人吗?

可以。文章介绍它支持“预训练即可部署”,预训练检查点可直接在真实硬件上进行零样本推理,无需针对单一任务先做微调,适合抓取、分拣、整理等真实操作场景。

Wall-OSS-0.5 的核心技术突破是什么?

核心是 Gradient-Bridge 协同训练与 MoT 混合专家架构。前者把离散动作预测、多模态预测和连续流匹配联合优化,后者将视觉语言与动作计算分路处理,兼顾理解能力和动作生成能力。

Wall-OSS-0.5 微调后的效果怎么样?

在 LeRobot 数据集上微调后,它在 15 项真实机器人任务上的平均进度达到 60.5%,比同类模型 π0.5 高 17.5 个百分点;同时在未见任务和长程操作上也表现出较强泛化能力。

🔬 语宙深潜追问 · 进阶实操拆解
零样本机器人部署真能直接商用吗?

能做演示,不等于能规模商用。零样本适合标准化、低风险任务,真正进产线还要补充安全约束、失败回退、环境泛化和长尾数据采集,否则稳定性很难过关。

VLA模型要提升真实任务成功率靠什么?

靠高质量动作数据、任务分层训练和更强的视觉-动作对齐。像Gradient-Bridge这类协同训练能缓解分布偏移,但最终还是要用真实机器人回路持续校准,而不是只看仿真指标。

🗳️ 读者观点微投票 · 您的实战立场是?
具身智能先开源模型还是先做闭环产品?
🕸️ 语宙向量知识图谱 · 语义强关联深度内链
🌐 所属权威专题:Gemini 全模态与空间智能 →
  • 重磅开源|Wall-OSS-0.5:国产具身大模型破解零样本部署难题,无需微调直驱真实机器人
  • 小米开源首代机器人VLA大模型Xiaomi-Robotics-0:47亿参数MoT架构,实现实时流畅控制
  • 宇树科技重磅开源UnifoLM-VLA-0:基于Qwen2.5-VL-7B,单一模型实现12类机器人操作,准确率98.7%
  • Qwen-VLA – 阿里通义推出的通用视觉-语言-动作模型
🏛️ Prompt 语宙研究院 · Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
📄 Markdown 纯净版
💡 这篇内容对您有启发吗?
📡 RSS 订阅✨ 提交 AI 工具 / 合作
🚀 Prompt 语宙 AI 创作者生态:探索 2,800+ 全球实用 AI 工具与高精度生图提示词咒语库
🧭 语宙 AI 导航 (ai.paooo.com)🎨 AI 生图 Prompt 库📚 核心专题导航⚡ AIGC 早报生成器
QVQ – 阿里通义开源的视觉推理模型
腾讯重拳出击!《三角洲行动》AI视觉外挂遭封号十年+刑事追诉,游戏反作弊进入’AI反制AI’时代
Helix – Figure 推出的端到端通用控制模型
Awesome MCP Servers – 开源的MCP资源聚合平台,覆盖多个垂直领域
VideoGrain – 悉尼科技大学和浙大推出的视频编辑框架
TAGGED:3D与空间智能AI智能体大模型微调开源大模型
分享
Email 复制链接 打印
Share
Prompt 语宙研究院 头像
ByPrompt 语宙研究院
Follow:
Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
上一篇 MiniMax M3 – MiniMax 推出的新一代 AI 模型 MiniMax M3 – MiniMax 推出的新一代 AI 模型
下一篇 SenseNova-U1-8B-MoT-Infographic – 商汤科技开源的信息图增强模型 SenseNova-U1-8B-MoT-Infographic – 商汤科技开源的信息图增强模型
Ad image
Ad image

最近更新

NVIDIA Vera Rubin 亮相 MLPerf 评测并在训练与端点测试中领先
单GPU训练性能翻倍且智能体每瓦吞吐暴增10倍!NVIDIA Vera Rubin首战MLPerf大获全胜:DeepSeek-V3千卡扩展效率97%与Agentic端点推理全景深度拆解
AIGC 资讯
美国商务部大楼与半导体出口管制新规
算力超1200万TPP即触发许可且限期90天整改!美国商务部突发全球数据中心新规:封死离岸云端远程租用算力与废止AI扩散规则全景深度拆解
AIGC 资讯
AI 原生 CRM 初创公司 Dreamteam 获 5300 万美元融资,挑战 Salesforce 与 HubSpot
斩获5300万美元对标Salesforce!前Freshworks高管创办AI原生CRM Dreamteam:基于Company Brain虚拟记忆与自动化智能体流水线深度拆解
AI 工具
Optimizely 谈营销智能体落地:企业需将审核从输出转向输入
告别Vibe Coding虚火!Optimizely解密企业级营销智能体落地法则:从“输出审核”走向“输入约束”、专用Harness架构与800落地页规模化实战
最新趋势

相关推荐

Luma Ray2 – Luma AI 推出的最新视频生成模型
AIGC 资讯

Luma Ray2 – Luma AI 推出的最新视频生成模型

Prompt 语宙研究院
3D与空间智能 AI绘画提示词 AI视频生成 Luma AI
OpenAI 想把 ChatGPT 塞进你的眼镜:布罗克曼盯上可穿戴,API 仍是早期雏形
AIGC 资讯

OpenAI 想把 ChatGPT 塞进你的眼镜:布罗克曼盯上可穿戴,API 仍是早期雏形

Prompt 语宙研究院
3D与空间智能 AI音频与语音 ChatGPT Codex OpenAI
告别 VAE 与视觉编码器!NVIDIA 携手滑铁卢大学开源无编码器多模态巨作 PixelUMM:单 Decoder 像素级读写,通吃文生图/生视频与多模态理解
AI 工具AIGC 资讯

告别 VAE 与视觉编码器!NVIDIA 携手滑铁卢大学开源无编码器多模态巨作 PixelUMM:单 Decoder 像素级读写,通吃文生图/生视频与多模态理解

Prompt 语宙研究院
NVIDIA PixelUMM 像素空间扩散 多模态大模型 文生视频 无编码器架构
xAI Imagine v0.9 发布:20秒生成6秒视频,Grok免费开放,AIGC视频创作新标杆
AI 工具AIGC 资讯

xAI Imagine v0.9 发布:20秒生成6秒视频,Grok免费开放,AIGC视频创作新标杆

Prompt 语宙研究院
AIGC Grok xAI 视频生成模型 语音交互
/ Prompt 语宙 /

探索生成式 AI 的无限创作潜能,一站式获取前沿 AIGC 资讯、高阶 Prompt 咒语与全球实用 AI 工具。

核心专栏

  • Remaker AI
  • BGRemaker 抠图Hot
  • AIGC 工具
  • Prompt 咒语生成器
  • 去水印工具

生态与服务

  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作

标签

开源大模型 AI智能体 AI办公效率 AI绘画提示词 OpenAI 大模型微调 Midjourney AI编程 stable diffusion AI视频生成 ChatGPT 3D与空间智能 HuggingFace AI音频与语音 RAG检索增强 Claude Flux AIGC Gemini 通义千问 Anthropic Llama Cursor DeepSeek Prompt AI Agent Kimi 智谱AI 具身智能 YouTube
Prompt 语宙Prompt 语宙
Follow US
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.