

💡 站外导读:随着 LLM 与自主安全智能体(Security Agent)渗透代码审查,全球通用漏洞披露体系(CVE)在 2026 年迎来了一条令人窒息的垂直攀升曲线。开发者 @0x_Osprey 发布的 CVE Tracker 犹如一面照妖镜,将大模型版本发布与全球漏洞激增的强相关性赤裸裸呈现在行业面前。然而,漏洞发现量呈指数级爆发并不代表系统更危险,反而引发了致命的“告警风暴”与虚假分诊危机,开源项目维护者正被劣质 AI 漏洞报告推向崩溃边缘。本文将从 SRE 与攻防架构视角,深度复盘这场 AI 放大器引发的安全治理巨变。
1. 令人窒息的垂直曲线:CVE Tracker 揭开 AI 军备竞赛冰山一角
在网络安全与系统可靠性工程领域,CVE(Common Vulnerabilities and Exposures)一直被视为全球通用漏洞的核心坐标系。无论是顶尖科技巨头、基础软件厂商还是独立安全研究员,均依赖此标准对软件缺陷进行编号、评级、溯源与协同修复。
然而,独立开发者 @0x_Osprey 近日上线的一款可视化分析工具 —— CVE Tracker,向全行业展示了一组震撼的数据景观:进入 2026 年以来,全球已获得正式编号的 CVE 漏洞总量呈现出一条近乎垂直向上的爆炸性曲线。更为耐人寻味的是,该平台特别将全球主流前沿 AI 模型的发布节点以时间轴形式进行了精确叠加映射。
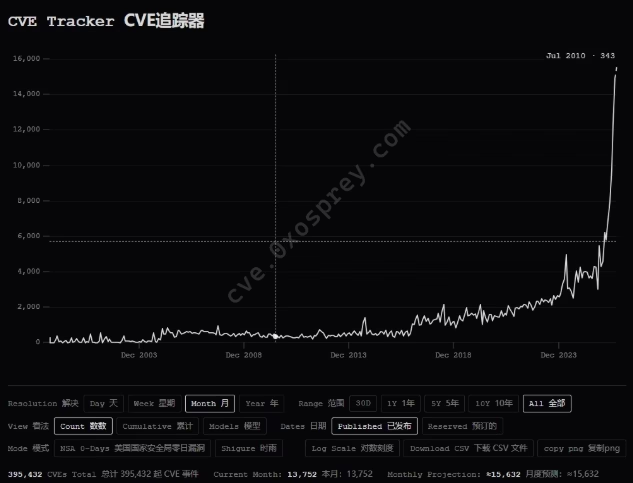
图 1:CVE Tracker 展现的 2026 年漏洞爆发曲线与前沿 AI 模型迭代时间轴强耦合(来源:CVE Tracker 官方实测)
从数据可视化结果可以清晰看出,每当新一代具备长上下文代码理解与跨仓库逆向能力的推理大模型(如 Claude Opus 5、GPT-6.1 或 DeepSeek 系列)问世并开放 API 后,随之而来的便是全球各大缺陷追踪库的提报高峰。这种现象不仅印证了 AI 攻防技术的普及,更宣告了传统基于人工经验的手工作坊式漏洞挖掘时代彻底终结。
2. 效率狂欢还是虚假繁荣?AI 放大器效应的双刃剑
据科技智库与安全专家分析,当前的生成式大模型与自动化智能体正在充当极其强势的“安全研究放大器”(Security Research Multiplier)。以往需要资深安全架构师耗费数周时间审计的深层内存泄漏、反序列化隐患及并发竞争漏洞,如今在 Agent 批量调用 AST 解析器与符号执行引擎的协同下,几分钟内即可完成扫描并自动撰写出格式完备的漏洞预警报告。
这种技术平权带来了显著的“排查无死角”红利,将原本人力无暇顾及的冷门开源仓库、底层工具链全面纳入了安检范围。然而,数据爆发的背后却伴随着严峻的工程反噬:漏洞被发现的绝对数量暴增,绝不等于系统在物理层面上变得更加脆弱,反而放大了运维分诊的混乱度。
| 评估维度 | 传统人工白盒审计 | 纯 AI 自动化脚本扫描 | SRE 级混合智能分诊体系 |
|---|---|---|---|
| 扫描与挖掘速度 | 以周/月计,依赖专家精力 | 毫秒级流式吞吐,高并发调用 | 分钟级调度,动态沙箱并行启动 |
| 误报率与幻觉噪声 | 极低(通常附带严格本地 PoC) | 极高(大量理论推导与臆想漏洞) | 受控收敛(强制自动化 PoC 闭环验证) |
| 开源维护者负担 | 沟通成本低,易于定级合并 | 灾难级告警风暴,引发信任瘫痪 | 自动过滤 90% 虚假报告,仅推真威胁 |
| 真实安全防御增益 | 覆盖面窄但击中要害 | 边际效益递减,加剧分诊内耗 | 实现真正的全生命周期零信任免疫 |
3. 开源维护者的至暗时刻:垃圾 CVE 与投机刷分乱象
在海量报告的冲刷下,全球开源生态正遭遇前所未有的制度性挑战。由于许多高校、科研机构及安全评测体系将“获得 CVE 编号数量”作为能力认证或学术指标,许多开发者开始滥用大模型流水线批量扫描 GitHub 开源项目,生成语焉不详的漏洞证明并疯狂提交 CVE 申请。
这些充斥着大模型“一本正经胡说八道”风格的报告,往往逻辑看似严密,实则脱离物理运行环境:
- 脱离边界约束:将仅存在于内部测试沙箱或极端假定条件下的内存越界,包装为“远程代码执行(RCE)”危险漏洞;
- 缺乏 PoC 可复现性:上报者甚至没有在物理机器上运行过一遍代码,纯靠 LLM 推测调用栈,要求维护者耗费数小时协助“自证清白”;
- CVE 分配机构审核挤兑:面对呈几何级数增长的申请函,各 CVE 编号授权机构(CNA)审核团队不堪重负,审核延宕与误收录事件频发。
4. SRE 视角下的零信任重构:从被动修补走向自动化验证闭环
面对近乎垂直拉升的漏洞曲线,传统的企业安全防护方案已难以为继。Site Reliability Engineering(SRE)与 DevSecOps 团队必须迅速调整作战范式,构建坚不可摧的工程护城河:
- 实施严格的 PoC 沙箱准入:对任何外部提交的漏洞报告,前置自动化测试门禁。只有在隔离容器(Firecracker / gVisor)中能够物理触发崩溃、越权或数据泄露的 Payload,才允许进入工单队列;
- 部署反向 LLM 分诊 Agent:使用具备严格逻辑一致性审查的微调模型,自动对接收到的 CVE 报告进行代码语义核对,直接剔除占位符式和臆想式漏洞;
- 固化软件供应链软件物料清单(SBOM):通过精细化的依赖图谱管理,将防护重心从被动的‘追逐漏洞库更新’转向内生的‘代码级最小特权隔离’与动态内存防御。
📝 站长洞察 (Editor’s Insight)
安全行业长期面临“攻击者只需要找到一个破绽,而防守者需要封堵所有死角”的不对称博弈。AI 的介入表面上摊平了漏洞挖掘的技术门槛,实质上是将非对称的杠杆进一步向混乱方倾斜。当数以万计缺乏 PoC 验证、纯靠大模型推测的‘幻觉漏洞’被自动化脚本批量提交至 GitHub 与 NVD 时,消耗的是整个人类开源生态极其稀缺的白名单审查带宽。未来的安全防线必将不再依赖粗暴的 CVE 数量统计,而是走向‘动态沙箱验证即代码’(Verification-as-Code)。只有那些能够由 Agent 自主在隔离沙箱中真实复现、并物理阻断利用链的漏洞,才配得上紧急响应资源的倾斜。在 AI 时代,分诊过滤与噪音净化,其价值已经远远超越了单纯的代码扫描。


