

💡 站外导读:在外部严格的技术封锁与尖端芯片出口管制下,中国前沿人工智能产业究竟在依赖何种规模的物理算力底座支撑其大模型快速迭代?全球顶级 AI 研究智库 Epoch AI 最新发布了一篇极具工程穿透力的硬核调查报告。研究团队绕过传统的官方口径与宣传通稿,直接采购了商业高分辨率遥感卫星影像,并开创性地利用大型数据中心的散热设备工程模型(通过外围蒸发冷却塔水汽冷凝羽流以及高速旋转风机在多光谱传感器中留下的彩色虚影进行物理工况验证),全景反演测算了华为位于内蒙古呼和浩特和林格尔新区的旗舰级智算中心。测算显示,该园区四栋关键机房承载的 AI IT 供电功率高达 286 兆瓦(MW),推算已部署约 10.5 万颗升腾 910C 芯片与 8000 颗 910B 芯片,折合约 8.1 万个英伟达 H100 等效算力(H100e)。这一硬核数据不仅为行业量化评估中国智算集群的真实天花板提供了第一手客观标尺,也深刻展现了中美在顶级 AI 超算集群上的规模差距与演进轨迹。
一、硬核工程遥感:利用卫星水汽羽流与散热模型反演 286MW 智算园区
在评估未公开技术指标的超大型智算中心时,传统的公开信息往往充斥着公关修辞与不确定性。Epoch AI 研究团队采取了一种纯粹基于第一性原理与热力学物理守恒的工程遥感方法论:现代 AI 训练服务器的功率密度是传统通用云计算服务器的 10 倍以上,而芯片消耗的电能几乎 100% 最终会转化为废热,必须通过外部重型冷却塔进行散热排出。
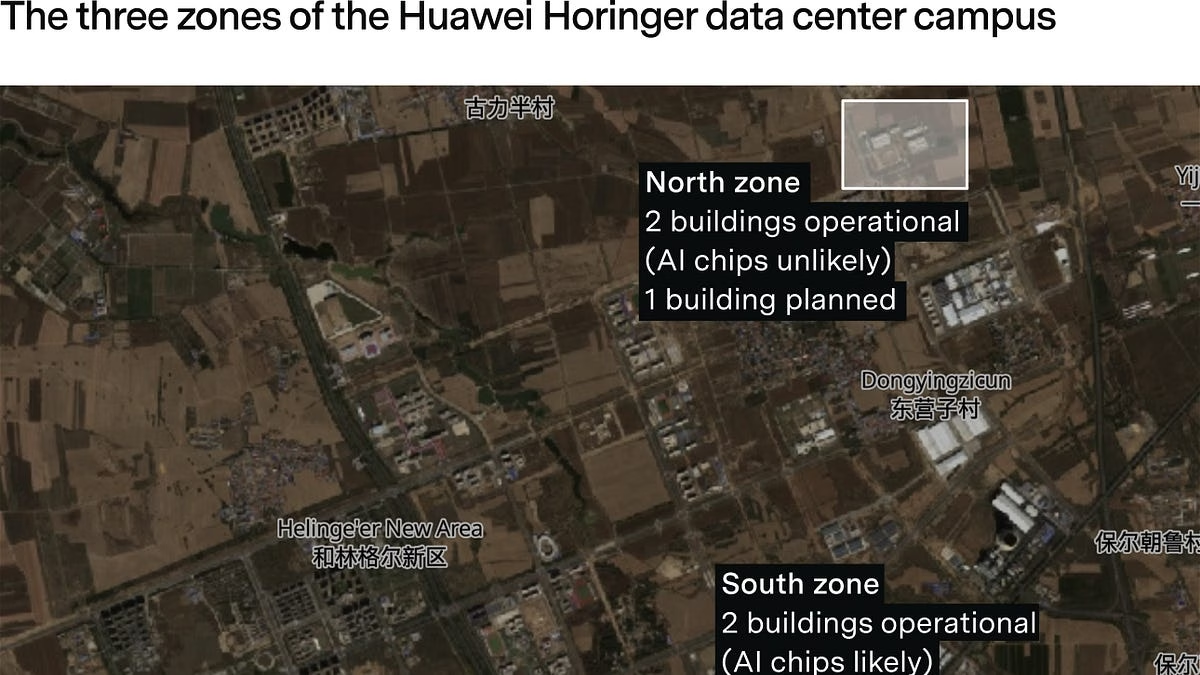
华为和林格尔园区总共由西区(West)、南区(South)与北区(North)三大片区组成。通过高分辨率卫星图像的逐栋建筑物比对,研究人员发现:
- 排除低密度区域:北区建筑物外围的冷却设备数量远少于西区和南区,表明其主要承载普通通用云存储与网络负载,而非高功率密度的 AI 加速集群;
- 锁定核心智算大楼:西区和南区各建有两栋结构高度一致的典型三层重载数据机房(共计 4 栋),外围密布高密度的蒸发冷却塔、应急柴油发电机组以及重载变电站;
- 物理运转工况实证:卫星影像清晰捕捉到至少一栋建筑顶部的蒸发冷却塔上方存在明显的冷凝水汽羽流(Condensed Water Vapor);更令人惊叹的是,利用多光谱卫星传感器在不同纳秒级时间窗口捕获红绿蓝波长产生的“彩色虚影(Ghosting Glare)”效应,直接证实了冷却塔大型排风扇处于高速运转状态;
- 功耗反演:根据可见冷却单元的规格、散热量模型与当地气温热力学参数,研究人员精确反推出这 4 栋大楼的 AI IT 净供电容量高达 286 兆瓦(MW)。截至 2026 年底,其中 3 栋已全面投入满负荷商业运营,第 4 栋大楼预计将于 12 月底正式通电点亮。
二、10.5万颗升腾 910C 入驻:和林格尔机房的芯片构成与算力折算
明确了 286MW 的电力天花板后,下一个核心问题是:机房内的服务器机架究竟被填装了什么芯片?
根据华为公开的技术架构规范与“超节点(Hypernode)”系统文档,和林格尔数据中心从底层网络拓扑与供电设计上就是专门面向超大规模深度学习训练与长上下文推理量身定制的。Epoch AI 结合供应链推算数据表明,截至 2026 年第一季度末,华为升腾系列芯片累计已完成销售与交付约 90.7 万颗升腾 910C 和 60 万颗 910B 芯片。按照业界标准的从出货到机房机柜部署通电的 4 个月时滞周期(Time-to-Deployment Lag),研究团队测算出和林格尔园区在这批货源中消化了约 11% 的 910C 总库存:
- 物理芯片在架规模:当前已投产的三栋大楼内,物理部署了约 105,000 颗升腾 910C 芯片 以及约 8,000 颗上一代升腾 910B 芯片;
- 统一算力基准折算(H100e):在国际通用的大模型算力对标中,通常以单颗英伟达 H100 SXM5(FP16/BF16 密集计算吞吐与显存带宽)作为 1.0 标准基准单位(H100-Equivalent, H100e)。根据实测技术指标,升腾 910C 的单芯片实际大模型有效算力约为 0.76 H100e(相比之下,英伟达最新一代 Blackwell B200/B300 则可达 2.5 H100e);
- 总有效算力池:经系统化加权计算,华为和林格尔智算中心当前的综合有效 AI 算力折合为 81,000 个 H100 等效算力(90% 置信区间为 3.6 万至 14.1 万 H100e)。
8.1 万 H100e 意味着什么?报告指出,这一单体集群规模不仅稳居中国境内智算中心前两名(与万国数据乌兰察布园区、华为芜湖机房并列第一梯队),而且即便只切出其 10% 的算力(约 8,100 H100e),就足以在短短 30 天内从头预训练一个 DeepSeek-V4-Pro 级别的万亿 MoE 旗舰大模型。如果将其全量算力合并执行单次分布式大任务,训练一个 GPT-6 Astra 规模的模型理论上也仅需约一年时间。
三、与全球领跑者对标:华为和林格尔 vs SpaceX Colossus 2 算力基准深度实测
然而,当把和林格尔这艘国内算力旗舰放置在全世界最前沿的坐标系中时,巨大的规模代差立刻显现。全球目前公认算力容量最大的人工智能超算中心,是马斯克旗下 xAI 部署在美国田纳西州孟菲斯的 Colossus 2:
| 超算集群名称 | 运营主体与地理位置 | AI IT供电容量 | 主战加速芯片及规模 | 总算力折算 (H100e) | 占 Colossus 2 算力比例 |
|---|---|---|---|---|---|
| Huawei Horinger (和林格尔) | 华为(中国内蒙古) | 286 MW(当前投运) | ~10.5万颗 升腾910C + 8千颗 910B | 约 81,000 H100e | 约 7.1% |
| SpaceX / xAI Colossus 2 | 马斯克 xAI(美国田纳西) | > 1,000 MW(千兆瓦级规划) | 混合部署 H100/H200 及 Blackwell B200 | > 1,140,000 H100e | 100.0%(全球基准) |
| Huawei Wuhu (芜湖江东园区) | 华为(中国安徽) | 约 320 MW(扩建中) | 主打升腾 910C 密集集群 | 约 95,000 H100e | 约 8.3% |
| VNET Bayin Ulanqab (世纪互联) | 世纪互联(中国内蒙古) | 约 260 MW | 国产与合规芯片混合云 | 约 78,000 H100e | 约 6.8% |
对比数据表明:华为和林格尔数据中心的 AI 有效算力容量,目前仅相当于 Colossus 2 的约 7%(十四分之一)。 造成这一巨大悬殊的根本原因并不仅仅在于电力规模——尽管美国顶级数据中心单体供电已经迈入 1,000 兆瓦(1 吉瓦)大关,更核心的瓶颈在于算力能效比(Compute per Unit of Power)。由于缺乏台积电先进制程的制造支持,升腾 910C 在单位功耗下释放出的实际吞吐较英伟达 Blackwell 芯片存在明显差距,导致美国顶级机房每兆瓦电力能够支撑的 AI 算力达到了国内集群的 2.5 倍左右。
四、2028 演进推演:70% 扩建提速能否打破算力瓶颈?
和林格尔的建设步伐远未停歇。卫星图像显示,除了即将于年底投产的第 4 栋机房外,南区已经有一栋全新的超算大楼破土动工,地基土建与变配电工程正快速铺开。Epoch AI 预计该栋新楼将于 2028 年 2 月 正式上线运行。
届时,和林格尔园区的总有效算力预计将攀升 70% 以上,达到 141,000 H100e(90% 置信区间 6.5 万至 22.7 万)。加上华为芜湖等姐妹园区的同步扩建(芜湖预计在 2027 年底达到 15.1 万 H100e),国内自主可控的万卡智算网络正在加速织密。
然而,全球算力竞赛从来不是静态对比。当和林格尔在 2028 年冲刺 14 万 H100e 时,SpaceX 的 Colossus 2 预计将随着下一代核能与微电网的接入,膨胀至超过 180 万 H100e 的巨无霸规模。这意味着中美在前沿算力绝对存量上的代差在未来两年内极难出现根本性收敛。然而,正如 Epoch AI 在报告末尾所感叹的那样:“在面临如此严苛的物理制程封锁与单瓦算力劣势下,中国科研团队在过去两年依然通过激进的 MoE 架构创新、通信优化算法与软硬件联合调优,训练出了具有世界级竞争力的顶尖大模型,这本身就是全球人工智能工程史上的一大奇迹。”
📝 站长洞察 (Editor’s Insight)
Epoch AI 这份通过卫星遥感与散热模型量化华为智算中心的报告,为我们褪去一切概念炒作、看清中国 AI 底层物理现实提供了一面极其冷峻的镜子。从数据中心基础设施工程(SRE)的专业视角来看,我们不得不正视两项硬核事实:第一,算力不仅仅是“芯片”问题,更是“能源转化率”的博弈。在制程受限导致单瓦算力落后 2.5 倍的前提下,堆叠 10.5 万颗升腾 910C 所伴随的供电、液冷、故障率(MTBF)以及跨芯片拓扑通信延迟,是指数级上升的分布式工程地狱。华为能够在和林格尔稳定跑通 8.1 万 H100e 的有效集群,其底层的系统级工程整合能力早已跻身世界第一梯队。第二,这也彻底宣告了单纯模仿硅谷“暴力堆算力”路线的不可行性。当我们的单体集群只有对手的 7% 时,中国大模型突围的唯一破局之道,就是像 DeepSeek 那样将注意力稀疏化、算法工程效率与端到端系统架构优化压榨到物理极致。用软件架构的十倍效率,去对冲硬件规模的十四倍差距,这将是未来五年中国 AI 从业者必须背水一战的时代宿命。
Epoch AI是怎么测算和林格尔算力的?
报告主要用商业高分辨率遥感影像,结合冷却塔水汽羽流、风机工况和数据中心散热模型,反推建筑级功耗,再据此估算芯片部署规模与等效算力。
和林格尔智算中心大约有多少算力?
文中给出的测算结果是:四栋关键机房约286MW AI IT供电功率,已部署约10.5万颗升腾910C和8000颗910B,综合折合约8.1万H100e。
8.1万H100e意味着什么?
这代表一个极大型AI训练集群的算力底座,足以支撑超大模型训练与推理。文章还指出,即便只切出其中10%的算力,也可支持万亿级MoE模型的快速预训练。
商业遥感估算算力规模靠谱吗?
可作为公开信息稀缺时的强辅助证据,但必须交叉验证:建筑面积、冷却形态、供电容量、热排放与施工进度都要对齐。单靠一项遥感结论,容易高估或低估机房真实算力。
910C折算H100e该怎么理解?
折算本质是按训练/推理能力、显存、互联和软件生态做近似换算,不是硬件一比一替代。更适合看集群总能力与任务适配度,而不是把不同架构直接当同一台机器比较。


