

💡 站外导读:在 Serverless 边缘计算与高频 AI 智能体(Agent)调用呈指数级爆发的今天,“按量付费(Pay-as-you-go)”往往伴随着让开发者胆战心惊的“账单刺客”隐患:一次死循环重试、一行未设限的递归代码、乃至突发的外部恶意爬虫刷量,都可能在数小时内蒸发数万美元预算。传统的“事后邮件告警”因无法切断流量,已彻底沦为防爆体系中的鸡肋。Cloudflare 今日正式宣布面向全网按量付费用户推出 Spend Management(支出管理)测试版,首发覆盖 Workers 与 Durable Objects,并打通 AI Gateway 模型级预算联动。该系统通过创新的两阶段流式聚合、基于账户分区的 WAL 账单引擎以及 Quicksilver 全球超低延迟异步分发架构,在完全不损耗边缘请求吞吐的前提下实现了硬性止损与动态熔断。本文将从 SRE 与系统架构视角对这一生产级计费防爆体系进行全景深度拆解。
从“事后通知”到“硬性熔断”:Serverless 与 AI 时代的账单防御困境
长期以来,在公有云与 Serverless 领域,预算管理一直存在着一道深刻的技术鸿沟:告知(Informing)绝不等于控制(Controlling)。超过 1000 万在 Cloudflare 平台上构建应用的开发者中,最普遍的痛点并非“不知道账单超支”,而是“当收到邮件通知时,高额的欠费账单已经无法挽回”。在自主 AI Agent(如智能体自动化爬虫、自我反思式多轮推理)和分布式边缘任务中,递归失控产生的调用激增往往以毫秒为单位演变为雪崩。
Cloudflare 此次推出的 Spend Management 核心突破,在于让开发者不仅能够设定渐进式警报阈值,更能定义硬性支出上限(Hard Spending Limits)。一旦账户消费达到预设警戒线,系统将自动执行阻塞策略(Blocking Policy),强制熔断业务调用。该功能首发覆盖 Workers 与 Durable Objects,并原生无缝协同 AI Gateway 的分模型、分用户级 Token 预算管理,形成从网络边缘计算到大模型推理的立体成本防护网。
声明式 API 与 CLI 编排能力
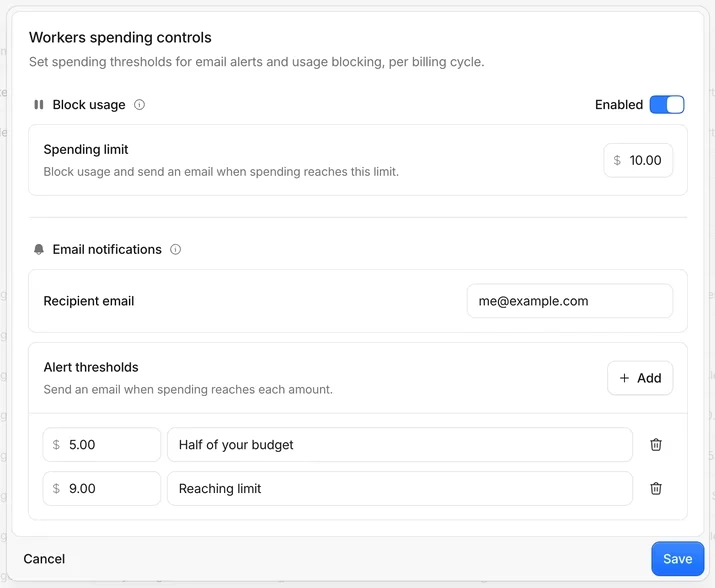
Spend Management 不仅深度集成在 Cloudflare 网页控制台中(路径:Manage Account > Billing > Spend limits),还提供标准化的 REST API 与命令行 cf CLI 支持,方便工程团队将其纳入 IaC(基础设施即代码)工作流:
# 通过 cf 命令行一键为 Workers 创建 100 美元硬性熔断策略
cf billing spend-policies create --body '{
  "name": "Workers Production Hard Cap",
  "product_id": "workers",
  "enabled": true,
  "threshold_cents": 10000,
  "action": "usage_block",
  "notification_email": "[email protected]"
}'
核心架构拆解:两阶段流式计量管道(Two-Stage Metering Pipeline)
在覆盖全球 330 多个城市的超大规模分布式边缘网络中,每一次 Worker 触发都会生成极为庞大的使用量测量数据(请求数、CPU 周期时间、内存驻留毫秒、存储读写次数)。如果将所有原始调用事件全部同步投递到中央计费引擎,不仅网络带宽成本无法承受,计费引擎也会瞬间遭遇单点崩溃。
Cloudflare 团队为此设计了优雅的两阶段边缘计量管道(Two-Stage Metering Pipeline),在数据源头就近完成高比例数据流压缩:
- 第一阶段(Stage 1: 1分钟滑动窗口粗聚合):每个边缘节点上的计量解析器(Metering Parser)就近捕获原始调用,将匹配同一账户与产品维度的指标压缩进通常为 1 分钟的时间桶(Bucket)内,将海量离散调用收敛为初步聚合度量。
- 第二阶段(Stage 2: 5分钟跨区深度归并与归档):独立的二次归并服务使用相同的分组规则,将第一阶段生成的偏序局部块按 5 分钟窗口进行全局二次合并,进一步压减向下游传输的数据量,并写入冷热持久化存储,构建不可篡改的审计与对账基线。
状态机与容灾解密:账户分区 Usage Engine 与 Rating Engine 货币化换算
经过降采样与压缩后的使用量度量流,随后被注入 Usage Engine(使用量引擎)。为了彻底消除分布式系统在高频算费时的跨节点锁协调瓶颈,Usage Engine 采用了按账户水平分区(Account-Partitioned Processing)的架构:
- 状态与订阅物理共存:同一账户的所有资源消耗指标与套餐订阅配置被严格路由至同一工作节点,无需跨服务器进行分布式一致性协调。
- 内存快照 + 预写日志(WAL):各分区保持本地内存状态以实现微秒级高速读写,同时所有状态变更以 Write-Ahead Logging(WAL)形式持久化到本地高性能磁盘,在节点宕机时可由新副本秒级重放恢复。
解耦使用流与订阅流的 Rating Engine
计费引擎的核心任务是回答:“基于该账户已消耗的指标和当前订阅,实时折算产生了多少货币金额?”。在实际生产环境中,使用量上报事件与用户修改订阅的 Webhook 往往异步到达且存在时间乱序。Cloudflare Rating Engine 引入了创新的挂起机制(Pending State):若使用量数据早于套餐变更到达,系统暂存该片段并待订阅生效后回溯定级,既防止免费漏洞,又避免误熔断。此外,系统始终先全量抵扣账户包含的免费配额(Included Allowance),再对超额部分执行累计批量算费,彻底根除了按单次请求四舍五入造成的累计金额失真。
微秒级零损耗拦截:Quicksilver 全球分布式配置下发的 SRE 实践
对于主打极致性能的边缘网络而言,一个绝对的 SRE 架构铁律是:计费判定绝对不能插入到 HTTP/TCP 请求的主路径(In-Path)中!若每次客户端请求都必须等待中心 Rating Engine 鉴权,全球数以千万计的请求时延将遭受灾难性劣化。
Cloudflare 采用了极度高明的“异步广播 + 本地快速拦截”方案:
- Quicksilver 全球极速广播:一旦策略服务判定触发 Cap 熔断,指令被直接写入 Cloudflare 内部自研的高性能键值存储 Quicksilver。Quicksilver 具备行星级的跨机房复制能力,能在数秒内将限额标志推送至全球每一个边缘 PoP 节点。
- 边缘运行时周期刷新:边缘 Worker 运行时在周期性轮询中捕获 Quicksilver 中的阻断标记并缓存在本地内存中。后续请求到达时,Worker 仅需做一次本地只读内存检查,以零时延开销拒绝新的执行。
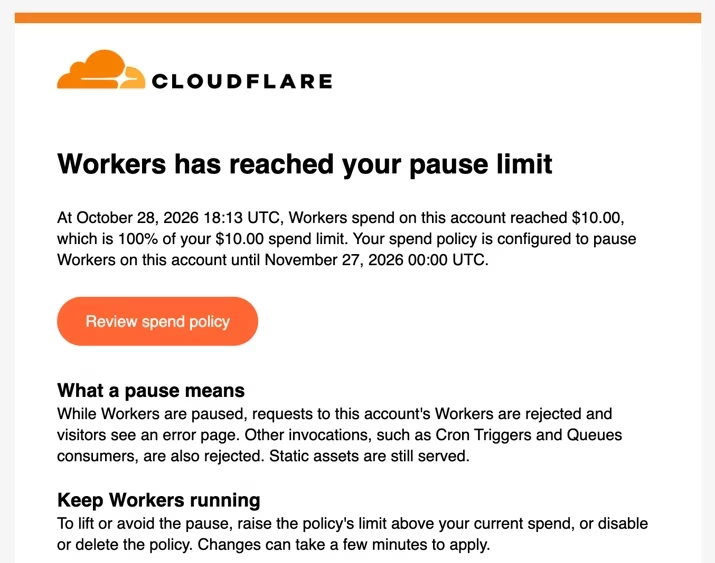
- 精细化差异阻断:系统执行阻断策略时展现出高度工程克制——仅暂停产生计费的代码执行(如客户自定义 Worker、Cron Triggers、Queue Consumer),而全站的静态资源(Static Assets)与缓存分发继续正常伺服,有效保护了业务前端的可用性底线。
主流云平台支出控制与熔断机制对比
为了直观评估 Cloudflare Spend Management 的技术代差,下表汇总了主流云基础设施在防爆账单机制上的核心维度对比:
| 对比维度 | Cloudflare Spend Management | AWS Budgets & Actions | Google Cloud Quotas |
|---|---|---|---|
| 控制模式 | 硬性阻断熔断 (Hard Cap) | 需搭配 IAM 策略/Lambda 自建动作 | 配额硬限 / 计费警报仅通知 |
| 数据感知时延 | < 10 分钟 (演进目标 < 1 分钟) | 8 ~ 24 小时账单延迟 | 数小时至次日汇总 |
| 主请求链路影响 | 零时延损耗 (Quicksilver 异步下发) | 无影响 (事后动作) | 无影响 (事后通知) |
| 边缘局部容灾 | 保留静态资产与缓存伺服 | 若关闭实例全站彻底瘫痪 | 配额耗尽直接拒绝服务 |
| AI 基础设施联动 | 原生协同 AI Gateway 分模型预算 | Bedrock 需额外集成 CloudWatch | Vertex AI 需自建计费 Export |
📝 站长洞察 (Editor’s Insight)
Cloudflare 本次上线的 Spend Management 不仅是开发体验的一次关键补完,更树立了现代边缘计算计费架构的 SRE 范本。很多公有云服务商之所以迟迟不肯推出“硬性限额自动熔断”,往往夹杂着商业利润与技术难度的双重考量:在分布式全球网络中,在毫秒级处理请求的同时进行强一致性全局计费几乎是不可能的三角悖论。Cloudflare 巧妙利用“异步下发(Quicksilver KV)+ 账户分区 WAL + 优雅部分降级(仅拦截计费代码、保留静态服务)”的解耦架构,既保证了主站千万级 QPS 的零时延侵入,又将熔断延迟稳稳控制在 10 分钟以内(未来演进至 1 分钟内)。对于正在拥抱多 Agent 自主工作流与高吞吐 Serverless 架构的工程团队而言,将此类硬性阈值固化到基础设施声明式代码中,是避免业务遭遇‘破产级账单刺客’的第一道生死底线。
Cloudflare Spend Management 主要解决什么问题?
它主要解决 Serverless 和 AI 调用场景中的“账单刺客”问题。系统不只做超支提醒,还能设置硬性支出上限,一旦达到阈值就自动阻塞相关服务调用,避免预算在短时间内被异常流量或失控重试迅速耗尽。
两阶段流式计量有什么作用?
两阶段流式计量用于把全球边缘节点产生的大量原始使用数据先在本地做 1 分钟粗聚合,再进行 5 分钟跨区深度归并。这样既减少传输和中心计费压力,也为后续审计、对账和计费提供更稳定的数据基线。
Spend Management 支持哪些产品和接入方式?
文章明确提到首发覆盖 Workers 与 Durable Objects,并与 AI Gateway 的模型级预算联动。接入方式包括 Cloudflare 控制台、REST API 和 cf CLI,便于纳入 IaC 和自动化运维流程。
两阶段流式计量如何避免误封?
先在请求路径做轻量预估与累积,再在账单侧做精确结算与回补,二者分离可降低延迟和抖动。关键是设置安全缓冲、幂等扣减与回滚通道,避免短时峰值把正常流量误判为超支。
WAL加Quicksilver为何适合近实时止损?
WAL负责把账务变更顺序化、可恢复地落盘,Quicksilver负责把熔断状态快速广播到全球边缘。前者保证一致性与可审计,后者保证传播速度;组合起来才能在高吞吐下实现分钟级甚至更快的止损。


