

💡 站外导读:在消费级 AI 助手被泛滥的常识问答和代码编写占满时,科技巨头苹果选择了一条极其克制却壁垒森严的硬核道路——循证医学(Evidence-Based Medicine)。苹果正式宣布与权威医疗 AI 企业 OpenEvidence 达成战略合作,面向美国全境启动了一项覆盖 20 万名受试者、长达 12 个月以上的真实世界健康 AI 研究。用户不仅能获得基于顶尖临床文献支撑的严谨解答,还能安全接入自身 HealthKit 生理指标。通过严苛的端侧脱敏与 24 小时即刻销毁策略,苹果正在为下一代深度整合进 Apple Intelligence 的医疗级数字助理铺平临床与法规道路。本文全景拆解其技术架构与安全范式。
医疗健康领域一直被公认为生成式人工智能最难攻克、同时也最具社会价值的“深水区”。与写诗作画或代码辅助不同,健康咨询对幻觉(Hallucination)采取零容忍态度,任何凭空捏造的用药建议或病因推论都可能导致灾难性的后果。正因如此,面对全行业大干快上推出各种“医疗大模型”的浮躁风气,苹果公司选择了一条极其审慎且严谨的路径。
今天,苹果正式宣布与全美顶尖医疗临床 AI 领军机构 OpenEvidence 建立深度研发合作,正式向全美用户开放下载一款专项健康领域 AI 研究应用(Health AI Research App)。苹果计划为该项目招募多达 20 万名真实参与者,展开历时超过 12 个月的长期前瞻性队列研究,旨在系统评估人工智能在真实世界中基于临床循证医学为普通公众提供健康信息与决策辅助的准确性与安全边界。
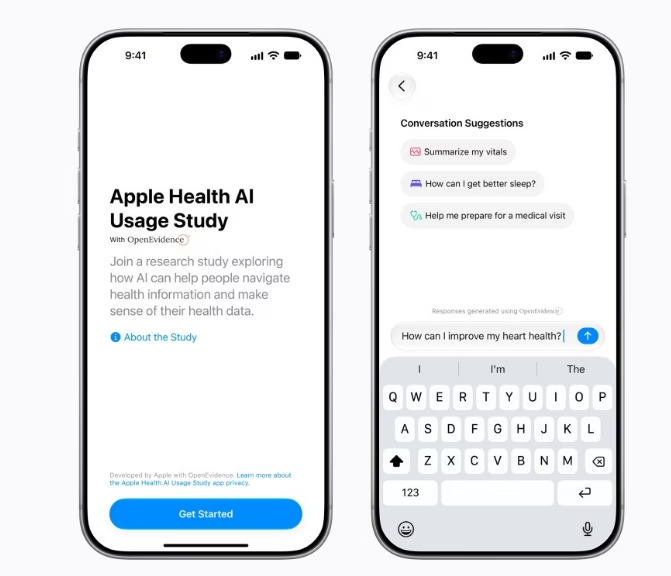
一、20 万人宏大试验:参与门槛与硬核循证知识库架构
为了保障研究所收集数据的统计学严谨性与临床真实性,苹果设立了清晰的准入标准:参与者必须年满 21 岁、现居住于美国,手持设备必须为 iPhone 15 或更新机型,系统版本升级至 iOS 26 或更高版本,并且必须原生开启 Apple Intelligence 核心能力。
与市面上普遍采用通用互联网公开语料训练的聊天机器人存在本质差异,这款应用背后的 RAG(检索增强生成)医学知识库经过了极其严苛的同行评审文献筛选:
- 权威循证医学库全量索引:回答内容绝不依赖未经核实的大众网页百科,而是深度接入并锚定自《新英格兰医学杂志》(The New England Journal of Medicine, NEJM)、《美国医学会杂志》(JAMA)以及《自然》(Nature)等全球顶尖医学同行评议期刊与临床诊疗指南;
- 文献溯源与证据链透明化:当用户提出类似“服用某类降压药期间出现干咳是否常见?”等复杂问题时,模型不仅给出通俗易懂的解答,还会像医学研究报告一样,直接附上支撑该结论的临床试验样本量、发表年份与置信区间来源;
- 在环交互反馈闭环:参与者不仅可以对每一个回答的事实清晰度与可操作性进行逐题打分,还需定期参与由临床专家制定的月度问卷调查,为算法持续对齐与误差修正提供高质量的人类临床反馈强化学习(RLHF)数据。
二、打通 HealthKit:从静态问答跃迁至多维生理动态洞察
这款研究应用最具突破性的一环,在于其获得了与 iOS 原生 HealthKit(健康套件)的深度接口联动权限(完全基于用户知情同意与主动授权)。
用户可以选择将个人在日常生活中积累的真实生理指标授权共享给研究系统,包括:
- Apple Watch 监测数据:静息心率变异性(HRV)、最大摄氧量(VO2 Max)、日间活动消耗与步频步态;
- 睡眠与周期健康:分期睡眠结构(REM/深睡/浅睡)、睡眠呼吸暂停风险提示以及夜间体温偏差;
- 化验与病历结果:用户主动录入或通过合作医院同步的血常规、血脂血糖化验单指标。
在结合了这部分生理指标后,AI 不再是一个泛泛而谈的“医学教科书”,而是能够根据用户当前的生理指标偏离情况,提供极具个性化的问诊准备(Doctor-visit Preparation)与医疗专科方向指引,帮助患者在走进医院前清晰梳理自身症状的时间线与关键化验异常。
三、零信任隐私防线:端侧脱敏与 24 小时生命周期销毁
在涉及敏感健康数据时,苹果展现出了行业天花板级别的 SRE 级隐私隔离架构设计。为了彻底消除公众对隐私泄露的顾虑,整套数据流转遵循如下不可逆规则:
| 数据防护层级 | 物理技术实施方案 | 合规与安全保障效果 |
|---|---|---|
| 端侧设备级匿名化 | 在用户提问离开 iPhone 发往云端前,设备本地完成 PII(个人身份信息)剥离,使用轮换临时虚拟 ID | 即使传输信道被截获,外部亦无法将健康数据与具体 Apple ID 或真实自然人关联 |
| 零训练模型保护 | 苹果与 OpenEvidence 签订法律与加密硬性协议:全量交互请求严格禁止用于任何 AI 模型的二次训练或权重更新 | 杜绝发生训练集污染或通过逆向工程从模型参数中套取受试者病历信息 |
| 临时内存 24h 销毁机制 | OpenEvidence 云端处理服务器被配置为瞬态计算节点,交互响应生成后启动严格的 TTL 倒计时,24 小时内物理擦除全部查询与上下文日志 | 杜绝第三方服务商构建持久化用户档案数据库,符合 HIPAA 及全球最高级别医疗隐私规范 |
| 安全隔离区硬件根 | 涉及与 HealthKit 交互的加密密钥完全固化在 A17/A18/M 系列芯片内置的 Secure Enclave 硬件模块中 | 防止操作系统层面的越狱或恶意软件旁路窥探健康密钥 |
四、苹果的战略大棋:为什么不做面向大众的“快餐式医生助手”?
行业分析师注意到,苹果此次并未仓促地在 iOS 中直接上线一个名为“Apple Doctor”的大众功能,而是耐心地启动为期一年的临床科研。这背后折射出蒂姆·库克(Tim Cook)多次强调的“健康将是苹果对人类最大贡献”的战略定力。
医疗不同于通用消费,它需要经过 FDA(美国食品药品监督管理局)等监管机构严苛的软件作为医疗器械(SaMD)审查。苹果通过与 OpenEvidence 的联合研究,实际上是在完成三大战略储备:
- 获取金标准临床对齐语料:真实用户面对疾病时的提问往往口语化且充斥焦虑,通过 20 万人的真实交互与专业文献校准,能够打磨出抗噪能力极强的医疗级前置语义解析模型;
- 验证 HealthKit 多模态数据的诊断辅助价值:以往的可穿戴设备数据多停留在“展示走势图”,通过本次试验,算法将探索心率变异性与呼吸节律在大模型上下文中的推理能力;
- 为未来的具身与环境感知医疗奠定基石:随着苹果代号为 N50 的 AI 智能眼镜以及未来智能家居中枢的发展,具备临床循证底蕴的医疗智能体将无缝融入日常生活,实现真正的主动预防与健康守护。
📝 站长洞察 (Editor’s Insight)
苹果在医疗 AI 上的这步落子,给整个被虚火裹挟的科技行业上了一堂生动的“工程克制课”。当几乎所有初创公司都在用开源大模型套壳“全科 AI 医生”试图赚快钱时,苹果选择联合顶级科研机构,以 20 万人为样本、以主流医学期刊为边界、以 24 小时物理销毁为隐私底线,踏踏实实做临床前瞻试验。在事关生命健康的严肃赛道,没有捷径可走。谁能最先通过科学实证拿到严苛的监管准入和大众信任,谁才能在万亿规模的下一代个性化医疗健康市场中建立无法被颠覆的生态护城河。
苹果健康AI应用和普通聊天机器人有什么区别?
它不是依赖泛互联网语料的通用聊天机器人,而是基于 NEJM、JAMA、Nature 等同行评议文献与临床指南做检索增强回答,强调证据来源、可追溯性和医疗场景下的低幻觉风险。
HealthKit 数据会被用来训练模型吗?
文章提到的机制是“零训练模型保护”:苹果与 OpenEvidence 约定,交互请求不得用于任何模型二次训练或权重更新;同时还采用端侧脱敏与临时日志 24 小时销毁,降低隐私风险。
谁可以参与这项健康AI研究?
根据文中信息,参与者需年满 21 岁、居住在美国,设备为 iPhone 15 或更新机型,系统需升级到 iOS 26 或更高版本,并原生开启 Apple Intelligence。
HealthKit 端侧闭环怎么落地最稳?
优先把敏感数据留在本地做特征提取与短时缓存,云端只接收最小必要上下文;再配合脱敏、24小时自动销毁和零训练策略,才能把合规风险压到可控范围。
循证文献驱动的医疗AI如何避免幻觉?
不要让模型自由生成诊断结论,而是把 NEJM、JAMA 等证据库做成可追溯检索层,输出时强制引用来源、置信度和适用边界,并在高风险场景加入人工复核。


