

💡 站外导读:科学研究长期受困于“算力时间剪刀差”:超大型设备时刻产生PB级实验数据,但传统仿真管线动辄数周才能输出。SC26大会期间,NVIDIA扩展CUDA-X科学计算库矩阵,推出cuPhoton、cuPotential与开源cuSpa等核心引擎,并首度全面封装为“Agent-Ready”工具链,让黑洞重建缩至8分钟,更使AI智能体得以在线接管核聚变与电镜实时调控。
一、 cuPhoton 改写天体物理与核聚变:黑洞重建缩至 8 分钟,Nemotron 智能体在线操盘仿真
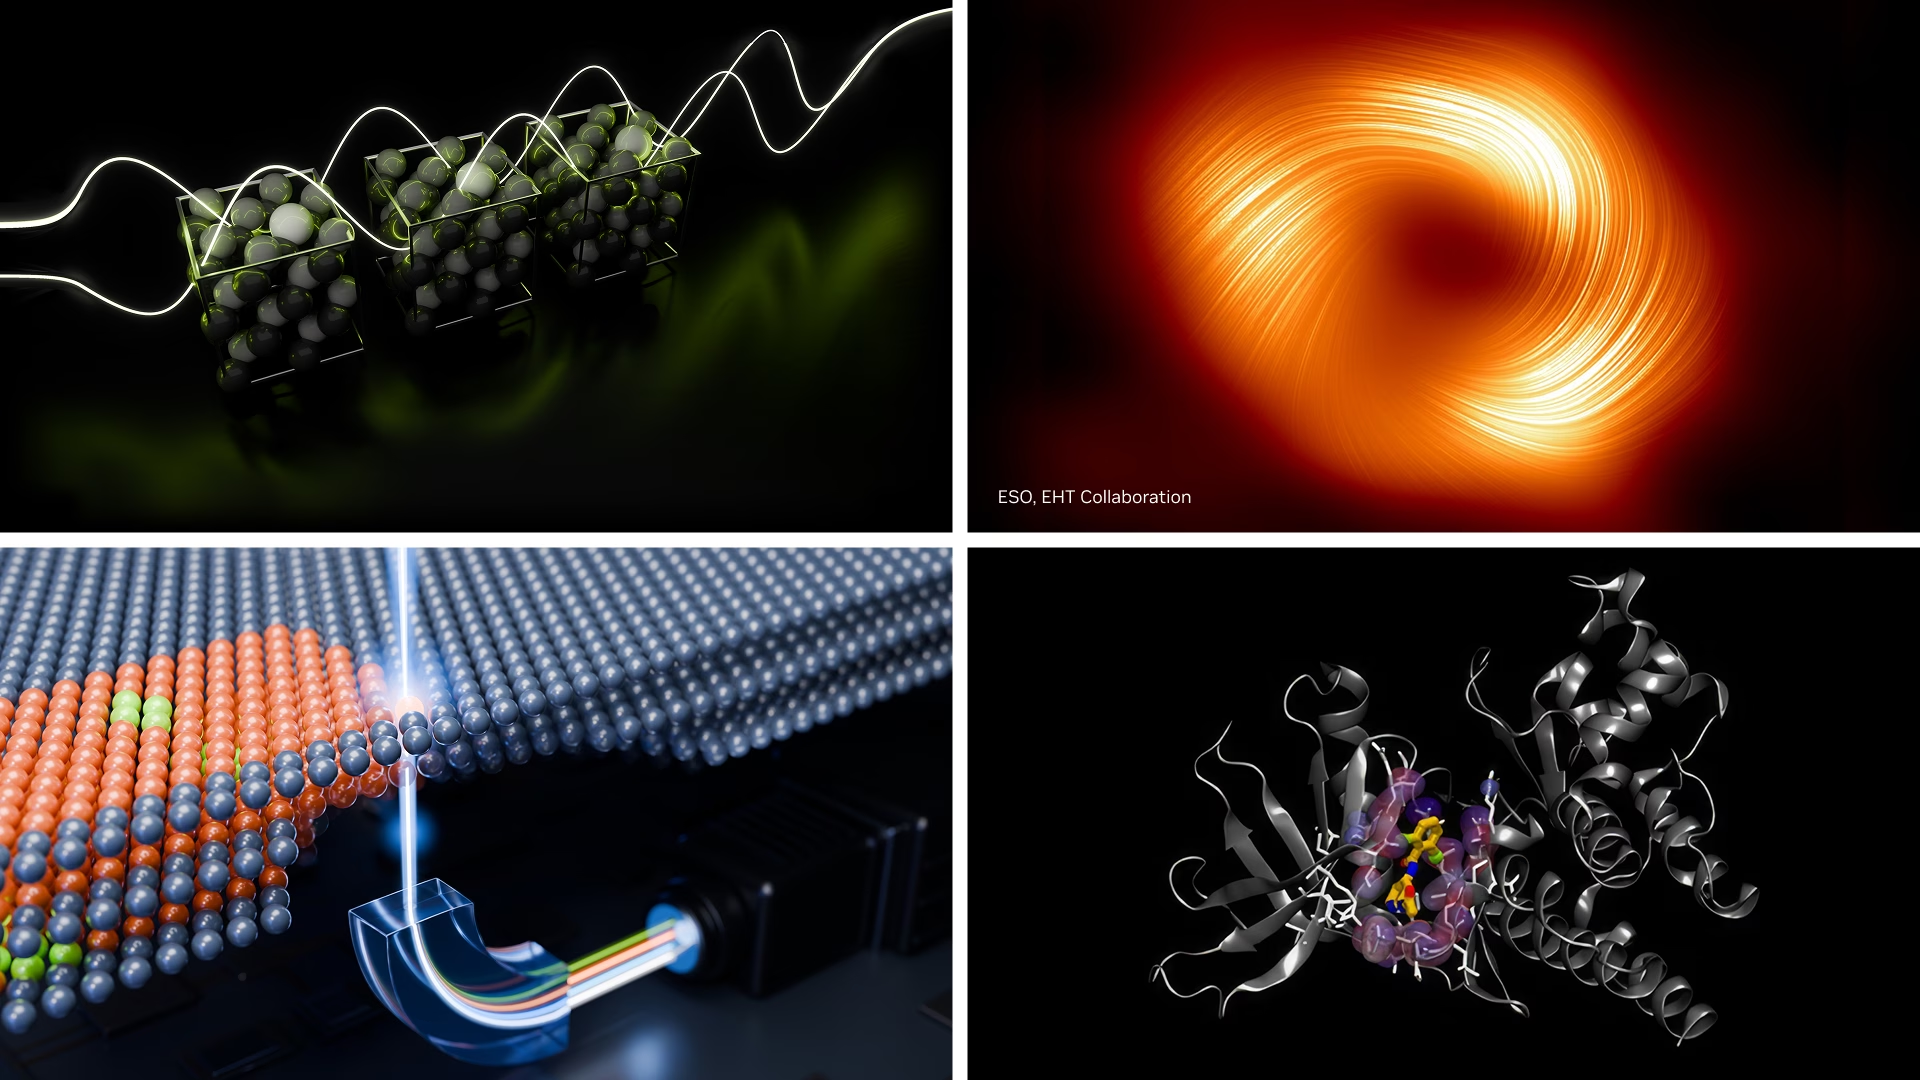
观测一颗黑洞需要一台“地球大小”的虚拟望远镜。事件视界望远镜(EHT)串联全球射电天文台,单次观测便会产生数 PB 的海量干涉数据,过去相关联计算往往耗时一个多月。借助全新 cuPhoton 工具包中的 cuPhoton.xBeam 模块,这套从数据加载、干涉关联到最终可视化的完整管线,现已能将分析耗时从逾一个月压缩至短短 8 分钟。
凭借这一数量级跨越,科学家不仅成功关联了 J1924 与 3C279 等高能黑洞喷流观测数据,更实现了对 Messier 87* 星系黑洞周围气体螺旋吸入状态的实时重建。更令人瞩目的是,该全套流水线既可在分布式多 GPU 集群扩展,也能直接浓缩运行在一台桌面级的紧凑型 NVIDIA DGX Spark 系统中。
而在可控核聚变领域,维持数百万度高温的等离子体极为棘手:在千万亿次(Petascale)超算上推进一个仿真时间步就可能耗时数天,整场模拟动辄持续数周。Pacific Fusion 的研究团队引入了 cuPhoton.xLens 模块,彻底打破“必须等模拟结束才能分析结果”的僵局,实现了计算运行中的在线洞察提取。研究人员更可将该管线与本地运行的 NVIDIA Nemotron 驱动智能体直接耦合,由智能体与人类科学家协同实现交互式在线参数引导(Interactive Steering),即时反哺聚变反应堆靶丸与腔室设计。
二、 量子化学与原子材料突破:cuPotential 提速 3 倍,Daviator 令 VASP 计算降本 75%
在生物医药与材料模拟领域,计算精度与吞吐成本往往不可兼得。基于西蒙斯基金会熨斗研究所(Flatiron Institute)与 D. E. Shaw Research 前沿成果打造的 NVIDIA cuPotential,在提升分子动力学计算数值稳定性与精准度的同时,将既有主流模拟软件提速最高达 3 倍,加速挖掘未知分子结合位点并评估结合强度,同时为生成式 AI 药物模型批量产出高质量合成数据。
目前 NVIDIA 正与薛定谔(Schrödinger)以及 AMBER、NAMD、GROMACS、LAMMPS 和 Open Molecular Software Foundation 等核心社区展开集成,Cadence、Fathom Therapeutics、Topos Bio、Genesis Molecular AI 及 Terray Therapeutics 等公司已将其投入一线新药研发管线。
面向材料科学中的量子力学第一性原理计算,NVIDIA ALCHEMI 即将上线批处理 GPU 内核集合 Daviator。针对业界广泛使用的 VASP(维也纳从头算模拟包),Daviator 可带来最高 22 倍的加速以及高达 75% 的计算成本降幅——甚至连以往公认“跑在 CPU 上更快”的小尺度原子系统,如今也能通过批处理内核实现 GPU 全面反超。同时,劳伦斯伯克利国家实验室(LBNL)利用 NVIDIA DAQIRI 网络库将高速电子显微镜探测器直连 GPU 内存,让 AI 在原子分辨率扫描进行的同时识别感兴趣区域并自主决策“下一步测哪里”,为全自动无人实验室铺平道路。
三、 NVIDIA CUDA-X 新一代科学计算库与 AI 智能体赋能指标全景矩阵
本次 NVIDIA 发布的 CUDA-X 矩阵覆盖天体物理、核聚变、药物分子、量子材料与单细胞空间组学五大核心科学赛道,实测加速比与架构特性汇总如下:
| 核心模块 / 库名称 | 所属科学领域 | 关键技术机制与生态集成 | 实测加速比 / 关键收益 | 标杆合作与落地机构 |
|---|---|---|---|---|
| cuPhoton.xBeam | 射电天体物理 | 端到端 GPU 射电干涉关联与成像,支持 DGX Spark 桌面运行 | PB 级黑洞重构从 1 个多月压缩至 8 分钟 | 事件视界望远镜 (EHT) M87* 实时成像 |
| cuPhoton.xLens + Nemotron | 可控核聚变仿真 | 仿真运行态实时特征抽取,本地耦合 Nemotron Agent 交互调参 | 打破数周离线等待,实现等离子体仿真在线实时引导 | Pacific Fusion 反应堆靶丸与腔室设计 |
| cuPotential | 分子动力学 / 制药 | 融合 Flatiron 与 D. E. Shaw 算法,接入 AMBER/GROMACS/LAMMPS 等 | 模拟提速最高 3 倍,显著增强计算稳定性并产合成数据 | Schrödinger, Cadence, Terray Therapeutics |
| Daviator (ALCHEMI) & DAQIRI | 量子材料 / 高速电镜 | VASP 批处理 GPU 内核;电镜探测器直连 GPU 在线自适应采样 | 量子力学计算提速 22 倍、降本 75%;小原子系统反超 CPU | 劳伦斯伯克利国家实验室 (LBNL) |
| cuSpa / rapids-singlecell / GPU-HMMER | 空间单细胞 / 蛋白组学 | 开源细胞多边形计算与单容器 Agent-Ready 环境;蛋白序列加速注释 | cuSpa 提速 900 倍;单细胞处理快 200 倍;HMMER 提速 84 倍 | MSKCC 癌症中心, Therna, 10x Genomics, Basecamp |
四、 生命科学开源矩阵爆发:cuSpa 狂飙 900 倍,单容器 Agent-Ready 重塑生信生态
在生命科学与生物基础模型训练底座上,NVIDIA 此次一口气释放了多项硬核开源利器与容器化方案。全新开源的 cuSpa 专门攻克大规模空间转录组中的细胞多边形(Cell Polygon)计算瓶颈,助力纪念斯隆-凯特琳癌症中心(MSKCC)构建下一代患者与癌症空间图谱,相比传统 CPU 计算实现了惊人的 900 倍性能飞跃。
在单细胞分析侧,NVIDIA 与 scverse 联合开发的 rapids-singlecell 框架已正式封装为单一的 “智能体就绪(Agent-Ready)”容器镜像,AI 智能体无需繁琐环境配置即可直接拉起容器调度算力。借助该框架,Therna Biosciences 将治疗设计的数据处理速度提升了 200 倍;10x Genomics 也已将其深度集成至全新 Sentira 平台,大幅缩短学术界与生物制药团队从空间原始数据到生物学洞察的周期。
此外,针对生物基础模型海量蛋白序列数据预处理难题,NVIDIA 同步开源了 GPU 加速版 HMMER 库。在 Basecamp Research 的实际基准测试中,预测蛋白序列的同源注释搜索速度较标准 CPU 版 HMMER 提升最高达 84 倍,为千亿级生命科学基座模型扫清了最耗时的数据清洗障碍。
📝 站长洞察 (Editor’s Insight)
NVIDIA在SC26亮出的CUDA-X矩阵暴露了比单卡算力更深的护城河:它正把“批处理、跑完等结果”的传统超算,改造成“在线交互、Agent实时接管”的科学智能闭环。无论是cuPhoton.xLens挂载本地Nemotron智能体干预核聚变,还是rapids-singlecell打包为单容器Agent-Ready镜像,都在印证同一工程规律:未来的AI4S智能体绝不是只会在对话框编论文,而是通过标准化容器与极速GPU内核直接接管VASP、GROMACS与电镜的实时控制权。对国内科研算力底座而言,专有计算内核的GPU化与容器化封装才是真正的决胜高地。
cuPhoton主要解决什么问题?
cuPhoton面向射电天体物理与核聚变等高吞吐科学计算,核心价值是把原本需要长时间离线处理的管线改造成可实时分析的GPU流程,代表性结果是黑洞重建从1个多月缩短到8分钟。
Nemotron在这篇文章里怎么用?
Nemotron被用作本地运行的AI智能体,与cuPhoton.xLens耦合后,可在核聚变仿真运行过程中实时提取特征、辅助判断并进行交互式参数引导,而不是等模拟结束后再分析。
Daviator对VASP有什么提升?
Daviator是面向材料第一性原理计算的批处理GPU内核集合,针对VASP可实现最高22倍加速,并将计算成本降低最多75%,尤其改善了以往小尺度原子系统在GPU上的效率表现。
Agent-Ready链路怎么接入现有科研流程?
先把仿真、数据预处理、参数搜索和结果校验拆成可调用工具,再由智能体做调度与异常回退。关键是保留人工审批点、日志追踪和可复现实验配置,避免“自动化黑箱”直接进生产。
8分钟重建这类提速如何验证可信度?
要看同等精度指标下的端到端对比:数据规模、硬件配置、收敛阈值和后处理是否一致。最好补充多次重复实验、误差分布和失败案例,否则单次跑分很难证明可迁移到真实科研场景。


