

💡 站外导读:传统的音频驱动人像生成算法往往陷入两难困境:要么依赖沉重的像素级扩散模型(Diffusion),单帧生成耗时以秒计、算力开销巨大且伴随面部特征漂移;要么虽然能实时推理,但口型动作千篇一律、生硬机械,完全丧失了真人在真实说话时的微表情与习惯性动作。中科院自动化所最新开源的端到端框架 TalkLikeYou 凭借“运动空间两阶段建模”与“单步 Flow Matching 采样”,成功破局:只需一张人像照片和一段音频,不仅以 32.43 FPS 的吞吐达成极速流式生成,更首次实现了对目标人物专属说话习惯的高保真复刻!
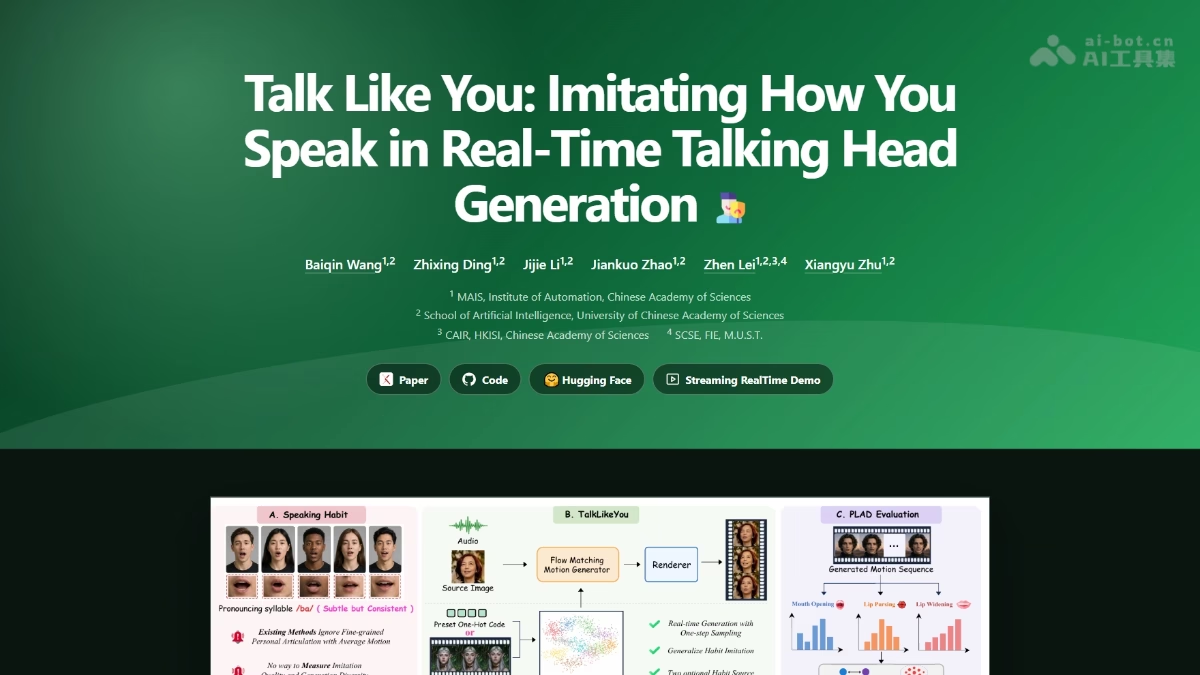
一、技术核心:运动空间两阶段与单步 Flow Matching
相较于目前行业内主流的纯像素扩散模型(如 SadTalker、EchoMimic、Sonic 等),TalkLikeYou 团队在系统架构设计上做出了极具工程前瞻性的取舍:拒绝在庞大的像素图像空间内直接做逐帧去噪,而是将动作生成下沉到轻量级的低维运动参数空间(Motion Space)。
1. 运动空间两阶段生成流(Two-Stage Paradigm)
- 阶段一:轻量运动特征解耦:模型首先将输入的单张人像照片解析为结构化的人脸运动关键参数与拓扑几何表示。音频信号通过跨模态融合机制,在这组低维运动数字空间上高效预测和拟合面部微动态。
- 阶段二:专用神经渲染器合成:当运动序列生成完毕后,再交由预训练好的紧凑图像渲染器无缝映射回高分辨率连续视频。由于身份外貌由静态照片锚定,渲染器无需参与复杂时序发散运算,彻底保障了长时生成过程中的人物身份一致性与面部结构不失真。
2. 一步 Flow Matching 采样(Single-Step Sampling)
为了攻克多步迭代扩散导致的严重延迟,TalkLikeYou 引入了 Flow Matching(流匹配) 机制,学习从高斯先验噪声到目标运动分布的最优直线向量场。配合创新的重参数化技巧,算法直接单步预测干净的连续运动参数,跳过了传统 30~50 步的冗长采样流程。在实测中,单步采样的唇音对齐精度(Sync-C)高达 8.73,以极低的计算负载跑出了 32.43 FPS 的超实时表现,完全满足端到端实时音视频双工交互需求。
二、专属习惯复刻:统一习惯空间与 PLAD 量化指标
在过往的数字人方案中,“口型对齐”通常演变为模型在海量人脸数据集上拟合出的“数学平均嘴”,丧失了真人的个性化细节(例如特定音节的抿嘴习惯、嘴角上扬幅度或说话偏向)。TalkLikeYou 在业内首次将“个人说话习惯”提升为一等公民进行显式建模:
| 对比技术维度 | TalkLikeYou(中科院自动化所) | SoulX-LiveAct(Soul AI Lab) | 传统 Sonic / MimicTalk |
|---|---|---|---|
| 核心技术路线 | 运动空间两阶段 + 一步 Flow Matching | 自回归扩散(AR Diffusion 像素级) | 多步扩散模型(Diffusion) |
| 生成帧率 (FPS) | 32.43 FPS(单卡 RTX 3090) | 20 FPS(双卡 H100/H200) | < 1 FPS(慢速离线渲染) |
| 显存消耗阈值 | < 4GB 显存畅跑 | 需企业级大显存多卡集群 | 12GB~24GB |
| 个人说话习惯复刻 | ✅ 独创统一习惯空间(支持 4 秒视频即时克隆) | ❌ 不建模个性化嘴部习惯 | 部分支持但需重训微调 |
| 习惯保真度指标 PLAD | 0.62(业内领跑) | 未设立指标 | 0.39 ~ 0.48 |
研究团队构建了一个支持连续插值的低维习惯向量空间,将真实人物的嘴部微运动投影为张嘴幅度(Openness)、嘴唇收拢度(Rounding)与嘴角拉伸(Spreading)三大正交发音轴,并首次提出了量化习惯相似度的 PLAD 评估指标。更令人振奋的是,该框架支持双入口定制:
- 预设标号零开销切换:用户可直接通过预设的 ID 参数(如
--person-id 192)一键调用对应名人的说话习惯。 - 任意参考视频免训练秒学:只需传入一段 4 秒钟(100 帧以上)的真人说话片段,模型通过内置的习惯提取器即可当场完成风格编码,甚至支持对多种习惯进行权重线性插值,合成出独具特色的全新表达风格。
三、工程落地与私有化部署实操
TalkLikeYou 官方项目已在 GitHub 与 HuggingFace 完全开源了全部代码和预训练权重。得益于极轻量级的运动空间设计,开发者甚至可以在配备消费级显卡(如 RTX 3060/4060,显存大于 8GB 即可满足编译与推理)的 Linux 工作站上快速构建专属服务:
# 1. 克隆代码仓库并配置 Python 3.10 环境
git clone https://github.com/BQ-Wang0511/TalkLikeYou.git
cd TalkLikeYou
conda env create -f environment.yaml
conda activate talklikeyou

# 2. 拉取开源预训练权重
hf download doubi-killer/TalkLikeYou --local-dir ./checkpoints

# 3. 极速单步流式推理测试 (以 1 步采样驱动本地照片)
python -m talklikeyou   --source ./demo/avatar.png   --audio ./demo/speech.wav   --person-id 192   --sampling-steps 1   --output ./output/result.mp4

# 4. 视频嘴部重配音模式 (保留原有头部姿态,替换嘴形适应多语言出海)
python -m talklikeyou   --source ./demo/origin_video.mp4   --audio ./demo/spanish_audio.wav   --pose-mode source   --sampling-steps 1   --output ./output/dubbed.mp4
📝 站长洞察 (Editor’s Insight)
过去一年,AI 数字人赛道历经了从“高保真离线渲染”到“高可用实时交互”的深刻洗牌。在电商虚拟主播、多语言视频出海译制以及智能客服坐席等高频落地场景中,行业真正需要的从来不是昂贵、臃肿且动辄需要数张 H100 集群驱动的百亿参数模型,而是能够在边缘节点或廉价云主机上稳定跑满 30+ FPS、显存小于 4GB 的工程化利刃。中科院自动化所 TalkLikeYou 的开源,在技术路径上证明了:通过将复杂的物理发音特征解耦到运动参数空间,配合数学上更为精炼的 Flow Matching 单步采样,完全能够兼得“毫秒级低延迟”与“高拟真个性化”。这一突破将极大加速数字人在本地端侧与多语言出海管线中的普及进程。


