

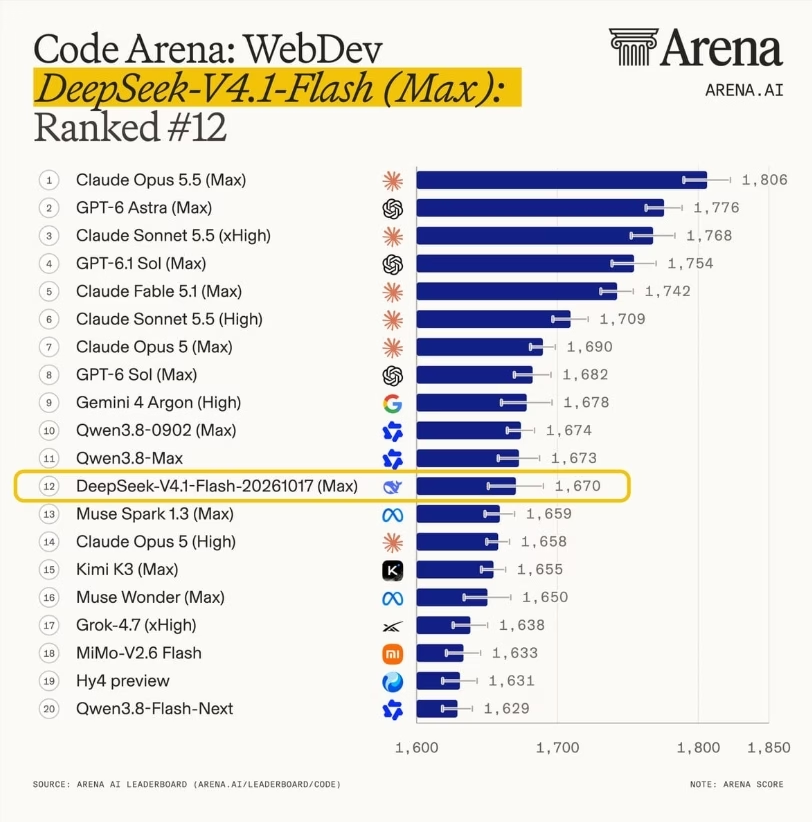
💡 站外导读:开源大模型与代码智能体领域再次迎来里程碑级技术突破!在权威代码评测机构 Code Arena 最新公布的全球 WebDev 网页与全栈开发评测榜单中,DeepSeek 团队最新推出的优化迭代版本 DeepSeek-V4.1-Flash-20261017(Max)以极具统治力的技术表现强势登顶,正式摘得“全球第一开源代码模型”桂冠。更为震撼的是,在击败一众闭源与开源强手的同时,其真实推理调用成本仅为同梯队商业模型的十分之一,以每百万输入 Token 仅 0.3 美元的定价,重构了开发者眼中的帕累托最优边界。
一、 性能与成本的双重爆破:WebDev 登顶全球第一开源模型
在严肃代码工程与现代 Web 交互开发场景中,模型的真实可用性不仅取决于语法生成的正确率,更依赖于上下文长程依赖保持、复杂前后端框架联动理解以及高并发下的响应时延。Code Arena 官方的最新评测数据显示,DeepSeek-V4.1-Flash-20261017(Max)在涵盖组件状态流转、CSS 响应式布局、REST/GraphQL 接口契约编排等高难度实测项目中表现抢眼,综合得分一举反超了此前长期领跑的 Kimi K3(Max),以无可争议的优势登顶 WebDev 专项榜单首位。
在总榜全球天梯排位中,该版本以 1670 分的优异成绩跃居全网总榜第 12 名。在这一顶级闭源与万亿模型盘踞的高位区间,DeepSeek-V4.1-Flash 不仅大幅领先于知名商业闭源模型 Claude Opus 5(High),更将自身与行业顶峰 GPT-6Sol(Max)的得分差距收窄至 10 分以内,彻底打破了“轻量化模型在复杂系统开发中难当大任”的行业偏见。
二、 技术底座与优化解析:单月提升 52 分与极致精简策略
根据 DeepSeek 官方发布的技术说明,本次推送的 1017 版本并非小修小补,而是围绕底层强化学习(RL)反馈回路与投机解码管线开展的深度重构。相较于仅一个月前(2026 年 9 月 10 日)推出的基线版本,新模型在基准评测中实现了 52 分的惊人净增幅。
研发团队在本次优化中重点攻克了以下核心技术瓶颈:
- 思维链冗余消除与压缩:在复杂多步骤推理中,模型往往容易陷入过度解释或生成无效模板代码的陷阱。新架构通过对代码语义图的深度注意力蒸馏,在确保 100% 严谨执行的同时,显著精简了冗余 Token 输出,使复杂全栈任务的平均生成时长缩短约 35%。
- 低成本极限商业化定价:在性能逼近行业天花板的同时,DeepSeek 依然坚守了普惠开发者的战略定价:输入每 100 万 Token 仅收 0.3 美元(约 2 元人民币),输出每 100 万 Token 仅收 1.2 美元(约 8 元人民币)。该定价仅为业内同性能顶级闭源模型的十分之一甚至更低。
- 长程上下文代码状态保持:针对巨型前端工程的多文件依赖关系,模型增强了跨模块 import 跟踪与类型推断能力,有效杜绝了因上下文抖动导致的“代码越改越乱、依赖前后冲突”的顽疾。
三、 顶级代码模型性能与调用成本多维横向对标
为了全面呈现 DeepSeek-V4.1-Flash-1017 的工业级竞争力,我们将其与当前全球主流编程大模型在核心能力与使用成本维度进行了横向矩阵对标:
| 对比维度 | DeepSeek-V4.1-Flash-1017 | Kimi K3 (Max) | Claude Opus 5 (High) | GPT-6Sol (Max) |
|---|---|---|---|---|
| 开源/闭源属性 | 开放生态 (Open Source) | 闭源 API | 商业闭源 | 商业闭源 |
| WebDev 专项排名 | 🏆 全球第一 (开源首位) | 第二梯队 | 第三梯队 | 顶级并列 |
| Code Arena 总榜分 | 1670 分 (第 12 名) | 1648 分 | 1655 分 | 1679 分 |
| 输入 Token 成本 (每百万) | $0.3 (极其普惠) | $3.0 | $15.0 | $10.0 |
| 输出 Token 成本 (每百万) | $1.2 | $12.0 | $75.0 | $30.0 |
| 生态工具链无缝适配 | 原生打通 Harness / CodeBuddy | 仅专有 SDK | Claude Code 原生 | Copilot 生态 |
四、 开发者生态落地:Harness 框架与端侧 IDE 无缝协同
目前,DeepSeek-V4.1-Flash-1017 已同步在 DeepSeek 官方网页端、移动端 App 以及对外标准 REST API 接口全面就绪。不仅如此,针对现代高吞吐 Agent 自动化管线,团队还完成了极其成熟的工具链适配:
官方已针对开源评测与调度套件 DeepSeek Harness、腾讯推出的 CodeBuddy 以及 WorkBuddy 等多款主流 AI 编程与智能体辅助工具完成了专项算子级优化。开发者只需将执行脚手架升级至 DeepSeek Harness v0.2.1-rc.1 或更高版本,即可直接启用多线程投机验证与代码沙箱回滚能力,在兼顾极低 Token 消耗的同时,榨干新模型的最大效能。
📝 站长洞察 (Editor’s Insight)
DeepSeek-V4.1-Flash 在 WebDev 评测中的登顶,向整个软件工程界释放出一个极为鲜明的基础设施信号:大模型的商业护城河正在由“单纯拼盲目的参数量级与昂贵算力”彻底转向“精细化强化学习对齐、推理时算力优化以及极致的单元经济效益(Unit Economics)”。对于广大企业与独立开发者而言,此前由于 Claude Opus 或 GPT 系列高昂的 Token 费用,智能体编写大型前端项目和端到端单元测试往往面临“账单劝退”;而 DeepSeek 将同等甚至更强代码生成能力的成本一口气拉低 90%,意味着持续运行的多 Agent 并发编程、自动修复与全天候代码巡检终于真正具备了大规模工业化商用的经济可行性。


