

💡 站外导读:在现代金融与关键基础设施的底层,沉睡着数以百亿行计的“古董代码”——全球超过 43% 的银行核心业务系统、95% 的自动取款机(ATM)交互以及关键的天气预报、航空调度与核安全监测体系,依然由诞生于上世纪 50 至 60 年代的 COBOL、Fortran 和 Visual Basic 支撑。然而,由于精通这些语言的工程师群体严重老龄化、历史交接文档断代,导致任何现代化改造都如同“在飞行中更换客机引擎”。2026 年 10 月 20 日,OpenAI 正式披露了一项重磅研究突破:新一代大模型(GPT-6 Astra 与 GPT-6.1 Sol)在极低资源的遗留语言迁移任务中展现出惊人的推理能力,将 COBOL 迁往现代语言的业务等价准确率极限拉升至 97.9%,彻底击碎了困扰全球企业数十年的“遗留系统重构死局”。
从“没人敢碰”到“机器接盘”:遗留语言现代化的万亿级工程阵痛
在企业级软件工程领域,有一个人尽皆知的残酷法则:系统越核心,代码越古老,变更风险越高。以 COBOL(Common Business-Oriented Language)为例,虽然其语法设计冗长且缺乏现代面向对象或函数式编程的高级抽象,但其在定点小数计算、批处理流水线与高吞吐账务对账方面的确定性,使其在各大跨国银行的大型主机(Mainframe)上盘踞至今。
然而,这种坚固的“历史遗迹”正面临不可逆转的崩溃危机:
- 人力资本枯竭:全球熟练掌握 COBOL 的资深工程师平均年龄已超过 62 岁,退休潮让企业面临“系统在跑但已无人能改”的悬崖;
- 云原生与现代化脱节:无法接入微服务、Kubernetes、分布式流计算与现代 observability 监控体系,运维与算力维护成本随着机房老化呈指数级上升;
- 暗箱业务逻辑:历经数十年数代开发者的层层打补丁,原始业务逻辑文档早已丢失,人工重写几乎 100% 会引发生产环境数据不一致事故。
两套极限考题:MultiLangBench 与全等价业务行为迁移
为了衡量大模型在缺乏海量公开开源训练语料的“低资源编程语言”中的真实推理能力,OpenAI 拒绝采用简单的语法互换测试,而是设计了极其严苛的双轨评测基准:
- MultiLangBench(全栈自研基准):要求大模型在仅提供基础语法说明的前提下,使用 20 种不同的编程语言从零构建一个能够完全通过 SQLite 官方测试套件的兼容数据库引擎。这直接考验了模型对语言内在逻辑、内存组织与系统调用的深层理解能力;
- 跨范式业务等价迁移(COBOL to Modern Stacks):给定复杂的真实世界 COBOL 交易处理程序,要求模型将其自动转写为 C++、Java、Python 或 Rust 现代技术栈,同时必须做到原封不动地保留所有业务边界条件、精度舍入规则与输入输出行为。
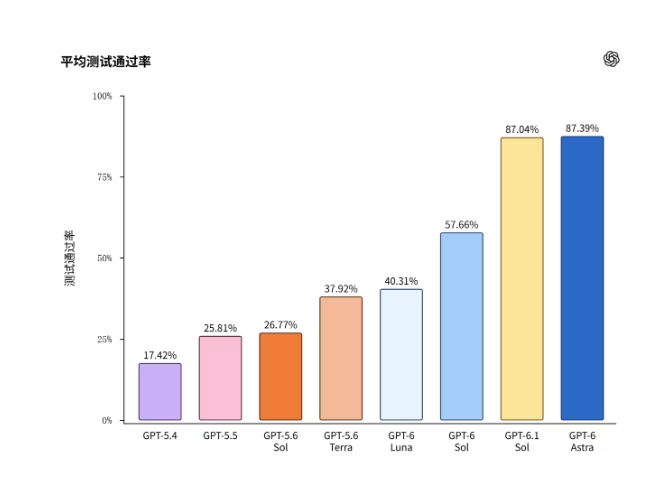
评测结果显示,新一代 GPT-6 架构在低资源代码处理上相比上一代 GPT-5.6 Sol 呈现出代际跨越式的爆发:
| 评测模型版本 | 20种语言综合通过率 | COBOL 迁移准确率 | Fortran 准确率 | Visual Basic 准确率 | 相对推理开销 |
|---|---|---|---|---|---|
| GPT-5.6 Sol (上一代) | 26.8% | 10.9% (基准测试) / 5.4% (高难) | 21.4% | 27.5% | 100% (基准基线) |
| GPT-6 Luna (极速经济版) | 40.3% | 38.2% | 46.7% | 54.1% | 仅 22% (成本暴降 78%) |
| GPT-6.1 Sol (高性价比) | 79.5% | 86.6% (低推理) / 97.9% (高推理) | 81.0% | 88.6% | 61% (成本降低 39%) |
| GPT-6 Astra (顶配旗舰) | 87.4% (跃升3.2倍) | 72.1% (冷门平均) | 83.5% | 89.4% | 顶级推理算力对齐 |
低成本平替路线:高低推理强度的弹性分层与架构取舍
在海量遗留代码迁移的真实业务场景中,除了正确率之外,企业 CTO 与架构师最敏感的莫过于Token 消耗与迁移总成本(TCO)。如果把数千万行代码全部送入最高规格的旗舰模型反复推理,算力成本可能同样高达数百万美元。
OpenAI 本次研究报告中最值得业界关注的亮点正是模型分层调度能力:
- 低推理强度与经济型组合:在常规模块(如纯数据结构定义、标准输入输出格式化)迁移中,调用轻量级的
GPT-6 Luna或低推理强度的GPT-6.1 Sol,可在成本下降 39%~78% 的前提下,交出超过 86.6% 的高通过率结果,完成 80% 的大体量骨架铺设; - 核心账务逻辑高算力攻坚:对于涉及浮点进位、交叉事务隔离与复杂利息滚算的不可出错核心函数,自动切换至高推理强度(Extended Reasoning Mode),模型将自主展开自反馈验证轨迹(Self-Refinement Rollout),一举将正确率拉升至 97.9%,摸平人工排查缺陷的巨大开销。
SRE 视角:代码转写仅完成 30%,如何构建零故障的生产级防御护栏?
尽管 97.9% 的评测指标近乎完美,但 OpenAI 在报告末尾极具克制地给出了严肃的安全注脚:“将 AI 生成的迁移代码送入生产环境,仍然必须由资深专家进行审查,并建立严密的端到端业务仿真验收机制。”
从站长与 SRE 生产级运维的角度来看,遗留系统迁移绝对不是单纯的代码“文本翻译”,而是横跨数据层、并发调度与异常降级的系统性重构工程:
- 计算精度差异陷阱:COBOL 原生支持十进制 Packed Decimal(BCD 编码)运算,而现代语言(如 Python、C++)默认使用 IEEE 754 二进制浮点数。若未在目标语言中严格引入专用高精度 Decimal 库,仅一个微小的舍入差异就可能在数百万笔交易累计后造成巨额账实不符;
- 暗隐依赖与内存锁竞争:大型机架构下的共享内存区与批处理时序在微服务架构下需要拆分为分布式锁或事务消息队列。AI 可以精准重写单函数,但宏观系统间的拓扑耦合仍需架构师把关;
- 影子流量录制双跑(Shadow Run):推荐采用“录制生产真实流量并分流回放”的双轨验证机制,将旧 COBOL 系统与 AI 生成的全新微服务并联运行 30~90 天,比对每一笔出入参哈希,只有做到 100% 物理对齐才可执行流量切换。
📝 站长洞察 (Editor’s Insight)
OpenAI 这篇关于 COBOL 与遗留代码迁移的报告,标志着大模型正在从“写前端玩具代码”与“打编程竞赛题”的浮夸阶段,真正下潜到全球金融与工业实体最深处的“重工业脏活”。过去三十年间,无数科技巨头试图推行遗留系统现代化,但大多在天价外包费用与巨大回滚风险中惨淡收场。大模型凭借跨语言语义表示与符号逻辑推理的统一能力,把数万行的语法转写成本击穿了 90% 以上。然而我们必须警惕“虚假的 98% 信心”——在航天、核电与银行业务中,剩下的 2% 幽灵缺陷足以摧毁整个系统。未来的大模型企业级软件工程,核心竞争壁垒绝不再是模型本身能写出多少行代码,而是围绕模型构建的“形式化验证编译器”、“契约测试沙盒”与“自动差分回归管线”。谁能把大模型的生成物封死在零信任的确定性护栏之内,谁就能主导全球万亿美元级的企业架构改造红利。


