

💡 站外导读:伴随全球大模型军备竞赛全面步入超大上下文与长程推理时代,阿里旗下备受瞩目的新一代旗舰大模型——“千问 Qwen4”系列的核心实测跑分数据于今日正式浮出水面。在此次聚焦高难度长链路任务的专用创造力评估项目 GameFeel Bench 中,定位轻量高速的 Qwen4-Flash 一举斩获 49.9 的超高分,历史性地超越了海外顶尖旗舰 Claude Opus 5.5 xHigh(47.2分);更令行业震撼的是,完成同等复杂逻辑构建,Qwen4-Flash 的推理成本仅需 0.4 美元,较海外竞品骤降近 85%,标志着国产前沿基座大模型在“逻辑创造力”与“工业级落地性价比”两大维度实现了硬核突破。
摒弃传统刷榜虚假繁荣:GameFeel Bench 凭何成为大模型试金石?
在过往的大模型评测中,MMLU、GSM8K 等学术基准因训练集污染严重、选择题机制容易投机取巧而饱受质疑。业内开发者普遍面临“基准跑分全满分,实机开发一用就崩”的尴尬困境。此次曝光的 GameFeel Bench 则彻底颠覆了传统评价机制:
- 端到端闭环系统设计:模型不再仅仅回答碎片化常识,而是必须根据复杂的自然语言游戏概念,直接输出包含物理碰撞逻辑、动态状态机控制、经济数值平衡及交互反馈的完整游戏系统架构;
- 高阶创造力与逻辑深度:评测着重考察模型面对非确定性需求时的自发联想、代码健壮性以及长程多文件上下文一致性,任何逻辑死锁或未闭合状态都会被严苛扣分;
- 不可见私有动态测试集:测试用例采用动态生成与人工隐式交叉审查,彻底杜绝了大模型团队通过“针对性背题(Dataset Contamination)”获取虚高分数的可能。
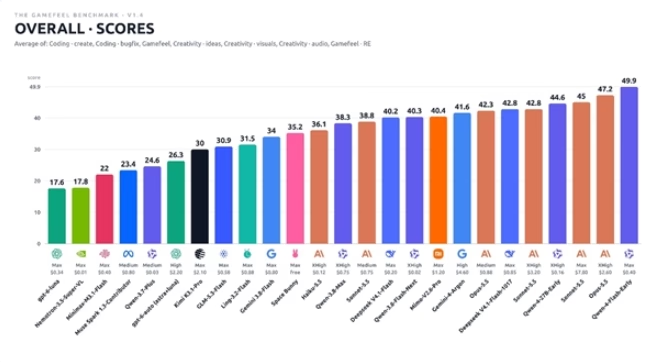
实测数据震撼揭秘:Flash逆袭顶级旗舰,27B小钢炮单挑Sonnet
从流出的核心测试报告来看,Qwen4 系列展现出了极具侵略性的阶梯式性能布局:
1. Qwen4-Flash:轻量级架构逆袭海外超大模型
测试数据显示,Qwen4-Flash 在 GameFeel Bench 获得了 49.9 分 的巅峰成绩,直接压制了国际公认最强推理与编程大模型之一的 Claude Opus 5.5 xHigh(47.2 分)。这一结果彻底打破了“只有千亿级超密集参数模型才能处理复杂创造性任务”的行业定式,证明了阿里在动态稀疏激活(Sparse MoE)、强化学习对齐(RLHF)以及后训练长程轨迹优化层面的突破性进展。
2. Qwen4-27B:本地私有化部署的杀手级利器
参数量适中、专为消费级显卡与工作站私有化部署设计的 Qwen4-27B 表现同样惊艳,取得了 44.6 分 的傲人战绩。这一分数直接咬死并无限逼近行业标杆 Claude 3.5 Sonnet(45.0 分)。这意味着中小企业与独立开发者只需借助单张 RTX 4090 或主流 Mac Studio,即可在完全离线断网的本地算力环境中,获得匹敌顶级云端商业 API 的代码构建与游戏逻辑推演能力。
Qwen4 家族与海外主流顶级大模型横向全景横评
为了直观展现 Qwen4 带来的技术代差冲击,我们将其实测数据与行业竞品进行了多维量化对比:
| 评估模型型号 | GameFeel 得分 | 单任务基准推理成本 | 架构特性与参数形态 | 首选应用与部署场景 |
|---|---|---|---|---|
| Qwen4-Flash (阿里) | 49.9 分 (SOTA) | 约 $0.40 美元 | 高吞吐超稀疏动态 MoE | 高并发工业级智能体、自动化代码重构、游戏原型直出 |
| Claude Opus 5.5 xHigh | 47.2 分 | 约 $2.60 美元 | 超大规模密集激活/巨量参数 | 极复杂学术推导、跨领域宏观战略分析(成本高昂) |
| Qwen4-27B (开源端侧) | 44.6 分 | 约 $0.16 美元 (本地显卡电费) | 270亿密集参数 / 4-bit 量化支持 | 单卡私有化部署、高保密敏感资产研发、离线边缘网关 |
| Claude 3.5 Sonnet | 45.0 分 | 约 $1.20 美元 | 商业中型密集混合架构 | 日常代码补全、前端 UI 构建、文档分析 |
四剑齐发:透视阿里 Qwen4 全系产品生态布局
据悉,阿里千问团队为 Qwen4 规划了极其严密的金字塔型产品矩阵,力图实现从边缘终端到超算中心的全场景通吃:
- Qwen4-Flash:主打微秒级首字延迟与极低推理成本,面向企业级大规模并发 API 场景,直接拉低商用大模型准入门槛;
- Qwen4-27B:延续开源优良传统,专为开发者社群与边缘设备量身定制,提供极高权重的本地自建生态保障;
- Qwen4-Plus:对标主流商业云端主力模型,在通用自然语言多模态处理与数理长程逻辑间保持完美黄金平衡;
- Qwen4-Max:代表整个系列的究极性能上限,预计将配备更大规模的 MoE 专家网络,正面迎战未来即将亮相的 GPT-6.1 与 Gemini 3.0 Ultra。
📝 站长洞察 (Editor’s Insight)
从 SRE 算力经济学与全栈大模型架构审视,Qwen4 此次跑分释放的核心信号并非“盲目超越”,而是“AI 工业革命成本拐点的真正到来”。海外巨头如 Anthropic、OpenAI 陷入了参数规模军备竞赛与极高推理单价的泥潭,导致大量初创企业在长程 Agent 多轮交互中面临算力破产;而阿里通过高效的架构剪枝、KV 缓存压缩以及强化推理蒸馏,让 Qwen4-Flash 以仅相当于 Opus 5.5 六分之一的成本跑赢实测性能。这标志着国产大模型正在从‘追赶参数’转向‘重塑生产力性价比标准’。对于国内广大工程师而言,紧跟 Qwen4 矩阵的 API 接入与端侧 27B 镜像沉淀,将是未来一年内最具性价比的技术护城河。


