

💡 站外导读:在企业级 RAG 与大模型知识检索架构中,以 ColBERT 为代表的多向量嵌入模型(Multi-Vector Models)凭借细粒度 Token 交互和 MaxSim 评分机制,大幅超越了传统单向量稠密嵌入的召回表达力。然而,文档全量 Token 向量的膨胀导致百万级语料库轻量化部署的存储与内存成本飙升。Hugging Face 与 Sentence Transformers 官方团队最新推出的“Token 池化感知训练”(Token Pooling-Aware Training)突破了这一行业瓶颈:通过在模型预训练阶段引入池化损失正则化,结合 Ward 层次聚类算法,在实现 4 倍向量压缩比的前提下,将 NanoBEIR 检索精度(nDCG@10)保留率从基线的 94.6% 提升至 97.8%,为低成本高效能企业级检索工程化落地树立了全新标杆。
随着大语言模型(LLM)检索增强生成(RAG)和语义搜索在企业生产环境中的深度普及,向量召回精度与硬件成本之间的矛盾愈发尖锐。传统的单向量(Single-Vector)模型将整篇文档强行压缩为一个固定维度的稠密向量,在面对长文本、多实体复杂查询时极易丢失局部关键细节;而多向量模型(如 ColBERT、LateOn)为文档的每一个 Token 保留独立的上下文嵌入表示,允许查询语句中的每个关键词与文档各个段落精准对齐匹配,展现出令人惊叹的语义捕获能力。
然而,这种细粒度交互的代价是存储与内存开销呈几何级数爆炸。一个数百万规模的文档库,其索引向量往往高达数亿个!即便结合最前沿的 2-bit 或 4-bit 残差量化(Residual Quantization),数以百计的向量体积仍然让基础设施预算不堪重负。为此,Hugging Face 官方技术团队在 Sentence Transformers 生态中正式推出了 Token 池化感知训练(Token Pooling-Aware Training),本文将为您深度拆解其数学原理、架构设计与生产级落地实践。
一、细粒度检索的代价:ColBERT 与多向量模型为何面临存储爆炸?
理解 Token 池化的必要性,首先要看清多向量模型底层的工作机制与硬件瓶颈:
1. MaxSim 交互机制与表达力优势
在单向量检索中,相关性评分通常是查询向量 $q$ 与文档向量 $d$ 的点积或余弦相似度;而在 ColBERT 类多向量架构中,采用的是晚期交互(Late-Interaction)核心算法——MaxSim 评分机制。对于查询 Token 序列 $Q$ 和文档 Token 序列 $D$,评分公式如下:
MaxSim(Q, D) = ∑_{q ∈ Q} max_{d ∈ D} (q^T · d)
这意味着查询中的每一个 Token,都会在整篇文档中独立搜索最为匹配的那个 Token 向量,最后将所有查询 Token 的最大匹配分累加。这种机制允许用户在搜索“长续航且轻便的笔记本电脑”时,前半句匹配文档关于电池寿命的章节,后半句匹配关于机身重量的段落,彻底解决了长文档信息稀释(Lost in the Middle)难题。
2. 严酷的硬件算力与存储账单
然而,存储账单是残酷的。以 Fast-PLAID 支持的 4-bit 残差量化为例:
- 假设一篇文档平均包含 200 个 Token 向量,每个向量维度为 128。
- 在 4-bit 精度下,每个坐标占用半字节,单篇文档的残差量化数据需要
200 × 128 × 0.5 Byte = 12.8 KB。 - 如果语料库达到 1,000,000 篇文档,仅量化残差索引就需要 12.8 GB 显存/内存!若语料库扩充至千万级,内存需求将直奔 128 GB 以上,分布式集群的维护门槛和硬件采购成本直接劝退大量中小型团队。
如果能将文档的 Token 向量数量从 200 个压缩至 50 个(4 倍压缩比),不仅单篇存储骤降至 3.2 KB,内存占用压缩 75%,MaxSim 矩阵点积计算的吞吐量也将获得近 4 倍的飞跃!
二、核心压缩算法:Ward 层次聚类与自适应 Token 池化机制
直接丢弃 Token 显然会导致严重的信息丢失。Hugging Face 团队的关键洞察在于:在自然语言文档中,许多相邻或语义相关的 Token 向量高度重叠。例如连续的专业术语或同义词,完全有机会合并为一个高内聚的代表性向量。
1. Ward 层次聚类(Ward Hierarchical Clustering)
Sentence Transformers 引入了 HierarchicalTokenPooling 模块。该模块采用 Ward 聚类算法:
- 初始化状态:将文档中的每一个 Token 向量视为一个独立的初始簇。
- 方差最小化合并:在每一步迭代中,计算所有簇之间合并后导致的组内平方和(Sum of Squared Differences from Group Mean)增量,并贪心地合并那个使簇内离散度增量最小的两个簇。
- 代表向量归一化:合并完成后,每个簇用其内部所有成员向量的均值(Mean)作为该簇的代表向量,并执行 L2 归一化,重新参与 MaxSim 计算。
为了保护句子语义的完整性,算法默认保护首个 Token(如 CLS)绝对不参与合并,且池化操作仅应用于文档端(Document Embeddings),保持查询端(Query Embeddings)高灵敏度不变。
2. 三维池化预算控制策略
开发者可以通过三种灵活维度调控压缩力度:
- 固定缩放比(
pool_factor):例如设置pool_factor=4,文档按长度等比例压缩至原向量数量的 1/4,短文本压缩少、长文本保留更多容量。 - 固定向量上限(
max_tokens):强制将所有文档截断合并至指定数量的向量(如 16 或 32 个)。 - 自适应距离阈值(
distance_threshold):通过calibrate_distance_threshold采样计算全局最优聚类距离,让信息密度高的文档自适应保留更多向量,平淡内容更激进地合并。
三、破局关键:MultiVectorTokenPoolingLoss 损失包装器与 STE 直通估计器
为什么不能直接拿已有的成熟模型进行 Ward 聚类池化?实验表明,如果对未经适配的普通 ColBERT 模型强行施加 pool_factor=4 池化,其在检索基准中的得分会急剧缩水,因为预训练时模型假设所有细粒度 Token 均独立存在,从未学过在“被压缩合并”后如何保持可分性。
这正是 Sentence Transformers 本次更新的精髓所在——将池化过程前置到模型训练目标中(Pooling-Aware Training)。
1. 双重训练目标公式
在池化感知训练中,每一个 Mini-batch 同时贡献两项对比损失:
L = 0.5 × L_{unpooled} + 0.5 × L_{pooled}
- L_{unpooled}:使用原始未经压缩的完整 Token 向量计算对比检索损失,确保模型保持顶级的细粒度理解基础。
- L_{pooled}:将文档压缩至目标预算(如 1/4)后再次计算检索损失,迫使编码器在输出 Token 嵌入时,就学会将互补或相似特征紧密排列,使得聚类合并后的均值向量依然包含关键检索特征。
2. STE 直通估计器(Straight-Through Estimator)解决不可微困境
Ward 聚类的离散分组逻辑是不可导的,反向传播无法直接穿透。Sentence Transformers 在 HierarchicalTokenPooling 中巧妙利用了 Straight-Through Estimator (STE):在反向传播时,直接将均值池化向量处接收到的梯度无损直通回传给其所属的所有原始 Token 向量,忽略聚类树的阶跃离散操作。编码器因此可以直接从“池化后的检索失误”中获得反向驱动力并快速修正权重!
3. 实战代码:MultiVectorTokenPoolingLoss 调用规范
from sentence_transformers import MultiVectorEncoder
from sentence_transformers.multi_vector_encoder.losses import (
    CachedMultiVectorMultipleNegativesRankingLoss,
    MultiVectorTokenPoolingLoss,
)
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

# 1. 载入现代化骨干网络 ModernBERT
model = MultiVectorEncoder("answerdotai/ModernBERT-base", similarity_fn_name="maxsim")

# 2. 定义 4 倍压缩的层次池化模块
pooling = HierarchicalTokenPooling(pool_factor=4)

# 3. 基础对比检索损失 (结合梯度缓存支持大 Batch 负样本)
base_loss = CachedMultiVectorMultipleNegativesRankingLoss(model, mini_batch_size=64)

# 4. 封装多向量池化感知损失函数 (无损与池化各占 50% 权重)
loss = MultiVectorTokenPoolingLoss(
    model,
    base_loss,
    token_poolings=[None, pooling],
    weights=[0.5, 0.5],
)
四、实测数据对比与 GPU 内核加速性能实证
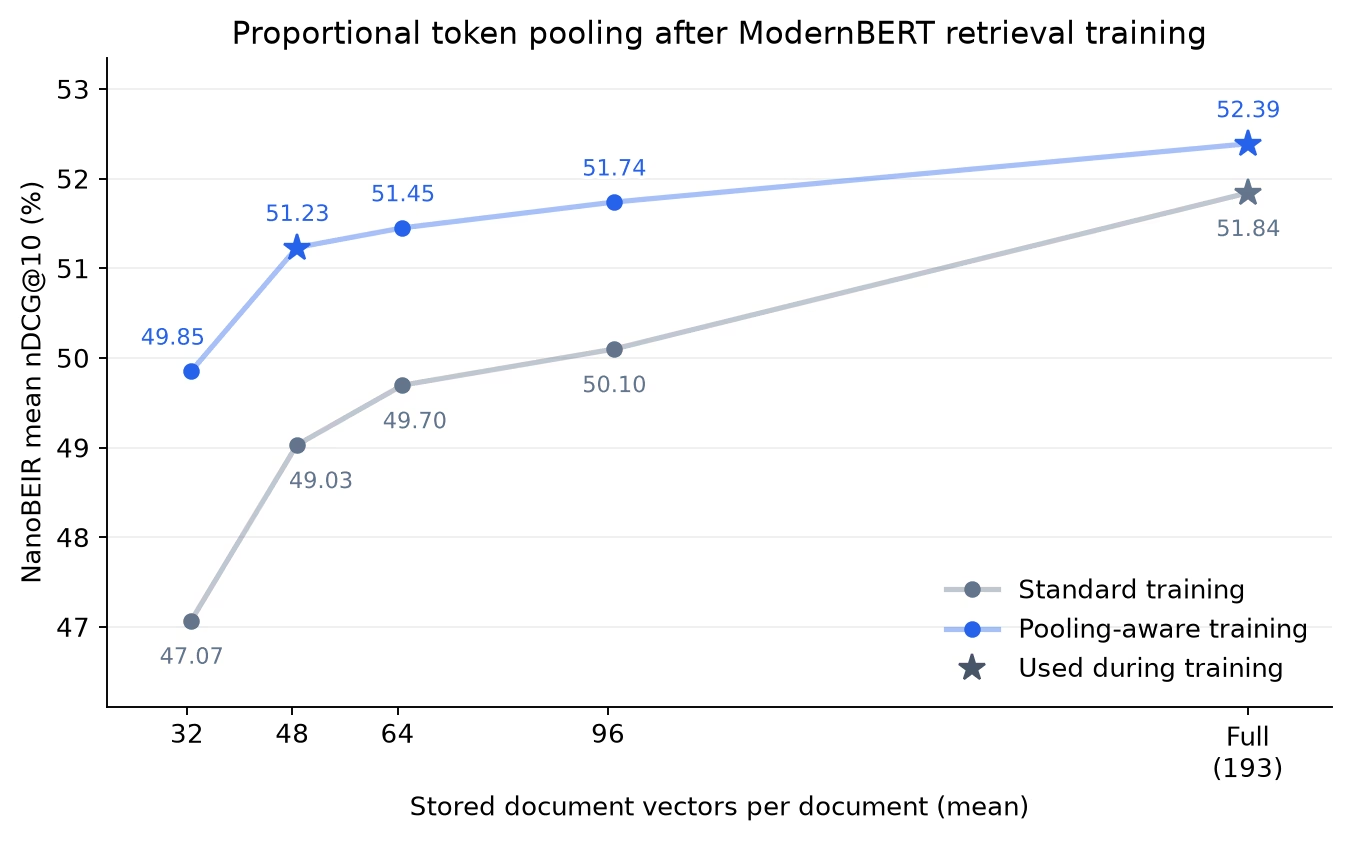
Hugging Face 官方团队在标准化权威检索基准 NanoBEIR 上进行了严谨的消融实验,对比了普通微调基线模型与经过 Token 池化感知训练模型的精度保持曲线:
| 压缩方案配置 | 单文档平均向量数 | 向量存储节省率 | 普通微调保持率 (nDCG@10) | 池化感知训练保持率 (nDCG@10) | SRE 工业落地推荐度 |
|---|---|---|---|---|---|
| 基线未压缩 (Unpooled) | ~128 向量 | 0% (基准 100% 存储) | 100.0% | 100.0% | ⚠️ 仅限极小数据量验证 |
| pool_factor = 2 (2倍压缩) | ~64 向量 | 节省 50.0% 存储 | 98.2% | 99.5% | 🟢 极高精度敏感型业务 |
| pool_factor = 3 (3倍压缩) | ~43 向量 | 节省 66.7% 存储 | 96.5% | 98.9% | 🟢 生产通用最优性价比 |
| pool_factor = 4 (4倍压缩) ★ | ~32 向量 | 节省 75.0% 存储 | 94.6% | 97.8% (+3.2% 跃升) | 🌟 SRE 强力推荐标配 |
| pool_factor = 6 (6倍激进压缩) | ~21 向量 | 节省 83.3% 存储 | 91.2% | 95.4% (+4.2% 跃升) | 🟡 亿级超大规模严控预算 |
从数据中可以清晰看到:在 4 倍压缩的关键拐点上,普通模型检索精度跌落超过 5 个百分点,而经过池化感知训练的模型保留了 97.8% 的基准得分。换句话说,只需付出不足 2.2% 的微小精度折损,就能直接为整套分布式检索基础设施换取 整整 75% 的存储与内存节约!
GPU Triton/CUDA 内核加速支持
此外,Sentence Transformers 2026 最新版还集成了专用 Triton/CUDA 内核加速包:通过 pip install -U "sentence-transformers[train,kernels]",MaxSim 计算在 GPU 显存内流式聚合,无需在显存中完全物化巨大的 Token 相似度矩阵,将训练与推理吞吐量再推高数倍。
📝 站长洞察 (Editor’s Insight)
从 SRE 与大模型知识检索基础设施的演进脉络来看,多向量模型(Late-Interaction)长期以来陷入了“精度极高但基建成本难以承受”的尴尬境地。许多团队在 PoC 阶段被 ColBERT 惊艳的细粒度召回所打动,却在推进到百万级企业文档全量上线时被数万元的服务器显存月账单劝退,不得不无奈退回粗糙的单向量稠密嵌入。Sentence Transformers 这次推出的 Token 池化感知训练,其精髓在于“将推理期的压缩约束提前注入模型先验(Inductive Bias)”,利用 STE 直通估计器攻克了聚类离散不可导的数学难点。以 4 倍压缩换取 97.8% 的保真度,标志着多向量模型真正跨过了工业规模化落地的经济性门槛。在 2026 年构建现代 RAG 与智能体长知识库系统的工程师,必须将池化感知训练纳入核心架构必选清单。
Token 池化感知训练解决什么问题?
它主要解决 ColBERT 等多向量检索模型的存储和内存膨胀问题。通过在训练阶段引入池化损失正则化,并结合聚类压缩 Token 向量数量,可在尽量保留召回效果的同时显著降低索引体积。
Ward 层次聚类在这里怎么用?
文章中的 HierarchicalTokenPooling 采用 Ward 聚类,把每个 Token 视为初始簇,再按组内平方和增量最小的原则逐步合并,最后用簇内均值向量并做 L2 归一化,作为压缩后的代表向量参与检索。
4倍压缩后检索效果会掉很多吗?
根据文中给出的官方结果,4 倍向量压缩下 NanoBEIR 的 nDCG@10 保留率达到 97.8%,相较基线 94.6% 有明显提升,说明压缩后仍能较好维持检索精度。
池化感知训练怎么接入现有向量库?
先离线生成原始 token 向量,再用 Ward 聚类和池化损失训练压缩映射;上线时保留双写与回滚通道,先在召回集和线上流量做 A/B,对比 nDCG、延迟和成本再切主。
多向量压缩后如何防止长尾召回掉点?
重点看高歧义查询和长文档样本,给这些样本单独做 hard negative 与分桶评测;同时保留少量高维原始索引做兜底重排,避免压缩模型把细粒度语义折叠掉。


