

💡 站外导读:在企业级人工智能落地向深水区迈进的过程中,行业正逐渐看清一个残酷事实:用动辄数百亿甚至上千亿参数的自回归生成式大语言模型(LLM)去处理客服工单派发、信贷风险拦截、意图识别与规则分类等高频结构化任务,存在着成本高昂、首字延迟过大以及输出格式脆弱不堪的结构性缺陷。10 月 22 日,蚂蚁数科正式发布全新专用决策大模型 LingDT-Decision-1.0(提供 4B 和 27B 两个核心版本,已在 DTMaaS 平台上线开放体验)。通过彻底摒弃“逐字生成文本再做二次正则解析”的传统粗暴模式,LingDT-Decision-1.0 首创“限定空间原生多选”与“按序有向无环图(DAG)决策”范式,在真实产业场景中创下 Token 消耗暴跌 90%~97%、处理时效提升 10 倍的惊人数据,并在 23 项权威基准测试中全面压制微软与 Jev 等国际顶尖决策模型。
一、传统生成式大模型的产业硬伤:为何自回归机制在结构化决策中频频折戟?
在现代企业系统的自动化流水线中,充斥着海量高频、确定性的决策需求。以智能客服场景为例,当系统接收到用户的一句输入“这个订单已经三天没发货了,请尽快催一下并帮我补开发票”时,后台 Agent 系统必须在眨眼之间完成四重连环判断:问题分类(退款/催单/售后开票)、紧急程度评定、目标工单路由部门以及是否需要即刻触发人工坐席接管。
若采用主流的生成式 LLM,模型必须先逐个 Token 输出冗长的解释说明或一段复杂的 JSON 字符串,随后由后端系统利用正则表达式或 JSON Schema 进行二次解析。这一过程不仅耗费了数十倍的多余算力,还极易受到格式错乱、字段缺失或内容幻觉的致命干扰,严重破坏了生产级 SRE 体系的稳定性指标。
蚂蚁数科 LingDT-Decision-1.0 的核心解法,是将整个推理范式从“先自由生成、再事后解析”,重塑为“在限定候选空间内直接进行高维状态转移与数学判定”。这种架构上的根本转变,不仅消除了繁复的校验链路,更让推理计算量呈现断崖式下降。
| 测试业务场景 | 基线对比模型 | Token 消耗降幅 | 响应时效提升 | 业务准确率/质效提升 |
|---|---|---|---|---|
| 企业数据要素标注 | DeepSeek-V4-Flash | 降低约 97% | 时效提升 10 倍 | 消除格式解析失败,实现 100% 结构化入库 |
| 智能客户服务中枢 | Qwen-3.7-Flash | 降低约 90% | 时效提升约 1 倍 | 风险工单精准识别率由 76% 跃升至 89% |
| 金融合规与风控拦截 | 主流商用闭源 LLM | 降低约 92% | 时效提升约 5 倍 | 幻觉召回率由 44% 飙升至 70%,敏感度倍增 |
| Agent 工具组合调用 | 开源 32B 生成式模型 | 降低约 88% | 时效提升约 3 倍 | 复杂多工具拓扑组合匹配率提升 2.6 倍 |
二、全球首发两大杀手锏:“原生多选”与“按序 DAG 决策”如何击碎真实复杂业务痛点?
传统单选分类模型或浅层分类器,往往只能在预设选项中给出一个“单选答案”,但在真实的复杂业务场景中,用户的诉求极少是单维度的。例如,用户提出:“我要申请退款,顺便关闭下个月的自动续费并补开上月发票,但千万别注销我的账户!”如果仅靠单选,系统往往只能捕捉到“退款”主标签,直接导致自动续费被漏关或发票诉求被丢弃。
针对这一痛点,LingDT-Decision-1.0 在业内首创推出了两大核心机制:
1. **原生多选(Native Multi-choice)机制**:模型原生支持在单次推理中精准激活多个互不排斥的候选状态,天然完美契合多意图识别、复杂属性标注与复合工具组合调用,彻底避免了多次串行调用的冗余开销。
2. **按序决策(DAG Workflow)机制**:在真实流程中,各项任务之间往往存在严格的依赖拓扑。例如在上述案例中,系统必须先进行退款资格审查,确认退款金额后方可结算发票金额,而关闭续费操作则可异步并行执行。LingDT-Decision-1.0 能够直接输出具备依赖关系的有向无环图(DAG),真正做到决策与企业 BPM 业务引擎无缝咬合。
三、23 项主流开源基准全景横评:27B 拔得头筹,DTMaaS 平台开启限时免费公测
为了客观检验决策能力,蚂蚁数科团队在涵盖 23 项主流开源评测基准的公开数据集上展开了全面横向对比。评测采用了国际公认的综合指标权重(90%×单选评分 + 10%×多选评分)。结果显示,LingDT-Decision-1.0 的 27B 版本综合得分高居全球榜首,全面超越了此前在企业级市场占据优势的 Microsoft-Decision-1、Jev 1.13.0 以及 Fastino/GLiDE 等顶尖决策专用模型。
特别是在极具挑战性的多选判定任务中,无论是轻量级的 4B 版本还是旗舰级 27B 版本,其测试准确率均全方位碾压包括 Star-lux 在内的 16 款主流决策模型;而在基础单选任务中,其稳居全球第一梯队。目前,该模型已全量上线蚂蚁数科 DTMaaS 平台,为企业开发者与工业级智能体架构师提供限时免费试用,加速赋能产业数字化升级。
四、架构演进与实测图解
图 1:告别逐字生成的算力浪费!蚂蚁数科重磅发布 LingDT-Decision-1.0 决策大模型:首创原生多选与按序 DAG 决策机制,Token 骤降 97%、时效飙升 10 倍实测全景拆解 核心架构与实测表现拆解
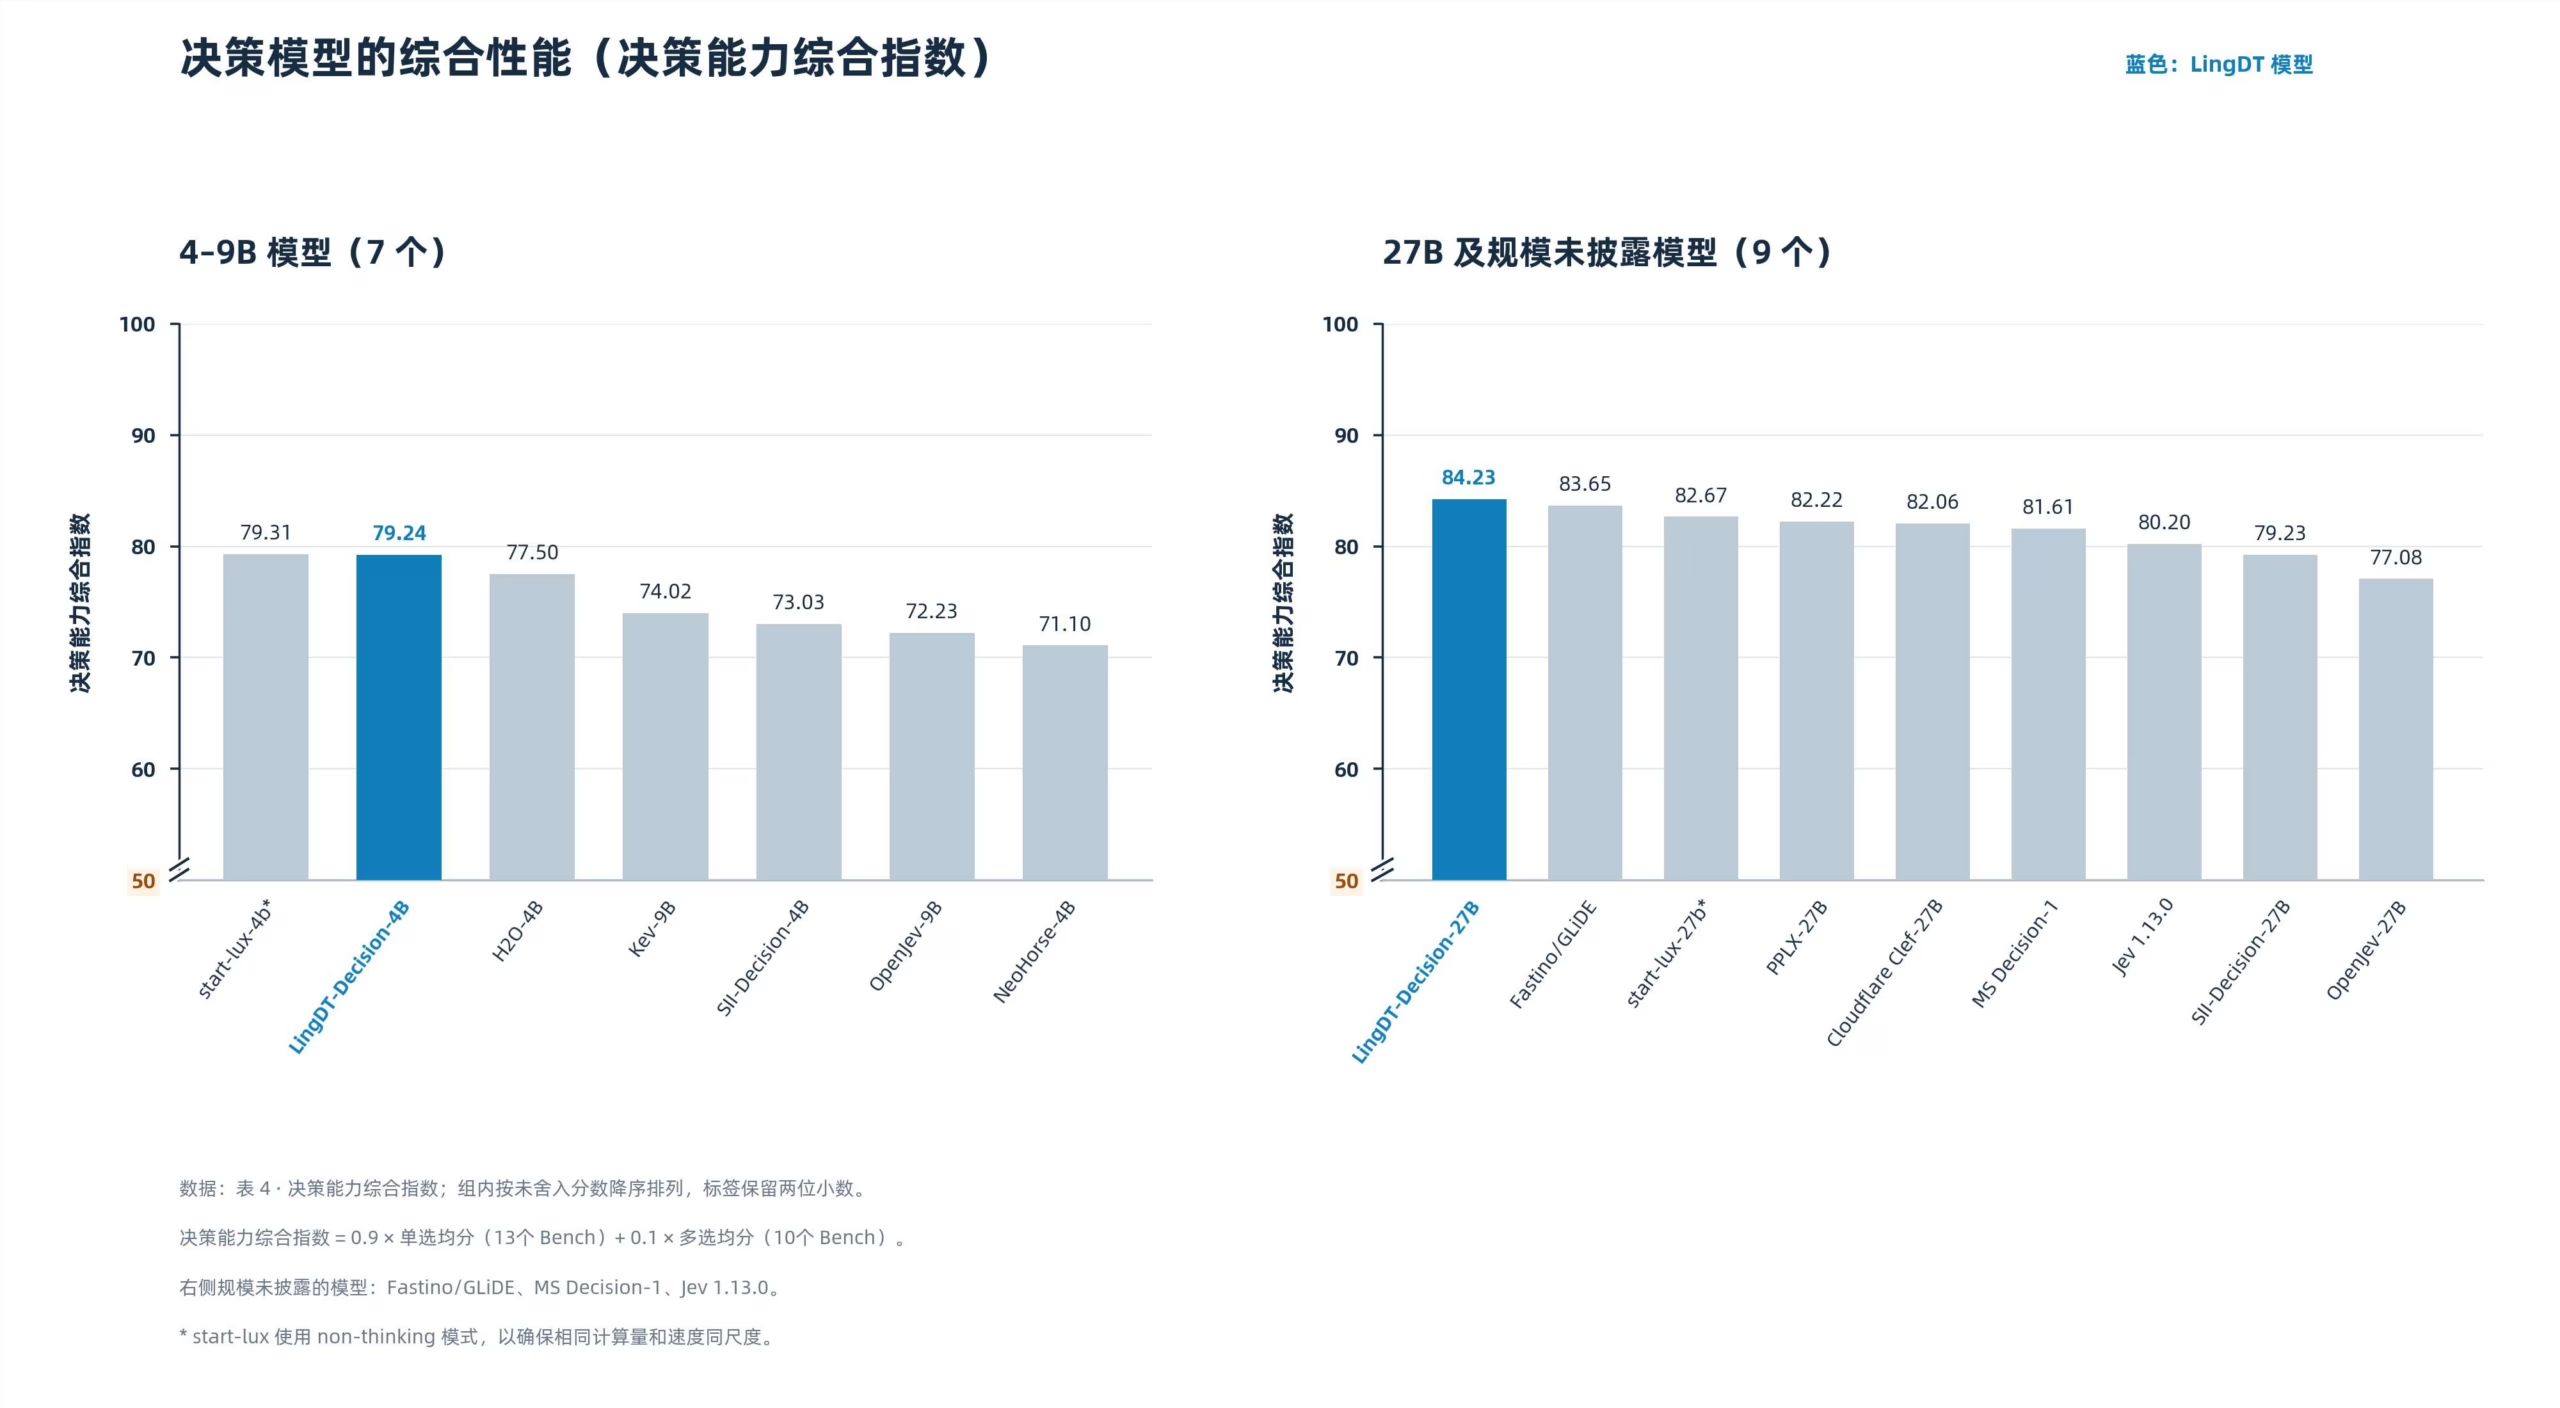
图 2:告别逐字生成的算力浪费!蚂蚁数科重磅发布 LingDT-Decision-1.0 决策大模型:首创原生多选与按序 DAG 决策机制,Token 骤降 97%、时效飙升 10 倍实测全景拆解 核心架构与实测表现拆解
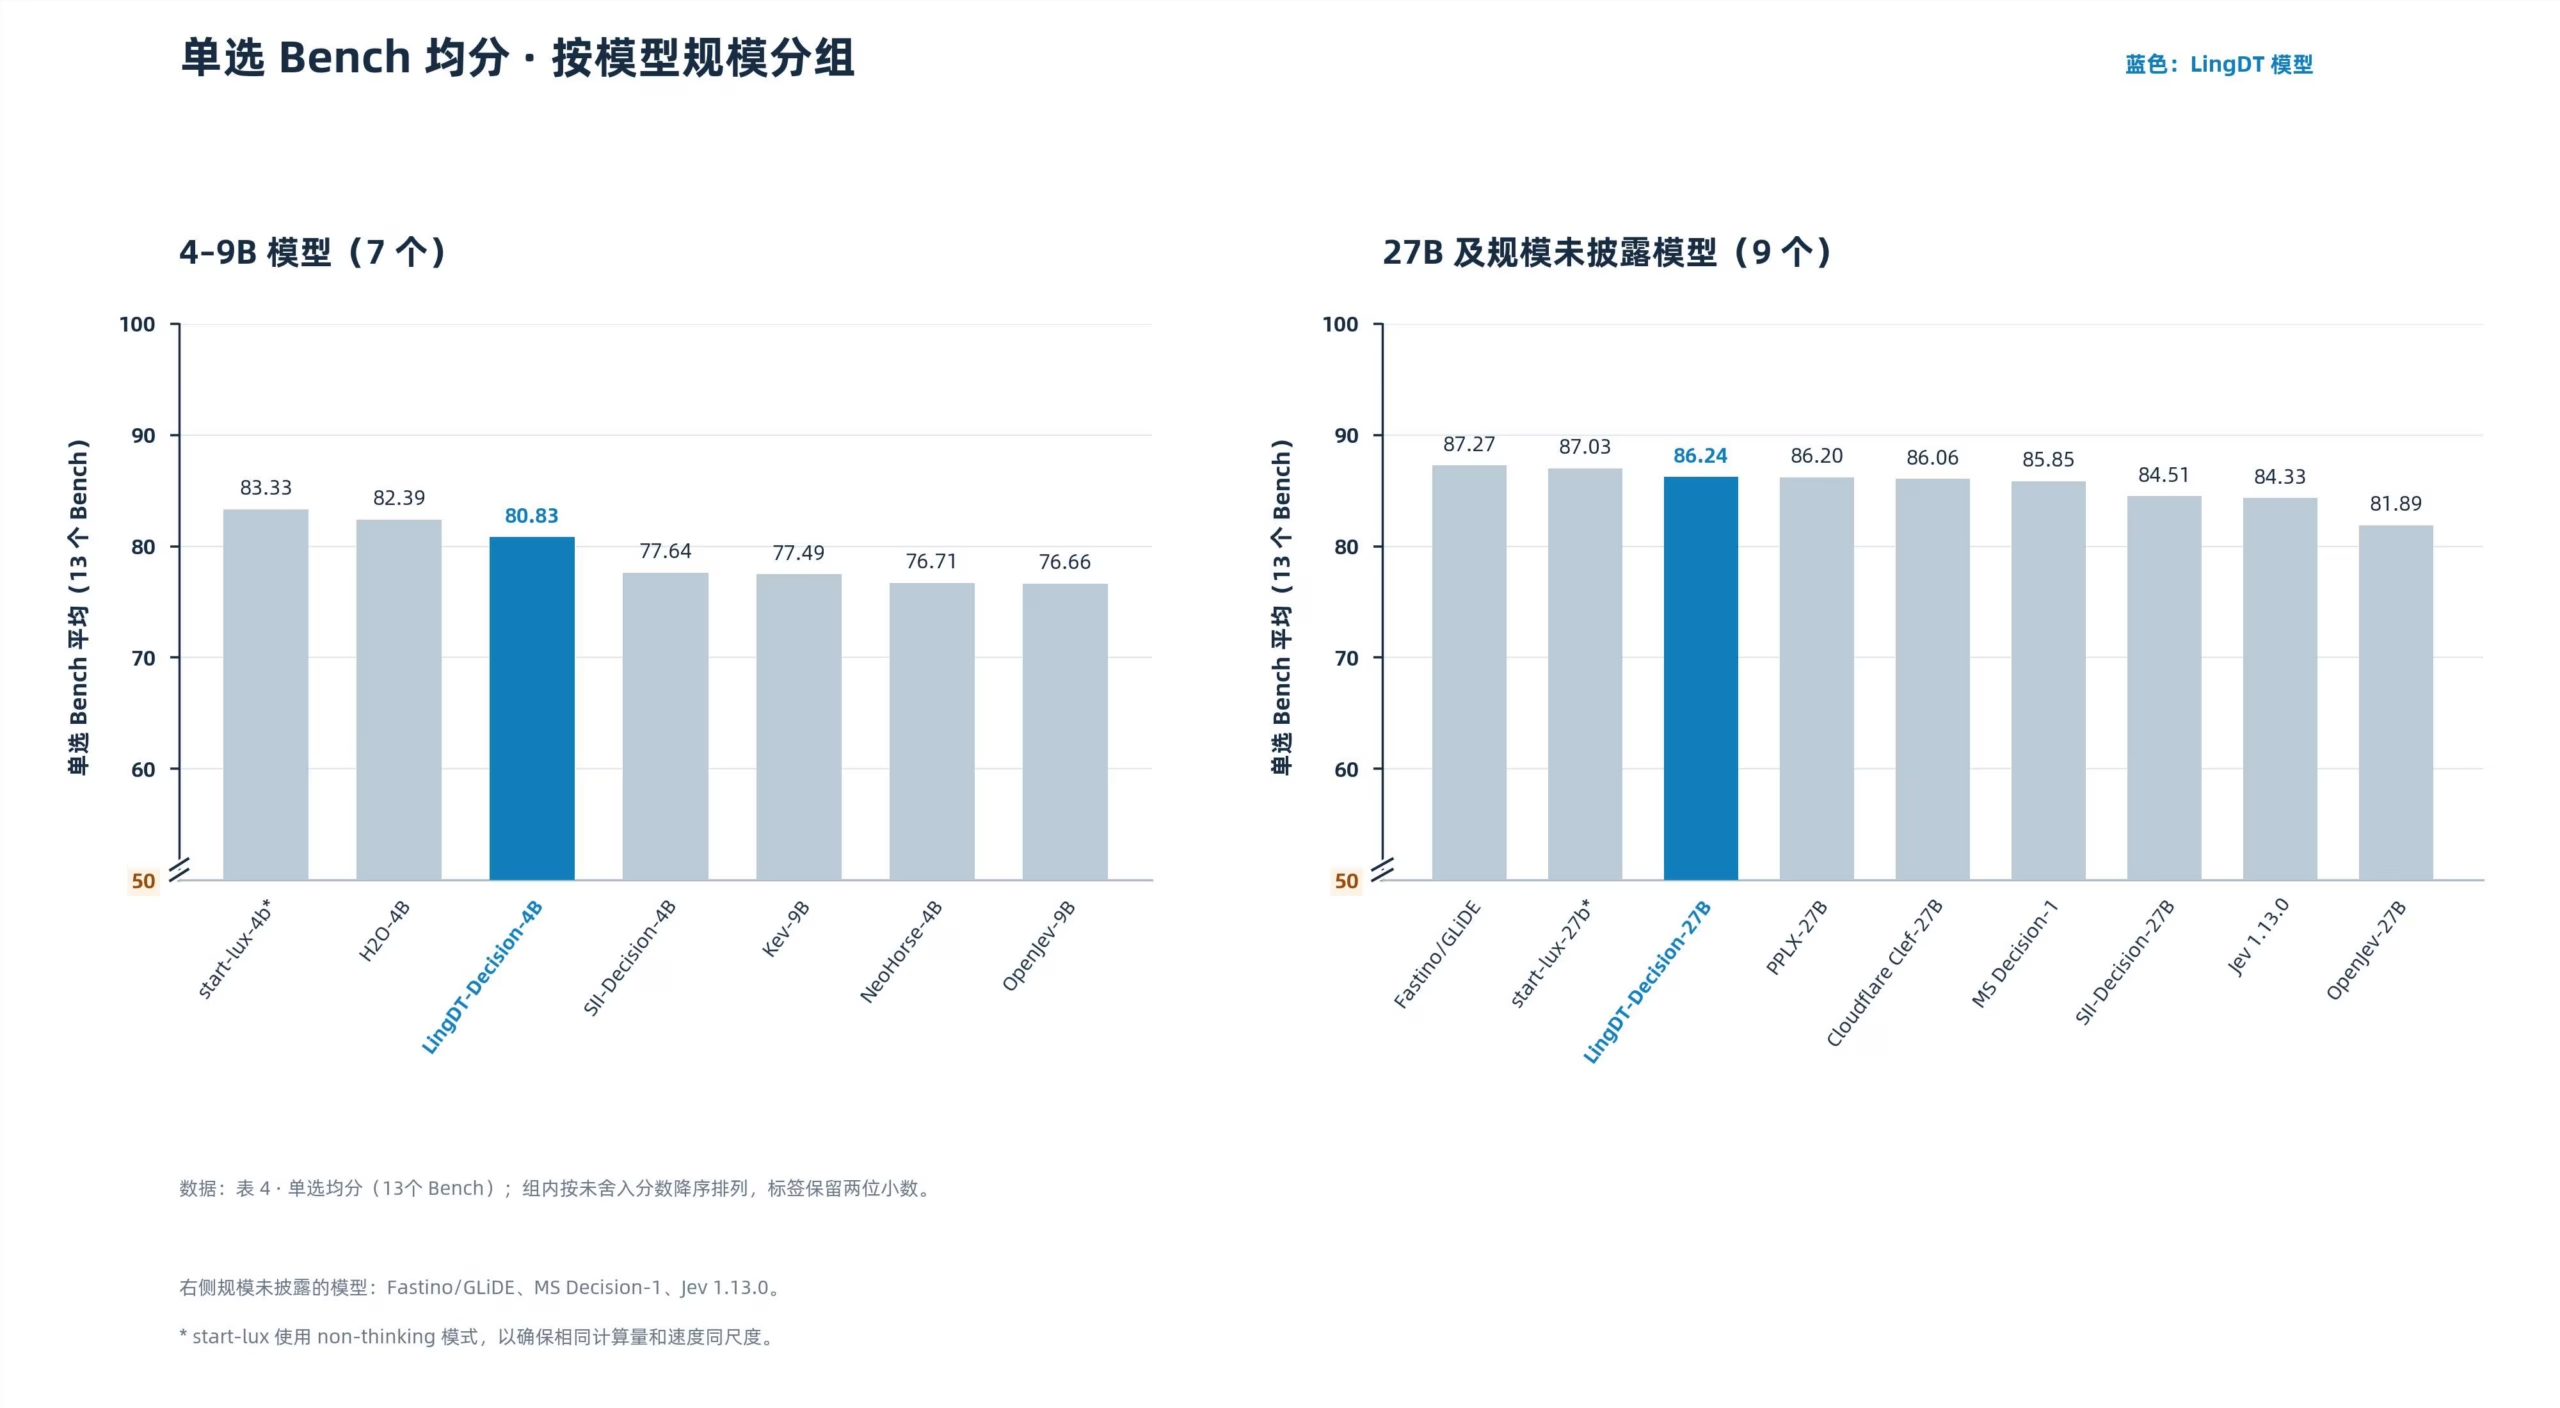
图 3:告别逐字生成的算力浪费!蚂蚁数科重磅发布 LingDT-Decision-1.0 决策大模型:首创原生多选与按序 DAG 决策机制,Token 骤降 97%、时效飙升 10 倍实测全景拆解 核心架构与实测表现拆解
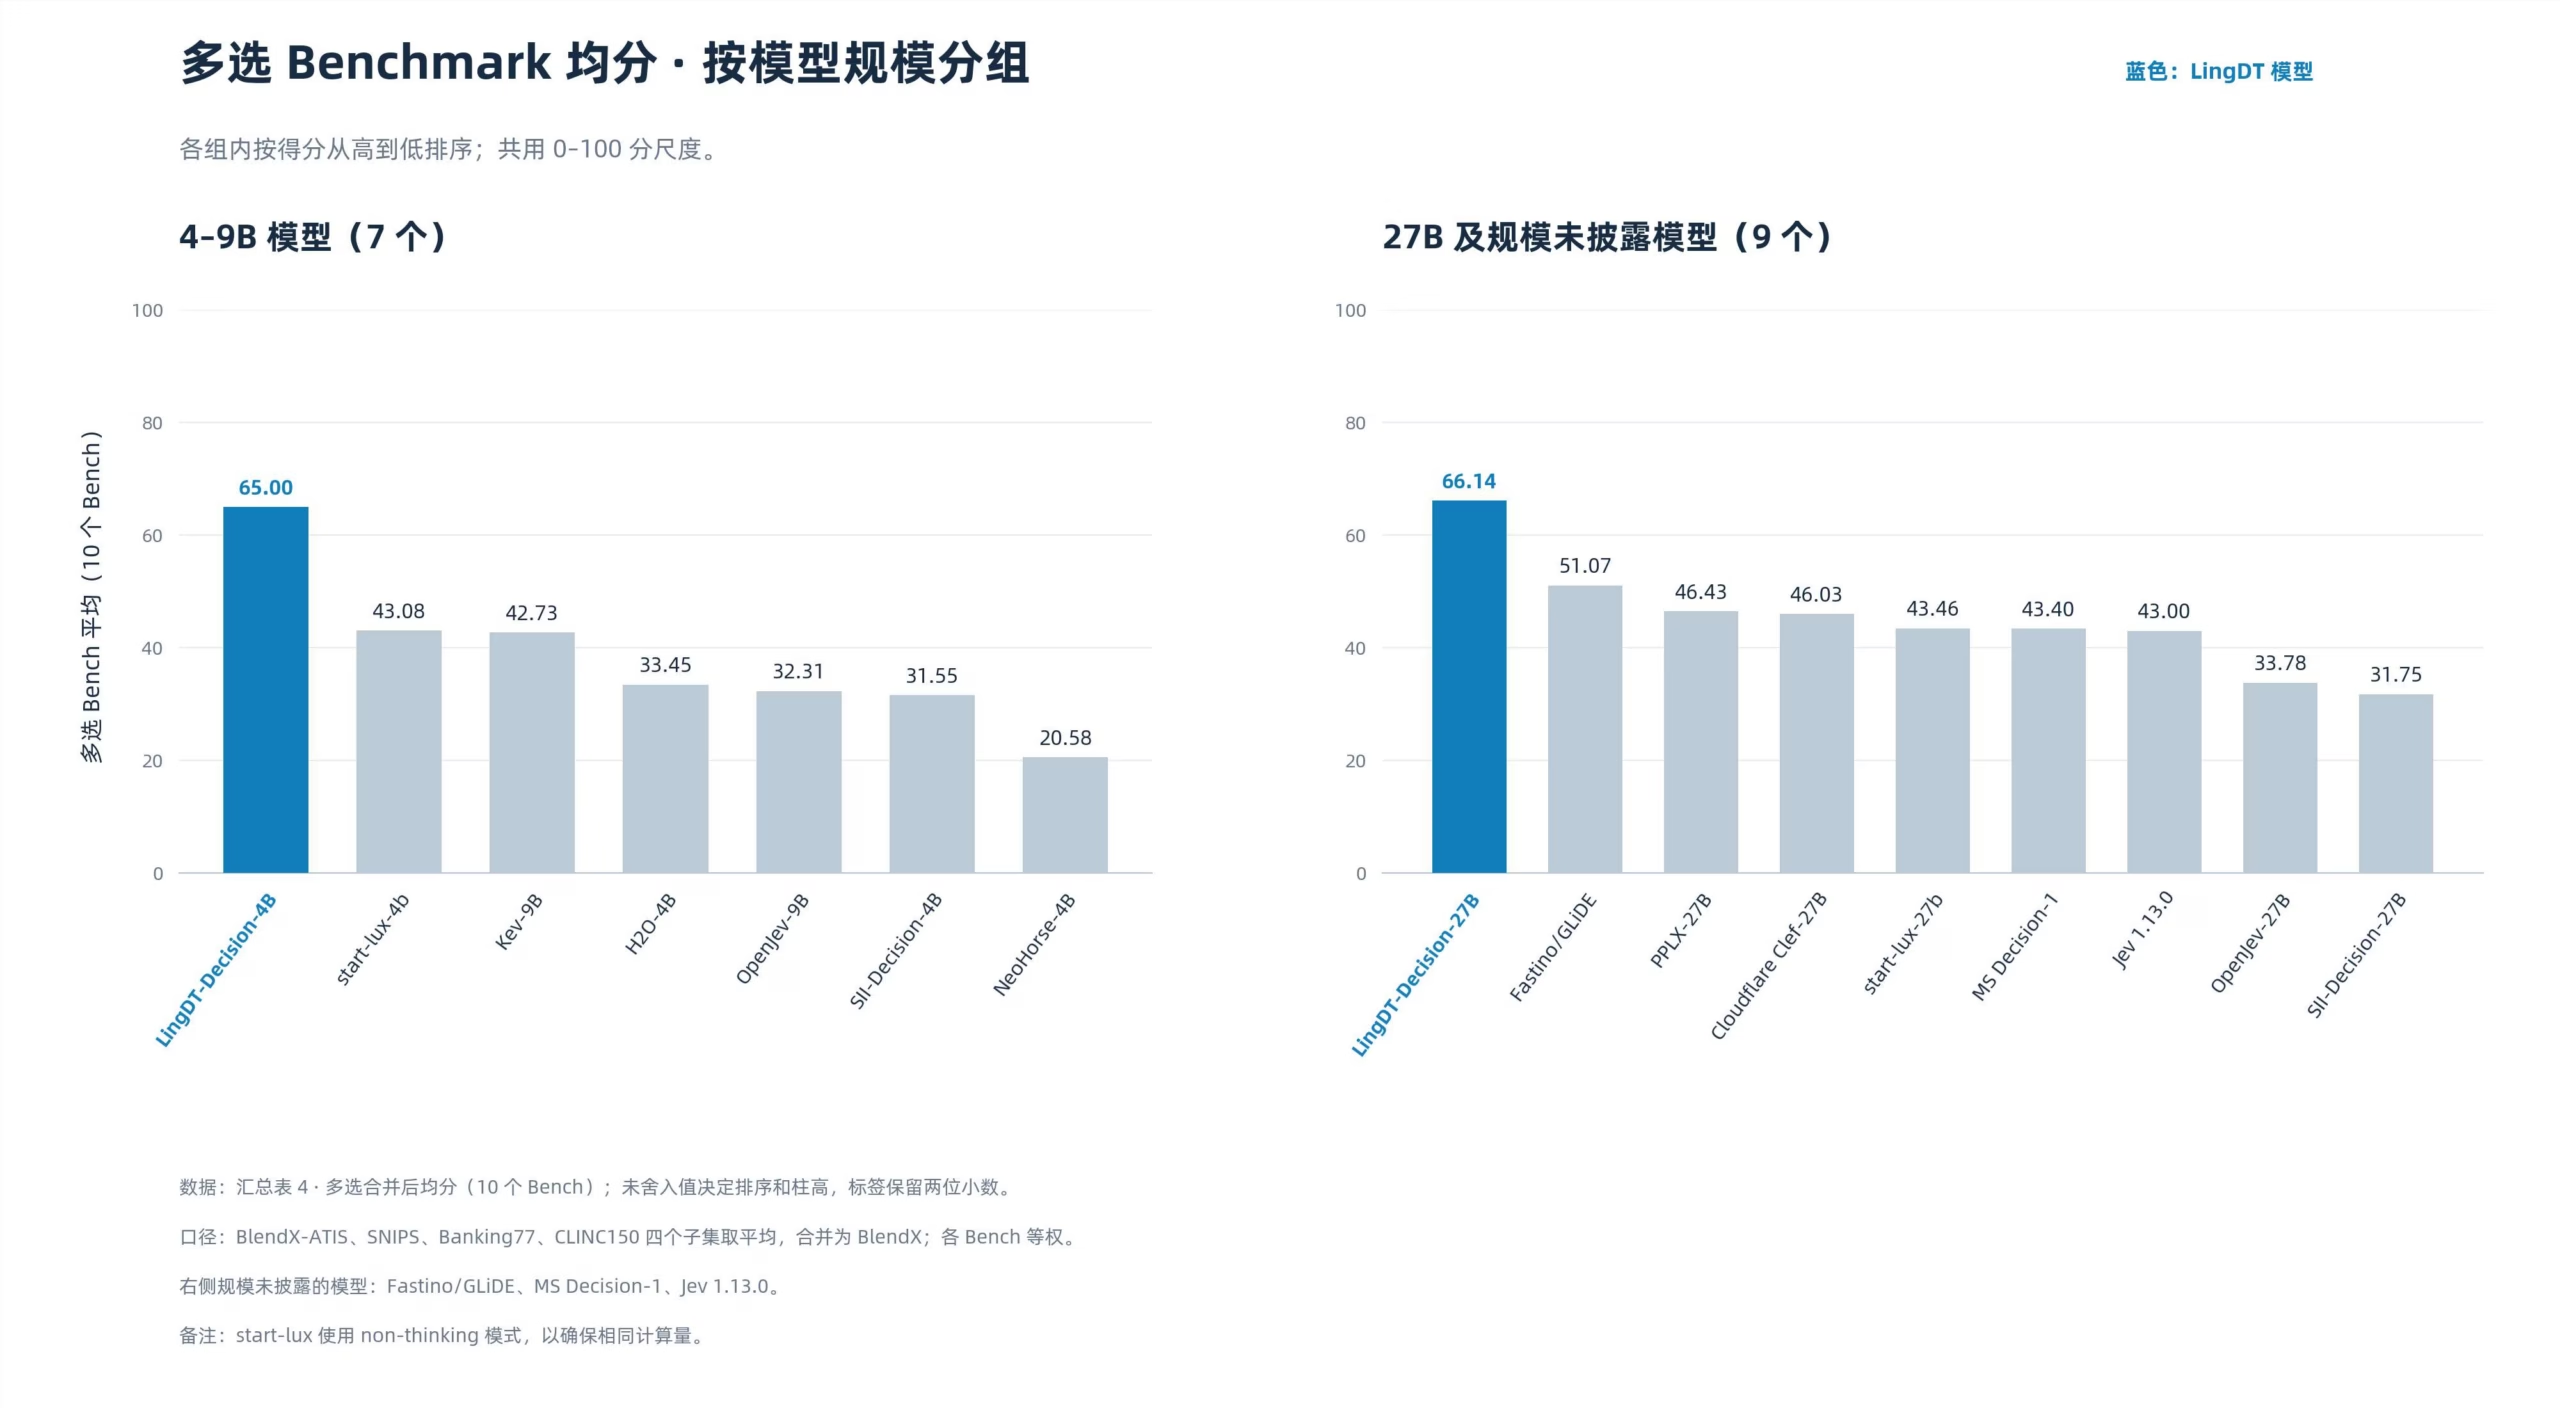
图 4:告别逐字生成的算力浪费!蚂蚁数科重磅发布 LingDT-Decision-1.0 决策大模型:首创原生多选与按序 DAG 决策机制,Token 骤降 97%、时效飙升 10 倍实测全景拆解 核心架构与实测表现拆解
📝 站长洞察 (Editor’s Insight)
蚂蚁数科 LingDT-Decision-1.0 的问世,代表了企业级大模型工程架构的一次重大思想转变——从盲目崇拜“大而全的单体生成模型”,走向理性务实的“生成与决策分层解耦”。在实际企业的生产业务流中,超过 80% 的高频调用并非为了生成抒情长文,而是在数十毫秒内快速且稳定地给出布尔值、枚举项或有序执行流。传统自回归模型为了吐出一个“true”或一个 JSON 字段,不得不反复前向推理几十上百步,既产生了不可接受的算力开销,又引入了因格式解析异常引发下游崩溃的单点脆弱性。LingDT 采用判别式的空间约束推理与原生 DAG 编排,在根源上切断了模型幻觉与格式漂移的可能。更为关键的是,4B 和 27B 的紧凑参数体系极其便于企业本地私有化集群的高并发部署,完全可以充当“前置智能网关路由器”,先过滤并消化掉绝大部分高频结构化决策流量,仅将极少数开放式长程逻辑委托给昂贵的生成基座。这种“轻决策、重执行、按需调用”的混合多智能体系统(MAS),才是破解当下大模型企业落地 ROI 困局的最优工程解法。


