

💡 站外导读:在常规软件工程架构中,命令行终端(TUI)始终与底层操作系统内核、系统调用(Syscalls)及磁盘文件系统紧密绑定。每一次 mkdir 或 vim 命令,本质上都是状态机在物理存储层的一组精准状态变迁。然而,海外极客开发者 Simon Edwardsson 却另辟蹊径,抛出了一项颠覆认知的开源实验——WorldTUI。该项目在本地完全剥离了 Linux 运行时与物理文件系统,仅依赖一个 4-bit 量化后仅 208MB 的轻量端侧语言模型,通过对终端交互画面的纯符号预测,实现了对 Bash、Vim、Python 与 tmux 的以假乱真式“全景表演”。这一实验不仅打破了软件必须物理执行的传统教条,更揭示了语言模型作为神经通用状态机(Neural State Machine)的惊人仿真潜力。
一、颠覆传统的神经终端:没有内核,全靠大模型“飙戏”
在计算机技术发展史中,终端(Terminal)始终被视作最为精确、最不容差错的符号交互界面。你敲下一个字符,内核调度器唤醒驱动,TTY 子系统捕获输入并回显,Shell 解析 AST 语法树并 fork 出物理子进程。然而,开源项目 WorldTUI 却用极其戏剧性的方式彻底颠覆了这套底层铁律。
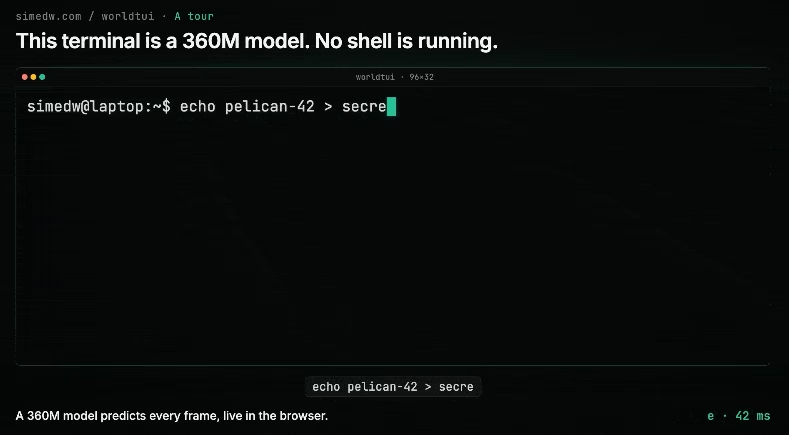
当你打开 WorldTUI 时,展现在你眼前的是一个黑底白字、看似平平无奇的纯文本终端。你可以娴熟地敲击 ls -la 查看目录,使用 cd /var/log 切换路径,用 mkdir project 建立文件夹,甚至可以直接拉起 vim test.py 编写代码,或者启动 tmux 切分多窗口并发运行。在肉眼可见的维度上,光标的跳动、颜色的高亮、返回的报错输出与真实 Ubuntu/Debian 终端几乎毫无二致。
但令人震撼的底层真相是:你面前没有任何 Linux 虚拟机、没有 Docker 容器、没有文件系统,甚至没有任何一行真实系统调用被物理执行过!屏幕上跳动的所有字符、目录列表、文件内容以及报错信息,百分之百是由一个经过专项微调的端侧 AI 模型根据你的按键序列实时“脑补编造”出来的。你给它指令,它负责全天候“扮演”一台电脑。
二、技术底座与极限定量:从 3.6 亿参数蒸馏到 208MB 端侧极客玩物
实现这样逼真的“系统级演技”,背后依赖的核心模型并非需要万卡集群支撑的千亿参数巨兽,而是一个经过极限工程压缩的超轻量神经模型。开发者 Simon Edwardsson 选择以开源代码模型 Qwen2.5-Coder-0.5B 作为基础底座。
通过有针对性的架构剪枝与领域微调,开发者训出了一个实际激活约 3.6 亿参数、初始未量化权重体量为 716MB 的专属小模型。为了让该模型能够直接嵌入桌面原生 TUI 应用并在极低硬件资源下秒级响应,团队引入了激进的 4-bit 整数标量量化(Int4 Quantization):
- 模型体量极限压缩:经过 Int4 物理量化后,模型权重文件骤降至 208MB,普通电脑甚至手机端侧均可一键载入内存。
- 首字预测极低延迟:由于模型体积极小且词表进行了专门针对 ANSI 控制符与终端字符集的大幅裁剪(Vocabulary Trimming),每次按键后的首字预测延迟稳定在数十毫秒以内。
- 并行行级预测加速:针对终端常见的整屏刷新,算法采用了并行逐行预测(Parallel Row Prediction)机制,有效解决了逐 Token 生成速度追赶不上终端高速滚屏的物理瓶颈。
三、20 亿 Token 与 1.2% 错别字注入:极度严苛的 Docker 采集流水线
模型之所以能把终端各组件的细微反应“演”得丝丝入扣,关键在于开发者设计了一套自动化且极其狡黠的真实行为数据采集管线。演技不是凭空生成的,而是用 20 亿 Token 的真实人类操作痕迹浇灌出来的:
- 真实环境沙箱阵列:开发者在云端搭建了数十个彼此隔离的 Docker 容器矩阵,内部运行正统的 Linux 操作系统,并预装 Bash 5.2、Vim 9.1、Python 3.12 及 tmux 核心工具。
- 全自动任务模拟与人类手抖仿真:编写高并发仿真脚本,自动随机生成随机用户名、嵌套文件树、各类代码片段与编译调试任务。更精妙的是,脚本在模拟逐键敲击时,刻意掺入了 1.2% 的随机打字错误(Typos)及退格(Backspace)修正行为,完美复制人类在真实敲键盘时的停顿与手抖逻辑。
- 屏幕快照与状态全息录制:每次按键触发后,脚本均精准捕获 TUI 帧缓冲(Frame Buffer)的差异数据。整个工程累计录制了 33.6 万段完整操作轨迹,汇聚成约 20 亿 Token 的高质量终端动态序列。
- 自愈纠错机制(Self-Healing Samples):当模型在早期训练中出现“自相矛盾”(例如刚建了文件却在下一次
ls时忘记)时,采集引擎会立即截取真实环境的正确输出构建对比损失函数,强制训练模型掌握“即便前面撒了谎,后面也要在上下文内逻辑自洽”的圆谎能力。
四、架构对比:传统虚拟化/容器 vs 神经状态仿真 (WorldTUI)
为了让架构师与开发者更直观地理解 WorldTUI 所代表的技术范式跃迁,我们将传统虚拟化方案与该神经终端进行了全维度对比:
| 对比维度 | 传统系统 (Linux / KVM / Docker) | WorldTUI (神经符号状态仿真) |
|---|---|---|
| 底层计算底座 | 物理 CPU / 虚拟化超线程 / 真实系统调用 | 单卡 GPU 或 CPU 神经推理 (Qwen2.5-Coder 0.5B) |
| 存储与文件状态 | EXT4 / XFS 磁盘 Block 与 Inode 物理落盘 | 无物理文件;仅依赖 KV Cache 上下文动态记忆 |
| 内存与镜像体量 | 数百 MB 至数 GB (OS 镜像 + 运行时依赖) | 仅 208MB 权重镜像,轻量纯绿免配置 |
| 安全隔离性 | 存在容器逃逸与内核 CVE 漏洞风险 | 物理级绝对免疫:黑客无论敲什么都不会发生物理越权 |
| 确定性与边界 | 100% 确定性;严格遵循 POSIX 标准 | 概率性分布;极端复杂长程任务存在幻觉穿帮风险 |
五、局限性与穿帮风险:复杂任务下的符号漂移与“编造穿帮”
尽管 WorldTUI 在日常简短命令(查看日志、编辑几十行配置文件、运行简短循环脚本)中展现出了令人惊叹的自洽性,但作为概率自回归模型,其固有的物理天花板依然清晰可见:
首先是跨会话与上下文长度耗尽后的“失忆”。由于没有物理磁盘的 Inode 映射,一旦当前 Terminal 会话的上下文窗口被刷满,或者用户执行了 clear 并刷新了 Prompt,之前在 Vim 中精心编写的代码片段可能会发生不同程度的语义畸变甚至凭空消失。
其次是复杂逻辑与数学计算的自相矛盾。如果你在 WorldTUI 的 Python 环境中让其计算极其庞大的高精度浮点数,或者执行深层递归的复杂算法,模型由于没有物理算术逻辑单元(ALU)的支持,输出的数值往往是基于常识经验的“合理猜测”,而非精密数学结果。
然而,瑕不掩瑜。开发者明确表示将在一周内全网开源该模型的完整权重与量化文件,并提供一键跑在桌面浏览器的 WebAssembly/WebGPU 体验版本。这不仅为极客玩家提供了绝佳的玩具,更为整个 AI 行业打开了一扇审视“端侧微型世界模型”的全新窗口。
📝 站长洞察 (Editor’s Insight)
WorldTUI 的诞生绝非一次单纯博人眼球的极客恶搞,而是对大语言模型作为“通用人机交互界面仿真器(Interface Simulator)”能力的一次极具启发性的工程探索。长期以来,无论是黑客蜜罐(Honeypot)搭建、自动化网络安全红蓝对抗测试,还是大规模多智能体(Multi-Agent)代码执行沙箱训练,业界始终受制于虚拟机或 Docker 启动慢、资源消耗高、以及容器逃逸的安全隐患。WorldTUI 证明了一种颠覆性的可能:只要端侧小模型学会了系统组件的行为模式,我们完全可以用零硬件特权、零文件落地的“神经符号生成”来低成本、高并发地欺骗攻击者或供 Agent 练手。这种“以幻觉对抗真实、以拟态重塑接口”的技术路径,很可能在未来两到三年内演进为新一代网络安全和具身操作系统不可或缺的基础设施组件。


