

💡 站外导读:在 RAG 知识库与企业级 Agent 落地中,海量超长文档(如数百页招股书、数千页技术白皮书、复杂跨页表格)的解析精度始终是决定问答质量的最底层瓶颈。传统 OCR 的单页切片与生硬拼接常常导致语义断裂、跨页公式错乱和图表上下文遗失。百度文心团队最新开源的端到端文档解析模型 Unlimited OCR 2,凭借首创的‘SR-SWA 稀疏参考滑动窗口注意力’与‘无限解码机制’(Unlimited-Horizon Decoding),彻底打破了文档页数硬性限制,在 MPDocBench 和 MarathonDocBench 上刷新 SOTA 纪录,单步解码提速高达 7 倍。本文为您带来全方位的架构拆解与工业级选型实测。
1. 从 OCR 1.0 单页识别到 3.0 端到端统一建模的进化史
在企业级生成式 AI 与大模型知识库(RAG)系统中,数据准备流水线一直是决定最终产出质量的核心基石。然而,面对长达数千页的学术专著、复杂格式的证券财报以及混合跨页表格的法律合同,传统文档数字化方案正陷入难以逾越的工程瓶颈:
- OCR 1.0 时代(单页切片识别):将 PDF 或扫描图像拆分成独立单页分别调用文字识别,再由规则代码生硬拼接,极易引发跨页段落撕裂、表格表头丢失与公式乱序;
- OCR 2.0 时代(有限窗口扩展):引入多模态视觉语言模型(VLM),但受到 Transformer 上下文长度硬限制,往往仅能稳定解析数十页,一旦页数堆叠至上百页,计算资源与显存立即暴跌至 OOM(Out of Memory);
- OCR 3.0 时代(全量端到端统一建模):将跨页选择、回看验证与即时理解融入统一大模型端到端推理管线中,实现“任意页数无损解析”。
近日,百度文心(Baidu Wenxin)技术团队正式开源了其划时代力作 —— Unlimited OCR 2。该模型官方宣称突破了传统长文档处理的页数天花板,能够一次性吞吐并解析超过 3600 页的长篇书籍与档案,在多项权威基准测试(MPDocBench、MarathonDocBench)中均斩获 SOTA(State-of-the-Art)卓越评级。
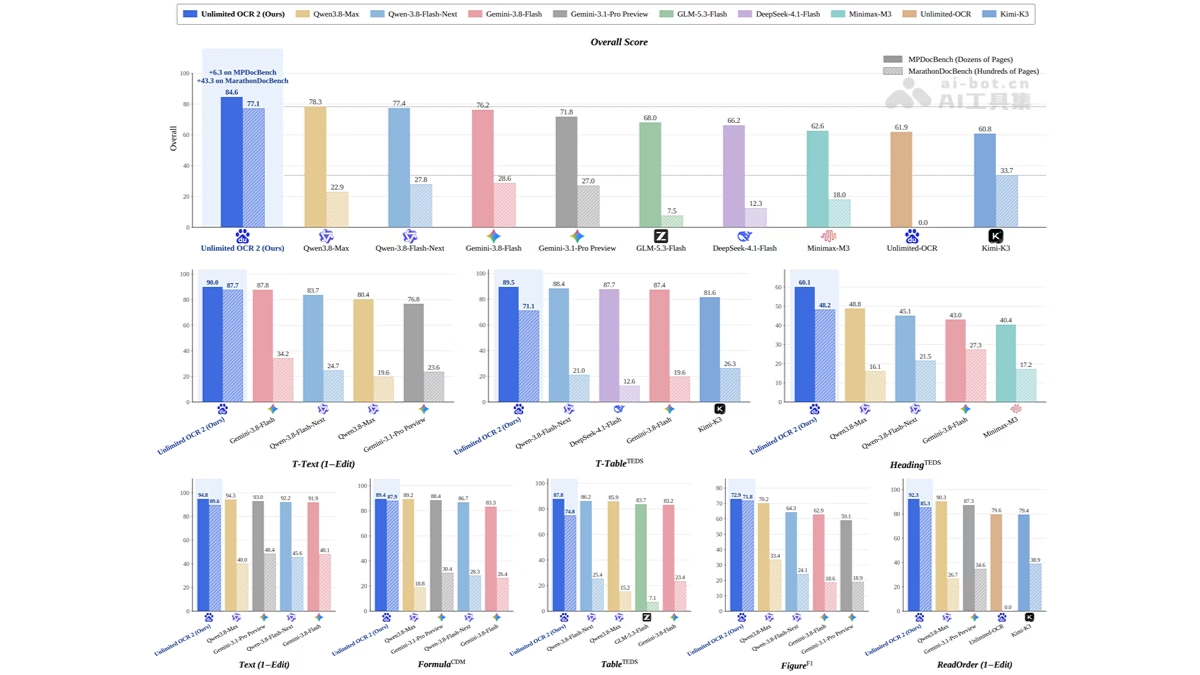
图 1:百度文心开源 Unlimited OCR 2 端到端长文档解析官方工作流与评测看板(来源:Baidu Open Source)
2. 核心技术原理拆解:人类抄书视角的算法映射
Unlimited OCR 2 之所以能够在数千页的超大跨度下保持极低的显存开销,核心归功于其对人类阅读与抄写心智模式的仿生学抽象:
2.1 SR-SWA 稀疏参考滑动窗口注意力
人类在阅读或摘录超长书籍时,绝不会在每一秒钟都把大脑记忆铺满整本书的全部字句,而是“聚焦当前页,仅在必要时精准回看前文相关段落”。基于此灵感,Unlimited OCR 2 首创了 SR-SWA(Sparse Reference Sliding Window Attention) 机制:
- Page Gate 门控路由:通过轻量门控网络,将每个当前 Query 的视觉参考视野从全量千页文档迅速收敛至高度相关的目标页面,并建立精确的跨页拓扑坐标;
- Token Buckets 关键特征桶:引入注意力权重排序的动态视觉 Token 桶,专门用于捕捉远距离跨页图表、章节目录与脚注引用,彻底消除了全量全局注意力中高达 90% 以上的无用空白与冗余计算;
- 解码吞吐飙升:实测基准显示,SR-SWA 的单步解码速度相比传统 Full Attention 暴涨 7 倍,相较上一代 R-SWA 亦提升 5.6 倍。
2.2 Unlimited-Horizon Decoding 无限解码引擎
为了解决长序列自回归生成中的显存线性膨胀问题,模型重构了解码器状态缓存策略。通过引入动态跨步淘汰机制,将历史上下文的显存占用严格钳制在安全阈值以内,使得模型在持续处理数百页、数千页时,不会被固定的硬件显存墙所扼杀,真正兑现了“Unlimited”的架构承诺。
3. 工业级横向选型对比:Unlimited OCR 2 vs MinerU 深度博弈
在当前开源中文文档理解领域,上海 AI Lab 孵化的 MinerU 与百度文心 Unlimited OCR 2 是最为瞩目的两大重量级选手。针对企业级 SRE 架构师与系统工程师的选型诉求,我们整理了全维度的技术参数对比矩阵:
| 对比维度 | 百度文心 Unlimited OCR 2 | 开源经典 MinerU |
|---|---|---|
| 底层建模范式 | 原生端到端长文档模型,统一表征 | 流水线管线(版面+公式+表格+文字拼接) |
| 长文档极限承载 | 单次处理 3600+ 页书籍,保持全局上下文 | 强项在几十页单份,千页需依赖外部批处理分块 |
| 跨页结构连贯性 | 极强(SR-SWA 原生捕捉跨页表格与上下文) | 依赖后处理规则拼接,复杂跨页存在截断风险 |
| 输入格式生态 | 聚焦高精 PDF、扫描件与图文文档 | PDF、Word、PPT、Excel、EPUB、OFD 全格式支持 |
| 工程部署与生态 | 依托 Transformers / SGLang 定制推理 | CLI / SDK / WebUI / Docker 一应俱全,生态极其成熟 |
| 基准评测口径 | MPDocBench 84.6、MarathonDocBench 77.1 | 基于 PP-OCRv6 升级版,OCR 精确度提升约 11% |
4. RAG 与企业级智能体的工作流落地指南
对于计划将 Unlimited OCR 2 集成至生产级数据管道的开发团队,官方与社区推荐的标准接入步骤如下:
- 获取开源权重与代码:通过官方 GitHub(
https://github.com/baidu/Unlimited-OCR)与 Hugging Face 模型空间拉取最新模型权重; - 部署高效推理服务:推荐基于定制化的 SGLang 框架构建高并发推理网关,最大化激活 SR-SWA 算子在消费级显卡(如 RTX 4090)上的显存复用效率;
- 规避传统分块丢失:在接入 LangChain、LlamaIndex 等知识库框架时,可直接关闭传统基于 Token 的粗暴字符切片策略,直接利用模型导出的高保真结构化 Markdown,以章节、二级标题和完整数据表格为语义最小单元,显著提升后续检索召回与问答准确率。
📝 站长洞察 (Editor’s Insight)
在当前 AI 行业狂热追逐千亿大模型推理能力的浪潮下,文档解析等数据前置处理层往往被低估,然而在真实的企业级 RAG 和私有化智能体项目中,‘Garbage In, Garbage Out’是不变的正义铁律。传统的文档处理流水线(版面分析 -> OCR文字提取 -> 表格还原 -> 公式识别)链路极长,各个子模型的误差级联放大,往往导致最后送入大模型的上下文千疮百孔。百度文心通过 Unlimited OCR 2 证明了端到端 Vision-Language 模型在超长文档理解上的绝对优势:模拟人类‘阅读当前页、动态回看前文’的认知习惯,用稀疏桶替代全量注意力,在兼顾显存开销的同时保全了跨页全局连贯性。这不仅是 OCR 技术的一次跨越,更是为大模型落地铺设了一条平整、高保真的数据高速公路。


