

💡 站外导读:在通用大模型加速向具身物理实体渗透的当下,机器人“看得清、想得明”却始终受困于“摸不准、拿不稳”的指尖感知真空。2026年11月10日,蚂蚁灵波科技正式开源触觉基础模型 LingBot-Touch,历经近5000小时真机触觉数据预训练,一举击穿磁触觉、视触觉与压阻式三大主流传感壁垒,实现跨硬件、跨机械手的高泛化手感复用。本文深度拆解其指尖坐标空间映射机制、Token 化表征架构与 26 项严苛真机评测数据。
一、具身智能的致命短板:为什么视觉大模型搞不定“拧瓶盖”?
随着以 VLA(Vision-Language-Action)为代表的多模态通用大模型持续进化,具身机器人在语义理解、空间几何推断与宏观路径规划上的能力日新月异。然而,一旦进入真实物理世界与非刚性物体、微小零件接触的毫厘区间,机器人系统就会暴露出致命的“手感缺失”。
在绝大多数微距精细操作场景中,机器人即使能够通过双目视觉或深度点云精准对准物体,手指接触物体表面的瞬间也会面临严重阻碍:
- 视线物理遮挡:机械手指腹与被操作物体(如瓶盖外沿、书页边角、螺钉接缝)接触时,关键接触点几乎必然被自身结构遮蔽,光学视觉传感器彻底失效。
- 接触力学微变盲区:以转动瓶盖为例,指腹是仅仅在光滑盖壁上打滑,还是已经克服静摩擦力带动螺纹旋转?两者的外部视觉像素特征高度相似,但力学状态截然相反,只有高频指尖触觉能捕捉毫秒级的微滑移与接触法向力。
二、三大传感原理统合:LingBot-Touch 统一指尖空间表征解密
长期以来,机器人触觉领域饱受“硬件孤岛”困扰。视触觉(GelSight/视触觉膜)、磁触觉(三轴磁阻阵列)与压阻式柔性薄膜等传感方案各有千秋,但原始信号输出格式、采样率与物理拓扑各不相同,以往算法模型只能与特定硬件强绑定,硬件换代即意味着存量触觉训练数据完全作废。
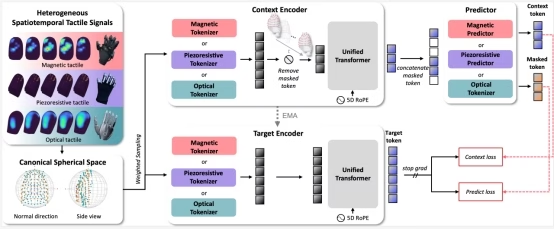
LingBot-Touch 的核心工程突破在于引入了类似大语言模型 Tokenizer 的理念:建立统一指尖物理坐标系与触觉表征编码层。
| 传感路线 | 物理原理与优势 | 以往复用痛点 | LingBot-Touch 统合方案 |
|---|---|---|---|
| 磁触觉 | 微型永磁体受压位移触发霍尔效应,动态响应极快(>500Hz) | 触点离散,非线性强,磁漂移校准复杂 | 独立编码入口 -> 空间拓扑归一化 -> 统一触觉 Token |
| 视触觉 (GelSight) | 微型相机捕捉弹性体表面微纹理形变,空间分辨率极高 | 数据量大,难以直接喂给低延迟动力学控制环 | 光学流场特征提取 -> 映射至标准化指尖空间网格 |
| 压阻式 (Piezoresistive) | 柔性压阻阵列测量电阻变化,轻薄且贴合度极高 | 存在物理滞后效应与温漂误差 | 时序时空补偿模块 -> 统一表征对齐 |
LingBot-Touch 针对不同传感原理设置专用的底层物理信号编码器,在将几何各异的触点网格投射到同一标准指尖坐标系后,通过深度时空 Transformer 学习接触位置、法向与切向分力以及随时间演进的微滑移动态,最终输出维度统一的 Tactile Token,彻底实现了跨传感器、跨灵巧手、跨策略模型的通用复用能力。
三、26项真机极限实测:任务成功率全维度提升14~26个百分点
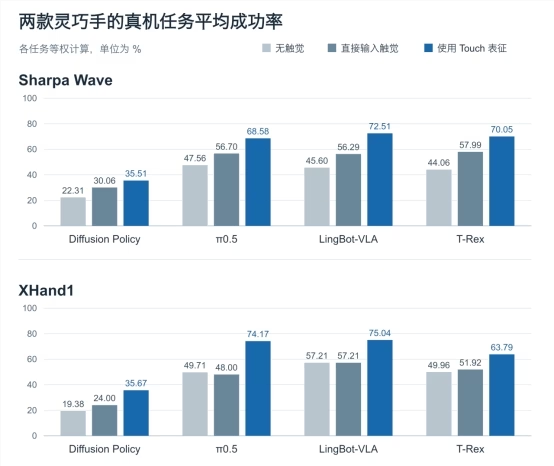
在工程实用性方面,蚂蚁灵波团队在 Sharpa Wave 与 XHand1 两款行业主流灵巧手上部署了涵盖 26 种严苛操作的真机对照基准。涵盖包括翻薄书页、精准拧紧防盗瓶盖、盲摸麻将牌面点数、拿捏软脆糕点等高难度接触任务。
评测接入了当前学术与工业界最主流的四大多模态控制模型:LingBot-VLA、π0.5、Diffusion Policy 与 T-Rex。真实数据展现了断代式的性能跃迁:
- 无触觉基线:依赖纯双目视觉引导,平均任务综合成功率仅在 48%~58% 区间徘徊,在瓶盖螺纹卡扣与薄纸翻折时频繁出现空转或压碎。
- 直接输入原始信号:未经表征归一化的原始触觉数据因噪声与过拟合,成功率仅微弱提升至 60%~65%。
- 接入 LingBot-Touch 统一表征:四大动作模型的任务平均成功率全线提升 14 至 26 个百分点!以 T-Rex 控制 Sharpa Wave 拧瓶盖任务为例,成功率直接从基线的 56.25% 飙升至 90.00%。
四、接入 LingBot-VLA:具身原生通用大脑的“端到端全闭环”
LingBot-Touch 并非孤立的触觉算法库,而是已被深度集成进蚂蚁灵波自主研发的具身原生通用大脑体系 LingBot-VLA。通用大脑在高精度空间感知与高动态交互规划的基础上,通过指尖触觉 Token 补齐了微米级闭环控制的关键一环。
这一开源举措意味着开发者无需重金采集数千小时专有硬件触觉数据,即可直接调用预训练好的 LingBot-Touch 权重,让人形机器人具备如人类般敏锐的“盲摸感知与自适应抓取力道”。
📝 站长洞察 (Editor’s Insight)
长期以来,具身智能行业深陷“重视觉轻触觉”的偏见泥潭。绝大多数人形机器人演示视频只能在静态或受控环境下进行脆弱抓取,一旦遭遇遮挡或毫厘级摩擦力偏差,抓取姿态瞬间瓦解。蚂蚁灵波开源 LingBot-Touch 的真正里程碑意义,在于它没有走“专用硬件专用驱动”的封闭死路,而是效仿大语言模型 Tokenizer 的理念,将异构传感物理量统合为通用的触觉 Token。这意味着硬件厂商可以自由迭代传感器,算法工程师可以专注于上层策略,一举解耦了具身智能研发的软硬件耦合诅咒。未来 1~2 年内,触觉基础模型必将成为人形机器人标配的基础设施层。


