

💡 站外导读:大语言模型(LLM)向边缘端与移动设备的下沉,长期受困于手机内存吞吐受限、功耗发热陡增以及端侧量化后智商暴跌的“不可能三角”。阿里巴巴淘宝 MNN 团队今日正式开源专为移动端原生打造的超轻量模型 —— MNN-Pocket-0.3B。该模型以仅仅 3 亿参数的极简身躯,在 iPhone 18 Pro 真实端侧跑出了高达 350 token/s 的惊人离线解码吞吐,并将部署文件与运行内存分别压榨到 173MB 和 228MB。本文深入剖析其 64K 精简词表、W4A16 量化感知训练与投机解码底层工程黑科技。
一、 破解移动端“不可能三角”:MNN-Pocket-0.3B 的极简工程哲学
在移动端部署大模型历来是系统工程领域的硬骨头。手机操作系统出于后台保活与多任务调度机制,分配给单个 App 的物理常驻内存极其严苛,一旦显存或内存超标就会被系统直接 OOM 强杀。此外,用户对手机发热、掉电以及输入卡顿有着极高的敏感度。
淘宝 MNN 团队没有盲目卷入数十亿参数的云端军备竞赛,而是从真实手机场景的物理约束出发,将“手机应用原生大模型”量化为四大约束指标:
- 解码吞吐底线:实机解码速度必须突破 200 token/s,为用户提供毫无迟滞感的打字机流式呈现;
- 内存上限锁死:运行时峰值内存增量必须严格锁死在 300MB 以内,绝不挤占宿主 App 的图片缓存与页面渲染空间;
- 功耗零感化:频繁调用不得引起机身明显发烫,百次日常调用电量损耗控制在极微小比例;
- 高保真指令遵循:在极致压缩参数的前提下,仍能精准理解中文复杂语义并执行结构化输出。
二、 核心基准硬核实测:离线 350 token/s 与百次调用仅耗电 0.3%
在主流移动端硬件平台的严苛实测中,MNN-Pocket-0.3B 展现出了颠覆性的吞吐与功耗表现:
| 测试设备与硬件环境 | 部署格式与体积 | 峰值运行内存 (RAM) | Prefill 吞吐 | Decode 解码吞吐 |
|---|---|---|---|---|
| Apple iPhone 18 Pro (离线测试) | INT4 MNN (173MB) | 约 230 MB | 超高速首字命中 | 350 token/s |
| Apple iPad Pro M5 (Metal 后端) | INT4 MNN (173MB) | 228 MB (对比Qwen3少47%) | 8,721 token/s | 466 token/s (达Qwen3的1.63倍) |
| 一加 13 (骁龙 8 至尊版) | 4-bit 量化版 | 稳控 250 MB 以内 | 毫秒级 Prefill | 100 次基准任务仅耗电 0.3% |
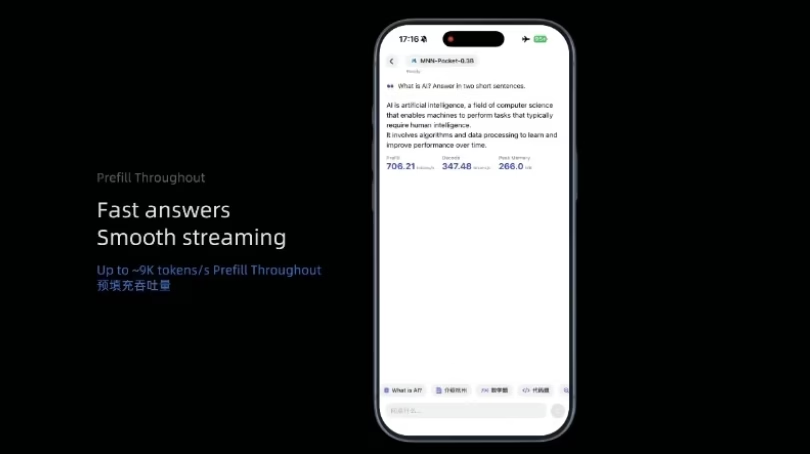
1. 内存减半、速度飙升 1.63 倍
在 iPad Pro M5 的同等测试配置下,业界标杆 Qwen3-0.6B 的部署体积达 340MB、内存增量 427MB;而 MNN-Pocket-0.3B 部署体积仅 173MB、内存增量仅 228MB,部署体积缩减了 49%,内存增量减少了 47%,Decode 吞吐反而反超 63%,彻底扫清了 App 集成的包体积与内存顾虑。
2. 综合能力跨级碾压
在权威评测基准中,该模型英文 IFEval 达到 73.20,中文指令遵循 IFEval-zh 高达 74.59。在涵盖中英文通识、因果推理、数学与代码的 11 项综合评测中,平均得分达 50.00 分,超越了 MiniCPM4-0.5B 与 Qwen3-0.6B 等更大规模的同类模型,其中中文数学 MGSM-zh 斩获 51.20 分,代码生成 HumanEval 达到 53.66 分。
三、 底层黑科技:64K 中文精简词表、W4A16 QAT 与 DFlash2 投机解码
MNN-Pocket-0.3B 能够实现如此惊艳的“以小博大”,得益于淘宝技术团队在模型架构层面的三项手术刀级创新:
- 57% 剪枝的 64K 中文高效词表:传统多语言大模型的词表通常在 150K 以上,导致嵌入层(Embedding)与最后一层反向投影占据了模型近半的参数与显存。团队专为中文互联网语料重构词表,由 151K 精简至 64K,大幅压减了参数冗余;
- 端侧定制 W4A16 量化感知训练 (QAT):配合 MNN 推理引擎专门针对 ARM NEON 与 Apple Metal 汇编优化的低比特算子,在保证激活精度的同时将权重量化至 4-bit,吞吐拉满至硬件极限;
- DFlash2 块级投机解码 (Speculative Decoding):针对投机解码草稿模型专门优化,配合块级验证算法,特定长文本补全任务下的解码吞吐可达常规自回归解码的 2.06 倍。
四、 六大开源版本矩阵:全流程赋能端侧生态
淘宝 MNN 团队此次采用了极为彻底的“全链路全开源”策略,一次性公开了覆盖预训练、精调、端侧优化到下游任务的六大版本矩阵:
- MNN-Pocket-0.3B-Base:原生预训练底座,专为二次预训练与领域迁移研究打造;
- MNN-Pocket-0.3B-SFT:指令对齐版本,面向强化学习、模型蒸馏与学术消融;
- MNN-Pocket-0.3B:通用业务指令调用版本,开箱即用;
- MNN-Pocket-0.3B-MNN:端侧专属 W4A16 QAT 版本,直通 MNN 引擎极限性能;
- MNN-Pocket-0.3B-DFlash2:投机解码专属草稿模型;
- MNN-Pocket-0.3B-Dec:搭载决策头,专精于端侧分类、候选推荐与意图路由。
📝 站长洞察 (Editor’s Insight)
过去工业界普遍认为“百亿以下无智商”,但淘宝 MNN-Pocket-0.3B 的开源彻底打破了这种傲慢与偏见。在电商输入法联想补全、本地 UI 指令路由、离线文本摘要以及应用内智能意图拦截等高频垂直场景中,移动端用户需要的绝非动辄调用千亿云端集群、等待数秒网络往返的“全知学者”,而是瞬时响应、完全离线、不消耗蜂窝流量且零隐私泄漏的“毫秒级本地协处理器”。淘宝 MNN 团队的这次开源不仅树立了端侧小模型的性能新标杆,更为整个端智能 Agent 的普及铺平了最后几百米物理道路。随着更多类似 0.3B 极致小钢炮的涌现,端云协同架构将从理论探讨全面演变为移动 App 架构师的标准必修课。


