

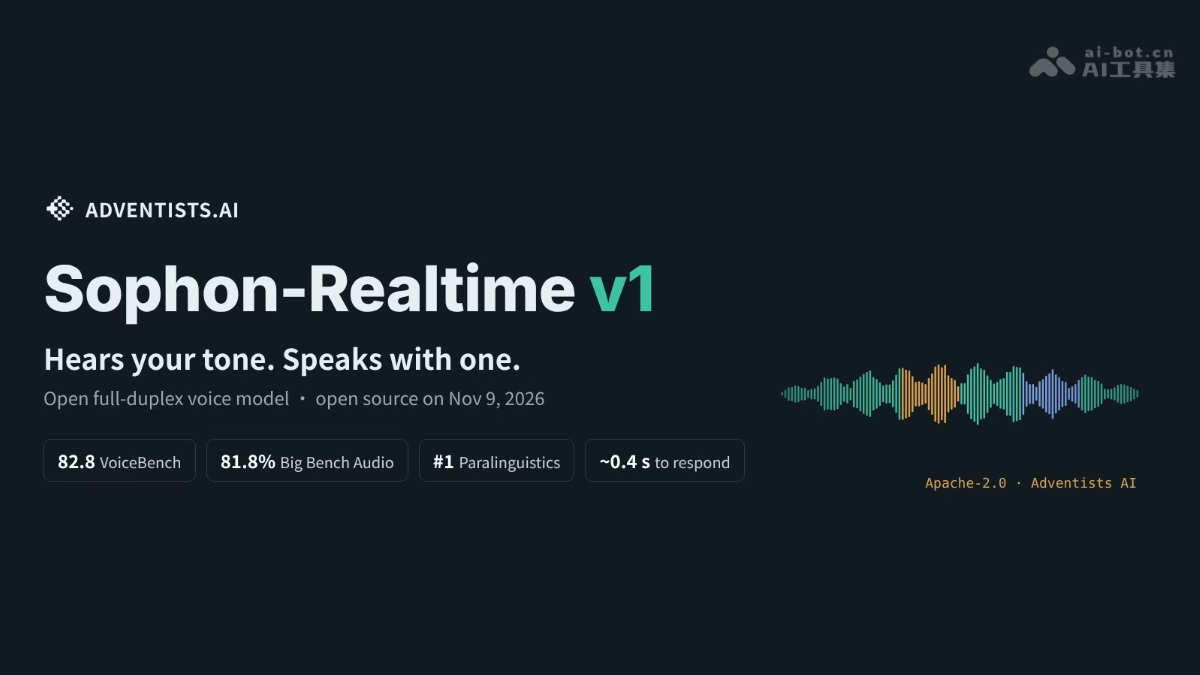
💡 站外导读:传统基于“语音识别 (ASR) + 大模型思考 (LLM) + 语音合成 (TTS)”的分立流水线,长期受困于数百毫秒甚至秒级的链路延迟、僵硬的话轮切换以及被用户打断时无法挽回的抢话事故。AI 降临派(Adventists AI)开源的 32B 端到端全双工实时语音模型 Sophon-Realtime v1,以单一神经网络统一了听、想、说全链路,仅用单个 Token 即可在用户微停顿时精准判断交流意图,并以 82.8 分的高分刷新 VoiceBench 开源纪录,标志着低延迟拟人实时语音正式迈入企业级商用门槛。
一、架构革命:告别 ASR+LLM+TTS 拼装车,32B 单模型统合全双工流
在生成式语音交互技术的发展史上,工程团队长期依靠分立模块串联拼接:麦克风音频送入 ASR 转成文字,大模型处理文字产出回复,最后交由 TTS 模型合成音频下发。这种多级串联流水线存在三重难以克服的系统性缺陷:
- 链路延迟层层累加:每一级模块的缓冲区与网络传输至少耗费 200~400ms,整体端到端延迟往往超过 1.2 秒,谈不上“即说即回”;
- 副语言情感全量丢失:人类对话中的笑意、迟疑、叹气、重音等情绪特征,在第一道 ASR 转换为枯燥文本时被彻底抹去,导致后续大模型无法感知用户的真实心理状态;
- 打断抢话体验灾难:当用户插话时,传统系统必须依赖独立的静音检测(VAD)阈值硬中断,容易出现要么反应迟钝抢着说话、要么用户轻声咳嗽便误中断输出的窘境。
Sophon-Realtime v1 彻底颠覆了这种传统范式。模型基于 32B(320 亿)参数规模的统一 Transformer 大脑,将连续的音频流直接转换为隐空间表征,在单一模型内部同时完成声学感知、语义推理、话轮决策与情感语音流式吐出。项目完全采用 Apache-2.0 商业宽松许可 开源代码与全量权重,企业与开发者可无限制用于商业部署与二次微调。
二、核心机制拆解:单 Token 意图预判与打断草稿智能回收
Sophon-Realtime v1 之所以能展现出宛如真人的流畅对答,关键在于其两大独创的底层时序调度算法:
1. 单 Token 极速话轮预测(Single-Token Turn-Taking)
音频数据以流式分片持续泵入 32B 主干网络。每次检测到用户语声出现微小停顿,模型仅需前向预测单个话轮控制 Token,便能在数毫秒内精准判定当前状态:究竟是“用户已陈述完毕等待回答”、“用户正在短暂停顿思考后续内容”,抑或只是“无意识的嗯/啊附和”。无需任何外置的复杂 VAD 规则模型,极大降低了调度开销。
2. 提前起草与被打断草稿无缝回收(Draft & Drop Protocol)
在用户话语出现第一个自然停顿瞬间,Sophon 便已在后台并发启动回复文本与音频切片的“预起草(Pre-Drafting)”。一旦确认轮到模型发言,首包音频能够即刻以 0.31 秒(Flash 版本)的极致低延迟瞬间喷薄而出。如果在此期间用户紧接着继续表达,该起草内容会在真正输出给声卡之前被系统静默丢弃,绝对不会发生尴尬的“撞车抢话”。在被用户插话打断时,对话上下文仅保留用户实际已经听到的真实片段,确保后续多轮交互逻辑丝毫不乱。
三、权威基准横评:Sophon-Realtime v1 vs MiniCPM-o 4.5 硬核对比
在国际公认的语音全双工基准 VoiceBench 评测集中,Sophon-Realtime v1 斩获了 82.8 分 的惊人战绩,不仅全面碾压 MiniCPM-o 4.5(76.1 分)等同类开源方案,更直接对标 OpenAI GPT-4o-mini-Audio 的商用闭源水准。
| 评测与架构维度 | Sophon-Realtime v1 (AI降临派) | MiniCPM-o 4.5 (面壁智能) |
|---|---|---|
| 产品战略定位 | 专注于全双工低延迟实时“听+说+干活”智能体 | 全模态端到端大模型 (全双工语音为子能力) |
| 核心模型参数量 | 32B 统一网络 (Tag / Flash / E2E 共享基座) | 9B 模块串行 (SigLIP2 + Whisper + CosyVoice2) |
| VoiceBench 综合得分 | 82.8 分 (当前开源全双工第一) | 76.1 分 |
| 首包响应时间 (TTFB) | Flash 版 0.31 秒 / Tag 版约 0.6 秒 | 约 0.21 秒 (INT4 端侧单路交互) |
| 单卡服务并发承载 | 单张 80GB 显卡支持 40 路并发会话 | 主要面向消费级单卡/端侧单路交互 |
| 工具调用与 Agent 落地 | Full-Duplex-Bench Pass@1 达 48% (超 Grok) | 支持常用视觉与常识问答 |
| 开源与商用许可 | Apache-2.0 (代码与权重完全商用免费) | Apache-2.0 |
四、副语言与表情注入:自然叹气、笑声与音画协同
在逼真情感表达方面,Sophon-Realtime v1 独创了“文字领先半步、声音同步跟上”的双轨流式生成机制。当模型在内部生成 Token 时,会自动嵌入副语言表情标记(例如 [laughter]、[sigh]、[cough] 以及 <strong> 重读标记)。这些标记专供声学生成器进行细腻的嗓音与气流控制,而不会被生硬地朗读出来,保证下游日志与审计系统捕获到纯净无污染的结构化文本。
在权威的副语言合成测试 NVV-SuperBench 中,Sophon 的 Tag 版本中文评分达到 0.86、英文达到 0.80,在笑声、轻叹、清嗓等细微情绪波动上达到了业内顶峰。
五、SRE 快速部署与微调实践:单卡 80GB 一键起服
对于架构师与 SRE 运维工程师而言,Sophon-Realtime v1 具备极高的部署友好度。系统仅需一张标准的 80GB 显卡(如 NVIDIA A100 / H100)即可完整加载服务:
# 1. 安装运行环境
pip install sophon-realtime

# 2. 启动全双工服务 (默认监听 8000 端口,自动拉取 42GB 权重)
sophon-realtime serve --port 8000 --model-variant tag

# 3. 接入 OpenAI GPT-Live 协议网关 (支持大模型后端级联)
cd sophon-realtime/live && BUILD=tag PORT=8000 LIVE_PORT=8780 bash start_live.sh
同时,团队全面支持基于阿里开源微调框架 ms-swift 进行 LoRA 风格化微调,允许企业针对客服话术、车载助手或二次元虚拟人设注入专属音色与行业领域知识。
📝 站长洞察 (Editor’s Insight)
语音交互在人机交互界面的终极归宿,从来都不是冷冰冰的“听写打字机”,而是具有情感温度、能够随时被打断并且能够主动协作的实时全双工智能体。过去,由于端到端全双工模型的技术门槛极高,算力开销巨大,几乎被 OpenAI、Google 等巨头垄断。AI 降临派开源的 Sophon-Realtime v1,不仅用 82.8 分的硬核测试成绩刷新了 VoiceBench 榜单,更通过优雅的单 Token 意图预判与单卡 40 路并发吞吐,将全双工实时智能体的部署成本砍到了平民级价位。随着车载座舱、智能客服、具身机器人对自然交互需求的爆发,这项开源突破无疑将成为 2026 年语音 AI 生态的关键转折点。


