

💡 站外导读:通用大模型在垂直产业渗透时,长期困于“空有泛化语言能力、缺乏垂直专业技能”的落差。普通用户面对空白对话框不知如何下笔,专业人士面对没有权威数据打通的 AI 答案不敢采信。字节跳动旗下豆包工作今日正式上线「工作台」功能,首批推出覆盖金融投研、医生、教师、法律、创意等 21 个专业场景的独立 AI 空间。通过预置任务模版、打通万得、同花顺与学科网等第三方权威数据,并以量化额度消耗倍率全面开放第三方模型,标志着国内 AI 办公应用正由“泛聊助手”全面进化为“开箱即用的专业流水线”。
1. 从通用泛聊转向场景交付:豆包工作台核心设计哲学与架构演进
在生成式 AI 经历了长达两年的基础对话普及之后,行业共识正迅速收敛:对话框(Chatbot)形态无法承接复杂的行业工作流。用户在空白输入框中一遍遍调试 Prompt、重复粘贴背景材料的繁琐体验,极大地拉高了专业用户的使用门槛。
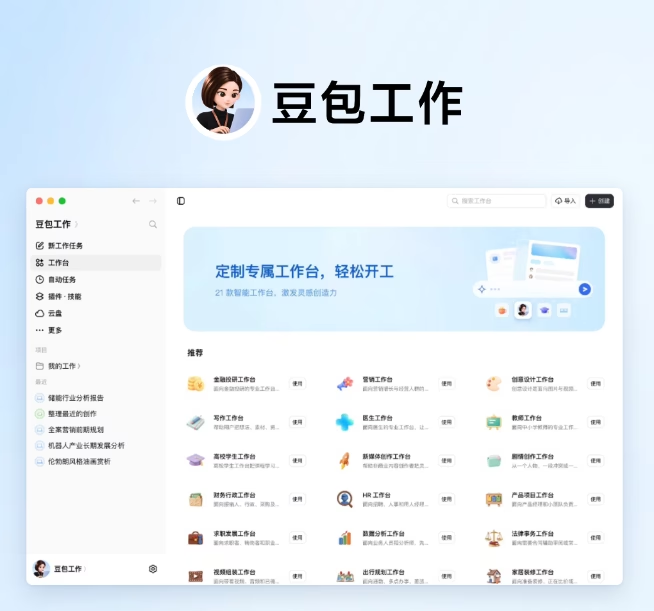
字节跳动旗下 豆包工作 今日正式推出的「工作台」功能,彻底改变了这一人机交互范式。系统将原本弥散在对话流中的底层能力,高度封装为 21 个面向具体岗位的垂直工作空间:
- 免调试预置技能: 针对特定行业梳理出标准的“技能拓扑图”,用户进入空间后无需构思 Prompt,直接通过预置的任务卡片(如财报解读、循证医学文献检索、教案实验生成)启动工作;
- 场景化上下文隔离: 每个工作空间拥有独立的知识持久化层与任务状态机,用户在金融投研空间中的历史交互不会污染法律合规空间的检索缓存;
- 低代码工作台自定义: 除了官方精选的 21 款场景外,用户可点击右上角“创建”,自由组合技能插件、外部 API 鉴权与个性化偏好,并一键打包分享给团队成员,构建组织专属的微型生产力 Agent。
2. 打破数据孤岛:万得/同花顺/学科网深度集成与合规边界拆解
垂直领域专业 AI 区别于通用玩具的最关键护城河,在于 可信垂直数据源的打通与合规风险控制。豆包工作台在首发版本中展现了极具深度的产业生态连接:
(1)金融投研空间:直连万得、同花顺与海通证券
在金融投研工作台中,豆包不仅提供了常规的公告解读、宏观市场简报与三方公司研究功能,更在插件层官方打通了 万得(Wind)、同花顺、国泰海通 等金融核心数据服务。用户在完成授权后,工作台可直接拉取最新的上市公司财报原始底稿、实时行情指标与研报数据流,杜绝了通用模型在财务指标计算上的“数字幻觉”。
(2)医生科研空间:循证文献检索与明确临床红线
在医疗健康场景,医生工作台预置了权威临床指南检索、医学前沿文献结构化解读以及患者通俗科普材料生成工具。值得称道的是,豆包在系统底层设立了严格的 伦理与合规防火墙:官方在显著位置明确标注“本空间仅用于医学科研辅助与信息参考,严禁替代执业医师进行独立临床诊断”,既赋能了医生的科研提效,又筑牢了医疗安全防线。
(3)教师备课空间:携手学科网打通真题与互动实验
在教育场景,豆包工作台与国内教学资源巨头 学科网 达成官方深度合作。教师输入课题与教材章节后,不仅能自动生成兼具知识点逻辑与随堂提问的教案课件,还能通过拍照搜题直接调取学科网的海量题库,甚至将抽象的物理、化学概念一键转化为支持参数调节的网页版互动实验模型。
(4)创意设计空间:无缝联动 Seedream 5.5 原生画布
在视觉设计领域,工作台与字节跳动日前发布的 Seedream 5.5 图像大模型深度集成。任务开启后自动生成协同画布,支持百轮稳定连续修改与原生 RGBA 透明通道输出,设计师可将一套核心视觉概念一键延展至系列海报与包装物料,单张 2K 方图编辑成本低至 0.28 元,大幅压缩了商业视觉流转周期。
3. 垂直场景工作台核心配置与数据互联多维对比
为了直观呈现不同专业场景的落地机制,以下对首批四大代表性工作台的核心架构与连接能力进行了系统梳理:
| 工作台垂直场景 | 预置核心业务技能 | 官方直连外部数据源 | 最终产出交付物形态 | 合规风控与落地边界 | |||||
|---|---|---|---|---|---|---|---|---|---|
| 金融投研工作台 | 财报深度穿透、业绩归因、研报对比 | 万得 (Wind)、同花顺、国泰海通 | 结构化投研简报、表格模型 | 外部服务需用户显式授权,防泄露 | |||||
| 医生科研工作台 | 临床指南循证、SCI 文献结构化抽取 | 权威医学期刊库、临床诊疗指南 | 文献综述、医患科普对话材料 | 教师教学工作台 | 跨课标教案生成、相似真题题图检索 | 学科网全量题库与课标知识图谱 | 分课时教案、互动实验 HTML | 题库版权规范引用,课标严格对齐 | |
| 创意设计工作台 | 多尺寸社媒延展、RGBA 抠图合成 | Seedream 5.5 图像大模型底座 | 高分辨率系列海报、透明设计素材 | 商业版权素材声明,像素级可控编辑 |
4. 多模型消耗系数化与生态闭环:AI 办公生产力工具的终局竞争
除了功能形态的跃迁,豆包工作近期在模型接入层的动作同样引人注目。在自研的豆包 2.1 Lite 和 Pro 两款主力模型之外,平台已全面开放接入 Kimi K3.1Pro、GLM5.3 以及 DeepSeek V4.1Flash 等第三方主流模型,并在模型选择页面开创性地推行了 “额度消耗倍率系数”:
用户可以根据任务场景的复杂度自主决策:在处理海量文档粗筛时选用低系数轻量模型节约点数,在进行精细化投研分析时切换至高系数旗舰模型,将模型的技术差异完全具象化为透明可预期的业务成本。
行业数据充分印证了这种“服务闭环”对用户心智的占领。根据 QuestMobile 权威发布的《中国移动互联网秋季大报告》,国内 AI 应用从单纯的用户规模粗放扩张期,正全面转向高频交互与真实业务闭环的深度运营。在 2026 年秋季统计中,豆包月人均使用次数已攀升至 72.0 次,与 DeepSeek(65.9 次)稳稳占据了国内 AI 应用高频使用第一梯队。
📝 站长洞察 (Editor’s Insight)
AI 生产力软件正在重演传统 SaaS 发展史上的经典剧本:从早期的“单点功能工具”走向“行业集成工作台”。一个空白对话框对于小白用户来说或许有趣,但对于真正的金融分析师、外科医生或中学老师而言,没有打通万得、学科网或临床指南的 AI,永远只能是一个停留在闲聊层面的“不可信实习生”。字节跳动豆包工作的聪明之处,在于它果断放弃了让用户自己去摸索复杂的 Agent 编排,而是直接把行业最硬核的数据服务和垂类工作流做成预置好的“工作台”。结合第三方模型消耗系数化定价,豆包正在从一个单纯的模型拥有者,演化为大模型时代的综合应用分发超市。这种以场景交付为抓手、紧抓高频刚需入口的战略,才是国内 AI 厂商在下半场决胜企业级生产力的真正壁垒。
豆包工作台是什么?
豆包工作台是字节跳动豆包工作推出的垂直场景AI空间,首批覆盖金融投研、医生、教师、法律、创意等21类专业任务。它通过预置模板、数据打通和场景隔离,把通用聊天升级为可交付的工作流。
豆包工作台接入了哪些权威数据源?
文中明确提到金融投研场景直连万得、同花顺、国泰海通;教育场景打通学科网;医疗场景接入权威医学期刊库和临床诊疗指南。核心价值是减少通用模型的幻觉,提高专业答案可信度。
豆包工作台适合哪些专业用户?
适合需要高频处理结构化任务的专业用户,如投研、医生、教师、法律和创意设计人员。它的优势在于预置技能、独立上下文和可分享的自定义工作台,能显著降低专业AI落地门槛。
第三方模型倍率怎么选最划算?
先按任务拆分:高频、低风险、可模板化的环节用低倍率模型,复杂推理和长文生成再切高倍率。关键是把调用链路做成可观测,按成本、时延、命中率持续回收配置,而不是一刀切。
接入万得同花顺后如何避免同质化?
不要只做数据聚合,要把数据源与行业流程绑定成可执行模板,比如研报、选股、风控、授课、病例摘要等。真正的差异化来自场景编排、权限控制、结果校验和交付格式,而非单纯接了多少源。


