


PhotoVerse是一种文本到图像生成模型,它不需要进行任何额外的微调或调整。可以直接使用文本输入生成您所期望的图像。该模型采用了扩散模型的方法,通过将文本描述转化为图像来实现。
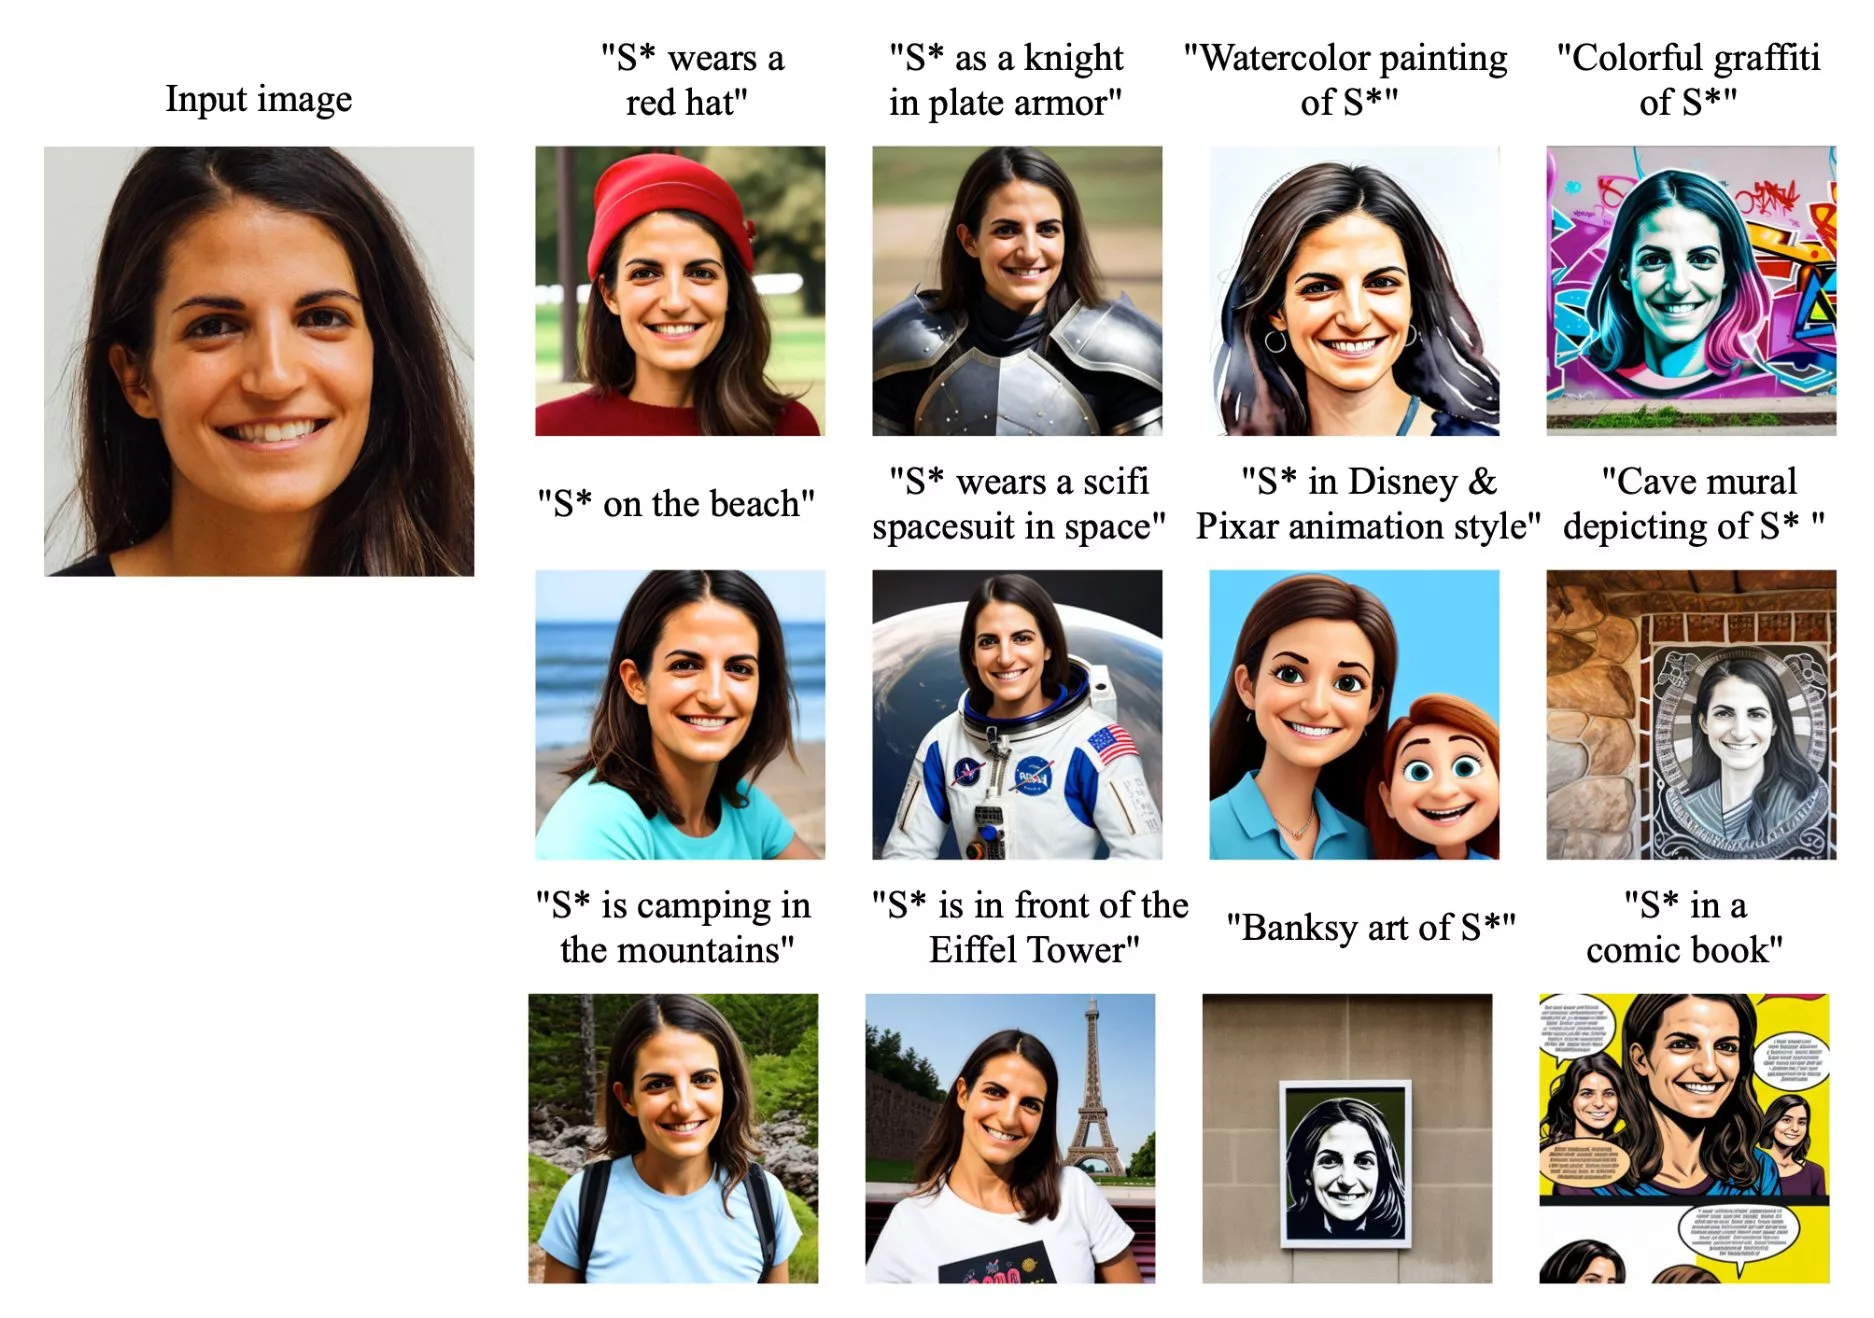
特点:
- 只需一张面部照片。
- 无需在测试时进行调整。
- 具有出色的身份保留和可编辑性。
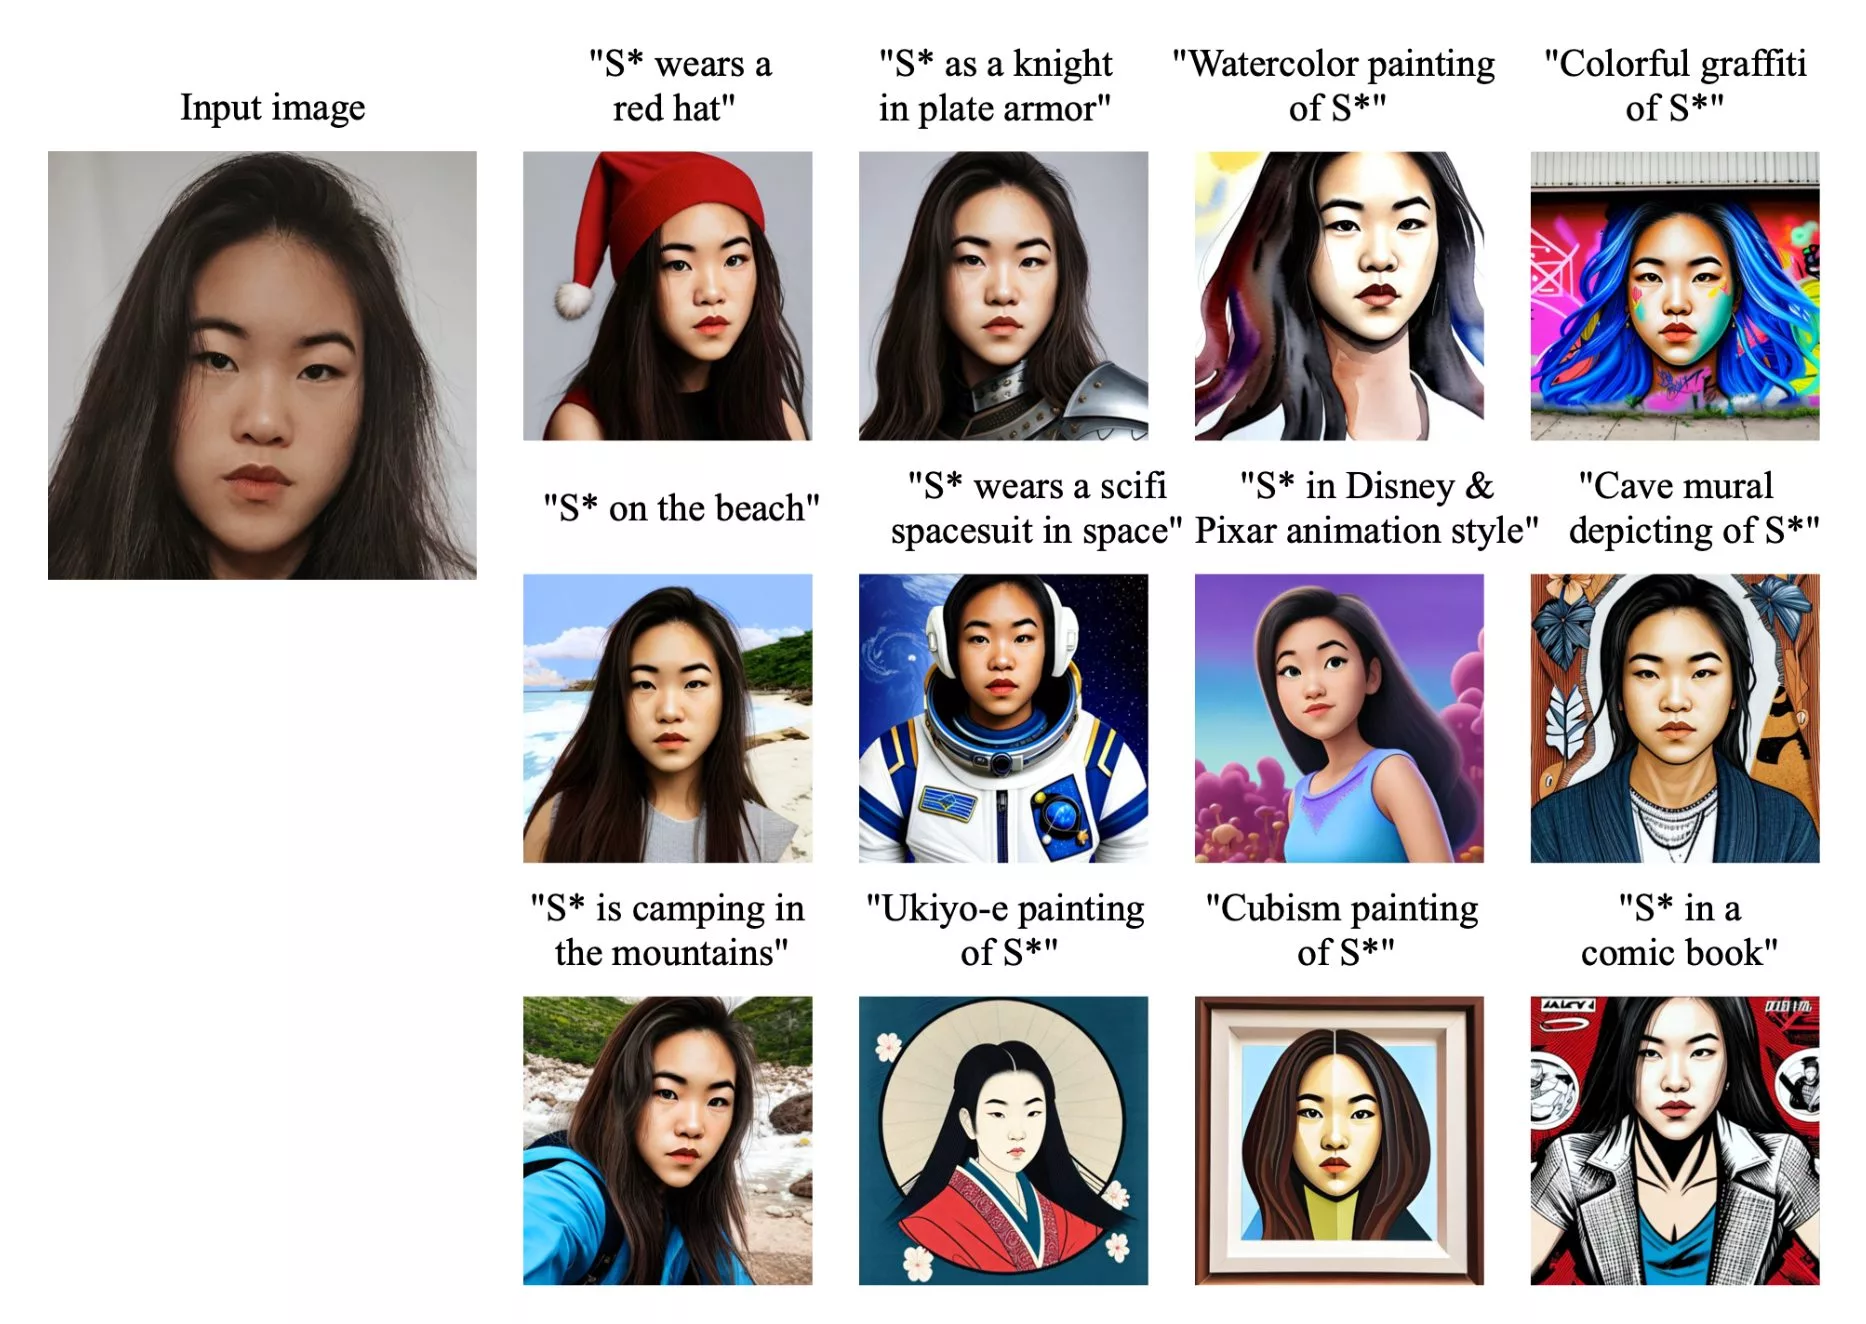
- 擅长生成多样化的图像,包括各种场景和风格。
PhotoVerse 是一种无需额外调整的图像生成方法,只需要一个人的面部照片即可。这意味着它能够快速、高效地生成高质量的图像,并且节省资源。
该方法还支持与其他方法结合使用,例如 ControlNet (Zhang和Agrawala 2023),特别是利用其控制分支来保留整体的高级结构,进一步增强文本到图像生成的姿势控制。
经过广泛评估,这项技术不仅快速高效,而且生成的图片质量很高,能够满足各种个性化需求。
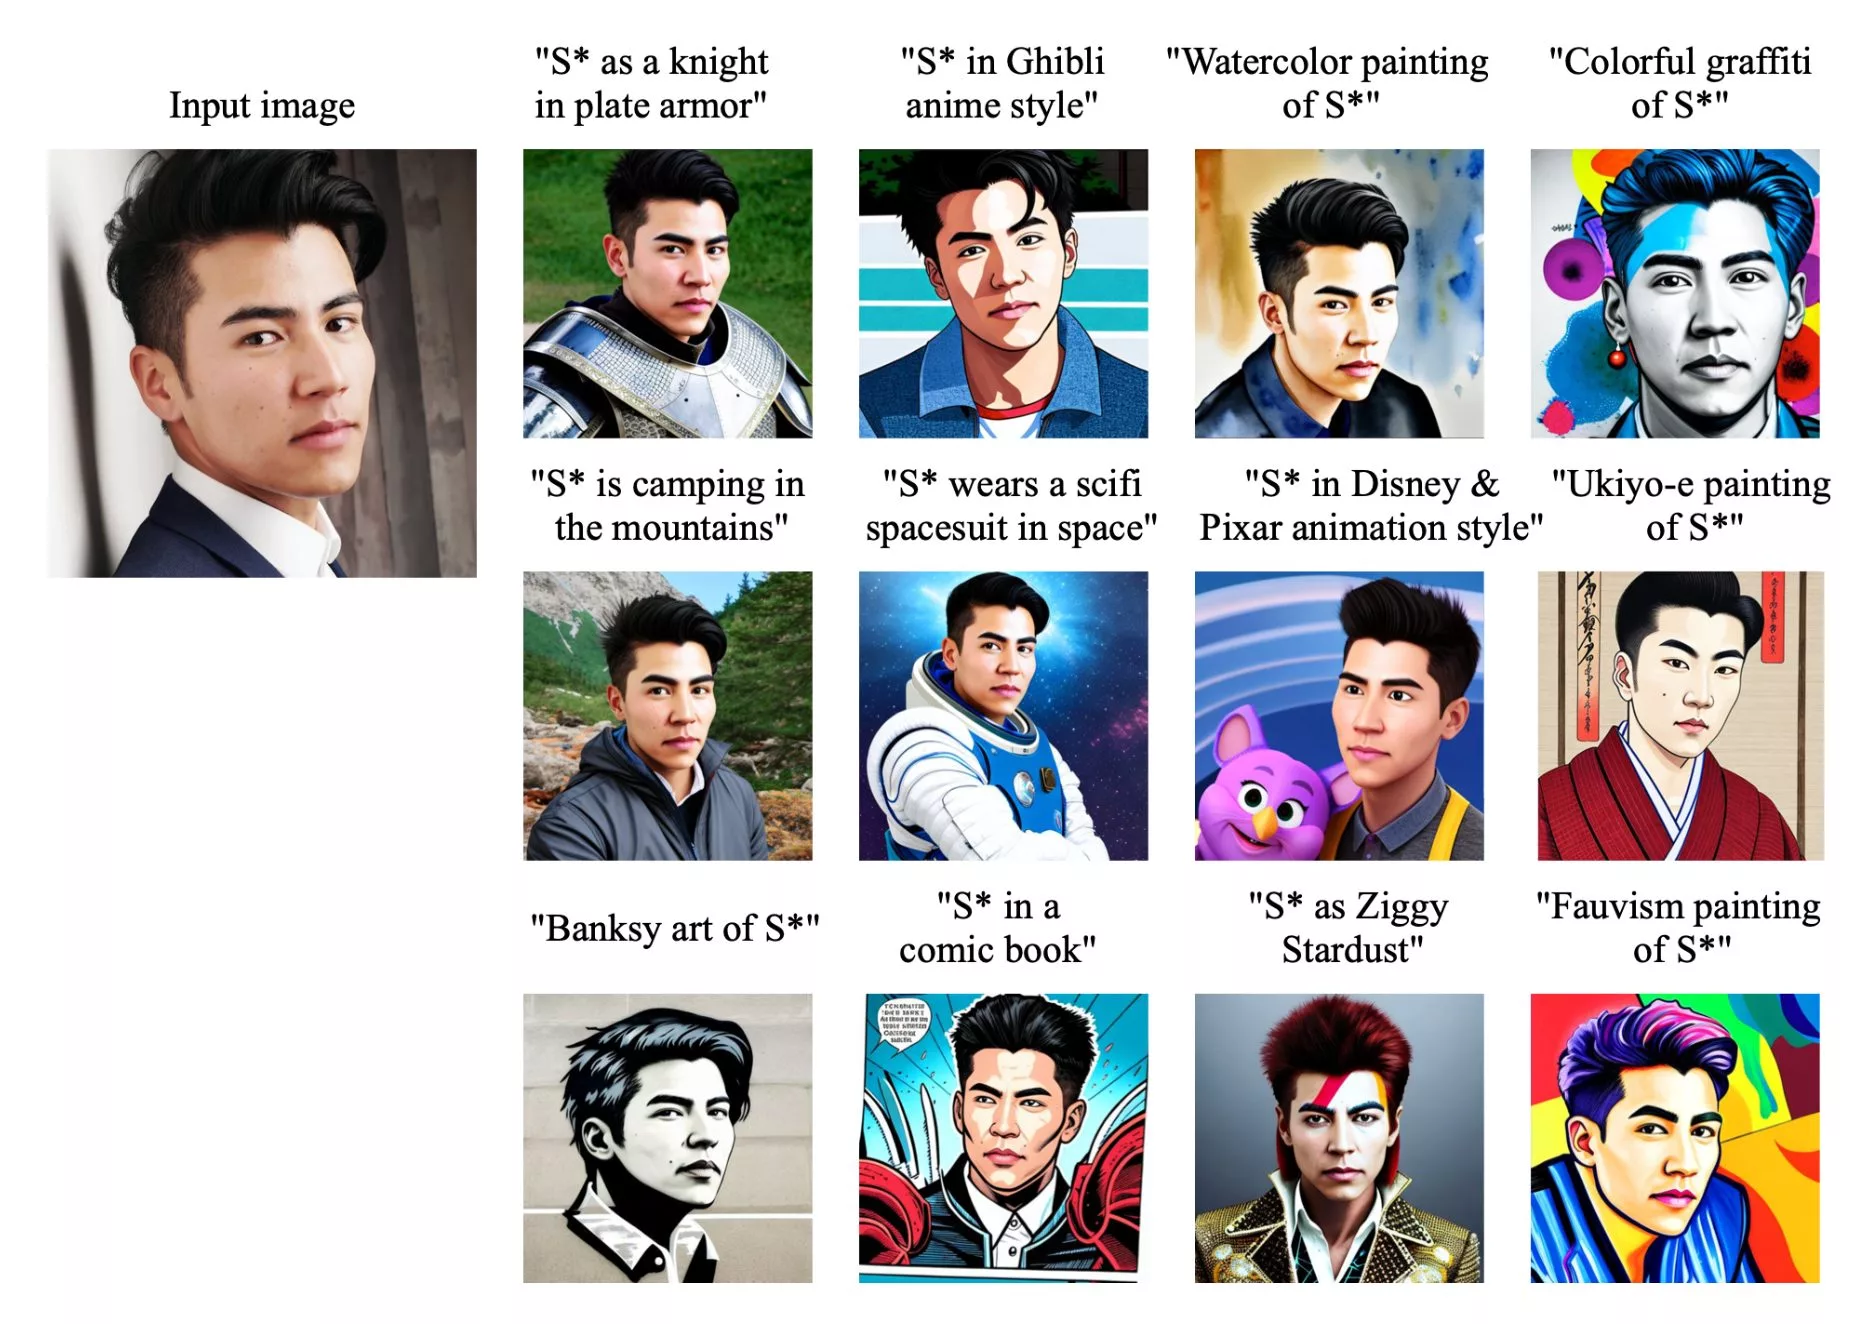
PhotoVerse 的工作原理涉及双分支调节机制:它同时考虑文本描述和输入的面部照片来生成图像,就像有两只眼睛,一只眼睛看着给定的照片,另一只眼睛听着描述。
为了确保生成的图像与原始面部照片的身份一致,PhotoVerse 引入了面部身份损失作为一个新的组件。这有助于在训练过程中增强身份的保留。
与许多其他方法不同,PhotoVerse 无需在生成图像之前进行微调或调整。这是因为它已经经过充分的训练,可以直接根据给定的文本描述和面部照片生成图像。
经过单一的训练阶段,PhotoVerse 能够在几秒钟内高效地生成高质量的图像。
项目:https://photoverse2d.github.io
论文:https://arxiv.org/abs/2309.05793
PhotoVerse 需要微调吗?
不需要。文章明确说明 PhotoVerse 无需额外微调或测试时调整,经过单一训练阶段后即可直接根据文本描述和面部照片生成图像,使用门槛更低、效率更高。
PhotoVerse 适合做什么类型的图像生成?
它适合个性化人像与多样化场景生成。模型强调身份保留、可编辑性和风格多样性,能够在保持人物特征的同时生成不同场景、姿势和风格的图像。
PhotoVerse 能和 ControlNet 一起用吗?
可以。文中提到 PhotoVerse 可与 ControlNet 结合,利用其控制分支保留整体高级结构,进一步增强文本到图像生成中的姿势控制与结构稳定性。
一张照片如何保住身份特征?
关键是把人脸身份信息与文本语义解耦,训练时强化面部特征约束,推理时减少对身份敏感区域的改动。实际使用中,尽量选清晰正脸照,并避免过强风格词覆盖人物特征。
怎么叠加 ControlNet 提升可控性?
先用 PhotoVerse 生成身份一致的基础图,再接入 ControlNet 控姿势、构图或边缘结构。这样能兼顾“像本人”和“按你想要的姿态”,适合做头像、海报和角色设定图。


