Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
阅读: VideoLLaMA3 – 阿里达摩院推出的多模态基础模型
Share
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
VideoLLaMA3 – 阿里达摩院推出的多模态基础模型
Prompt 语宙 > AIGC 资讯 > VideoLLaMA3 – 阿里达摩院推出的多模态基础模型
AIGC 资讯

VideoLLaMA3 – 阿里达摩院推出的多模态基础模型

Prompt 语宙研究院
最近更新: 2026年6月9日 上午5:19
HuggingFace 大模型微调 开源大模型 达摩院 通义千问
SHARE
⚡ Prompt 语宙 AI 导读 · 30 秒核心看点
  • 基于 Qwen 2.5 与 SigLip,VideoLLaMA3 强化了图像、视频与文本的多模态融合能力。
  • 采用视觉为中心的四阶段训练,提升长视频理解、细粒度细节捕捉与跨语言分析表现。
  • 支持视频内容分析、视觉问答、流式字幕生成,本地部署和云端推理都可用。

VideoLLaMA3是什么

VideoLLaMA3 是阿里巴巴开源的前沿多模态基础模型,专注于图像和视频理解。基于 Qwen 2.5 架构,结合了先进的视觉编码器(如 SigLip)和强大的语言生成能力,能高效处理长视频序列,支持多语言的视频内容分析和视觉问答任务。模型具备强大的多模态融合能力,支持视频、图像输入,生成自然语言描述,适用于视频内容分析、视觉问答和多模态应用等多种场景。 VideoLLaMA3 提供多种预训练版本(如 2B 和 7B 参数规模),针对大规模数据进行了优化,具备高效的时空建模能力和跨语言理解能力。
阅读目录
  • VideoLLaMA3是什么
  • VideoLLaMA3的主要功能
  • VideoLLaMA3的技术原理
  • VideoLLaMA3的项目地址
  • VideoLLaMA3的应用场景

VideoLLaMA3

VideoLLaMA3的主要功能

  • 多模态输入与语言生成:支持视频和图像的多模态输入,能生成自然语言描述,帮助用户快速理解视觉内容。
  • 视频内容分析:用户可以上传视频,模型会提供详细的自然语言描述,适用于快速提取视频核心信息。
  • 视觉问答:结合视频或图像输入问题,模型能生成准确的答案,适用于复杂的视觉问答任务。
  • 多语言支持:具备跨语言视频理解能力,支持多语言生成。
  • 高效的时空建模:优化的时空建模能力使其能够处理长视频序列,适用于复杂的视频理解任务。
  • 多模态融合:结合视频和文本数据进行内容生成或分类任务,提升模型在多模态应用中的性能。
  • 灵活的部署方式:支持本地部署和云端推理,适应不同的使用场景。

VideoLLaMA3的技术原理

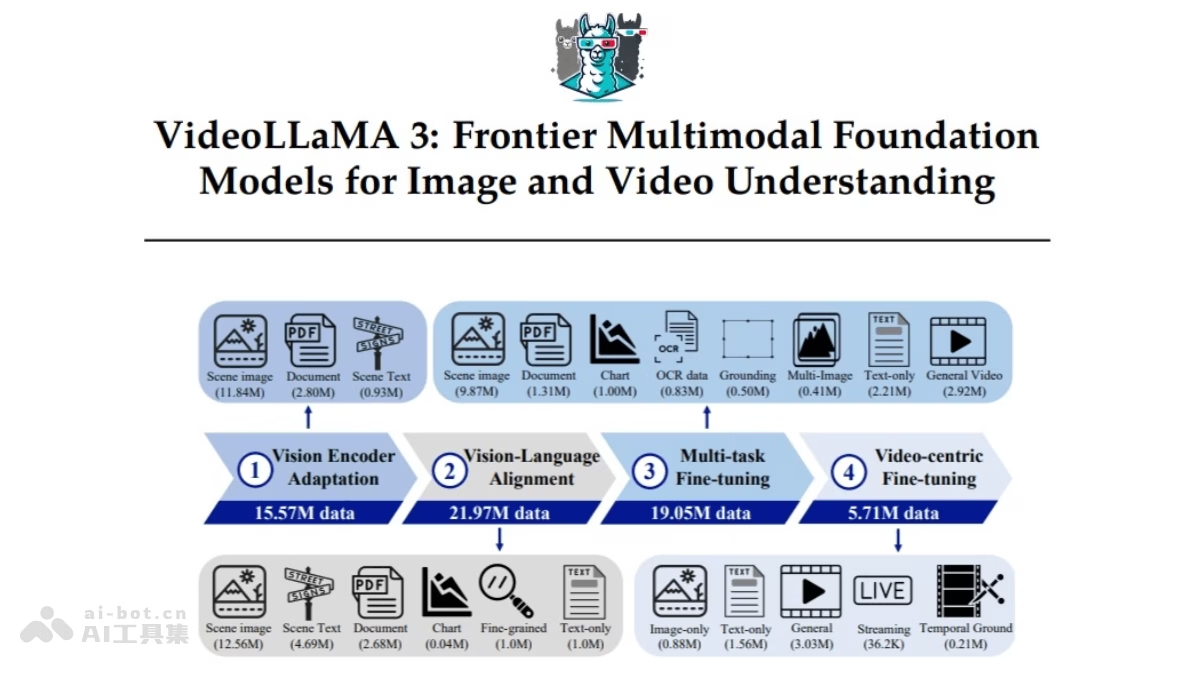
  • 视觉为中心的训练范式:VideoLLaMA3 的核心在于高质量的图像文本数据,非大规模的视频文本数据。其训练分为四个阶段:
    • 视觉对齐阶段:热身视觉编码器和投影仪,为后续训练做准备。
    • 视觉语言预训练阶段:使用大规模图像文本数据(如场景图像、文档、图表)和纯文本数据,联合调整视觉编码器、投影仪和语言模型。
    • 多任务微调阶段:结合图像文本数据进行下游任务优化,并引入视频文本数据以建立视频理解基础。
    • 视频为中心的微调阶段:进一步提升模型在视频理解任务中的表现。
  • 视觉为中心的框架设计:视觉编码器被优化为能根据图像尺寸生成相应数量的视觉标记,不是固定数量的标记,更好地捕捉图像中的细粒度细节。对于视频输入,模型通过减少视觉标记的数量来提高表示的精确性和紧凑性。
  • 基于 Qwen 2.5 架构的多模态融合:VideoLLaMA3 基于 Qwen 2.5 架构,结合了先进的视觉编码器(如 SigLip)和强大的语言生成能力,能高效处理复杂的视觉和语言任务。

VideoLLaMA3的项目地址

  • GitHub仓库:https://github.com/DAMO-NLP-SG/VideoLLaMA3
  • HuggingFace模型库:https://huggingface.co/papers/2501.13106
  • arXiv技术论文:https://arxiv.org/pdf/2501.13106

VideoLLaMA3的应用场景

  • 视频内容分析:VideoLLaMA3 能深度理解和分析长视频内容,捕捉视频中的细微动作和长期记忆。可以自动检测视频中的异常行为或生成视频的详细描述,帮助用户快速了解视频核心内容。
  • 视频问答系统:在视频问答(VideoQA)任务中,用户可以针对视频内容提出问题,VideoLLaMA3 能生成准确的答案。
  • 视频字幕生成:基于其流式字幕生成能力,VideoLLaMA3 可以为视频自动生成实时字幕。
  • 多语言支持:VideoLLaMA3 支持多语言生成,能处理跨语言的视频理解任务。在国际化的视频内容分析和多语言教育场景中具有广泛的应用潜力。
🧭 文中关联 AI 工具官网与参数卡(语宙 AI 导航)
达摩院 ↗
达摩院:阿里巴巴旗下研究院,面向AI 综合应用场景提供便捷实用的在线功能支持。
HuggingFace ↗
HuggingFace:AI模型开发社区,面向大语言模型场景提供便捷实用的在线功能支持,涵盖大模型等实用方向。
❓ 常见问题解答(FAQ)
VideoLLaMA3适合做什么?

VideoLLaMA3 主要用于图像和视频理解,可做视频内容分析、视觉问答、字幕生成和多语言视频解析,适合需要从长视频中提取信息的场景。

VideoLLaMA3的技术特点是什么?

它基于 Qwen 2.5 架构,结合 SigLip 等视觉编码器,采用视觉为中心的训练范式,并通过四阶段训练提升长视频建模、细粒度理解和跨语言能力。

VideoLLaMA3支持哪些部署方式?

文章提到 VideoLLaMA3 支持本地部署和云端推理,适合不同算力与业务需求;同时提供 2B、7B 等预训练版本,便于按场景选择。

🔬 语宙深潜追问 · 进阶实操拆解
长视频理解怎么避免前后失忆?

把视频切成语义片段并建立时间索引,再用检索式记忆串联关键事件;推理时先做粗粒度摘要,再对命中片段精读,能显著减少长视频里“只看见局部、忘了前文”的问题。

多语言字幕生成如何提升一致性?

先统一术语表和专有名词翻译,再做说话人分离与时间轴对齐;如果面向生产,最好加人工校对回路,重点检查数字、地名和口语缩写,能大幅降低字幕漂移。

🗳️ 读者观点微投票 · 您的实战立场是?
长视频理解模型,先拼精度还是先拼效率?
🕸️ 语宙向量知识图谱 · 语义强关联深度内链
🔓 所属权威专题:开源大模型与端侧推理 →
  • Mini-LLaVA – 基于Llama 3.1的轻量级多模态大语言模型
  • VideoLLaMB – 开源的多模态长视频理解框架
  • 人大高瓴与蚂蚁联合发布LLaDA-V:纯扩散架构多模态大模型刷新SOTA!
  • LongLLaVA – 香港中文大学推出的多模态上下文混合架构大语言模型
🏛️ Prompt 语宙研究院 · Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
📄 Markdown 纯净版
💡 这篇内容对您有启发吗?
📡 RSS 订阅✨ 提交 AI 工具 / 合作
🚀 Prompt 语宙 AI 创作者生态:探索 2,800+ 全球实用 AI 工具与高精度生图提示词咒语库
🧭 语宙 AI 导航 (ai.paooo.com)🎨 AI 生图 Prompt 库📚 核心专题导航⚡ AIGC 早报生成器
Goedel-Prover – 自动化数学问题的形式证明生成开源推理模型
GCDance – 萨里大学和江南大学推出的3D舞蹈生成框架
阿里通义千问发布Qwen-Image-2.0:7B参数原生2K,1K长指令精准文字渲染,AI图像生成新标杆
AI演习变实战?OpenAI新模型意外“入侵”知名开源平台
如何作为软件工程师涉足机器人技术 [译]
TAGGED:HuggingFace大模型微调开源大模型达摩院通义千问
分享
Email 复制链接 打印
Share
Prompt 语宙研究院 头像
ByPrompt 语宙研究院
Follow:
Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
上一篇 Zerox – 开源的OCR工具,零样本识别多种格式文件 Zerox – 开源的OCR工具,零样本识别多种格式文件
下一篇 WarriorCoder – 微软联合华南理工大学推出的代码生成大模型 WarriorCoder – 微软联合华南理工大学推出的代码生成大模型
Ad image
Ad image

最近更新

Anthropic 纳斯达克上市后的商业化抉择:面对 8954 亿美元算力承诺,“绝不做广告”承诺与华尔街营收压力正面碰撞
超级碗刚嘲讽完OpenAI,转头面临8954亿美元算力账单!Anthropic上市后“绝不做广告”誓言与智能体商业化博弈全拆解
最新趋势
OpenAI 官方发布《Perplexity and Intelligence》专题主视觉:首席科学家 Jakub Pachocki 提议以对数困惑度作为全球前沿 AI 发展共享安全标尺
OpenAI首席科学家首次公开内部困惑度曲线!GPT-3.5至0.76跃迁揭秘:用Cross-Entropy Loss为AI设限速红线全拆解
AIGC 资讯
Atlassian AI 与产品工艺负责人 Sherif Mansour 做客 Lenny 播客,拆解全员 AI 构建者实验、初级人才赋能与产品工艺三角
取消PM头衔全员AI造产品,1个月就翻车退回!Atlassian AI掌门揭秘:初级员工多用38%AI却产Slop、工艺三角与Rovo外挂全拆解
AI 工具
GitHub Changelog 官方发布主图:GitHub Copilot CLI 1.0.113+ 公测支持 Microsoft Entra 身份登录与双轨企业推理
免GitHub账号直接终端跑AI!Copilot CLI上线Microsoft Entra登录:接入Work IQ MCP与Agent 365全链路审计拆解
AI 工具

相关推荐

OmniHuman – 字节跳动推出的单张照片生成全身动态视频生成框架
AIGC 资讯

OmniHuman – 字节跳动推出的单张照片生成全身动态视频生成框架

Prompt 语宙研究院
3D与空间智能 AI视频生成 AI音频与语音 大模型微调
前英伟达 CEO 黄仁勋出席美国国会闭门听证会关键日程
AIGC 资讯

传票威胁下妥协!前英伟达CEO黄仁勋正式同意在感恩节前出席国会听证会:众议院三大委员会联手施压、闭门录像受审与芯片出口管制分歧全景深度拆解

Prompt 语宙研究院
AI算力地缘博弈 美国国会听证会 芯片出口管制 英伟达 黄仁勋
abab-music-1 – MiniMax 推出端到端 AI 音乐生成大模型
AIGC 资讯

abab-music-1 – MiniMax 推出端到端 AI 音乐生成大模型

Prompt 语宙研究院
AI音频与语音 MiniMax 大模型微调 开源大模型
VoiceCanvas – 开源AI语音合成平台,支持多语言、多音色、声音克隆服务
AIGC 资讯

VoiceCanvas – 开源AI语音合成平台,支持多语言、多音色、声音克隆服务

Prompt 语宙研究院
AI音频与语音 MiniMax OpenAI 开源大模型
/ Prompt 语宙 /

探索生成式 AI 的无限创作潜能,一站式获取前沿 AIGC 资讯、高阶 Prompt 咒语与全球实用 AI 工具。

核心专栏

  • 语宙 AI 工具导航
  • EVA 视觉抠图工坊Hot
  • 出海数字营销宝典
  • AI 生图咒语灵感库
  • 24H 硅谷 AI 情报流

生态与服务

  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作

标签

开源大模型 AI智能体 AI办公效率 AI绘画提示词 OpenAI 大模型微调 Midjourney AI编程 stable diffusion AI视频生成 ChatGPT 3D与空间智能 HuggingFace AI音频与语音 RAG检索增强 Claude Flux AIGC Gemini 通义千问 Anthropic Llama Cursor DeepSeek Prompt AI Agent Kimi 智谱AI 具身智能 Claude Code
Prompt 语宙Prompt 语宙
Follow US
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.