Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
阅读: 理想汽车发布MindVLA-o1:原生多模态VLA架构,定义自动驾驶与具身智能新范式
Share
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
理想汽车发布MindVLA-o1:原生多模态VLA架构,定义自动驾驶与具身智能新范式
Prompt 语宙 > AIGC 资讯 > 理想汽车发布MindVLA-o1:原生多模态VLA架构,定义自动驾驶与具身智能新范式
AIGC 资讯最新趋势

理想汽车发布MindVLA-o1:原生多模态VLA架构,定义自动驾驶与具身智能新范式

Prompt 语宙研究院
最近更新: 2026年6月7日 下午8:04
MindVLA-o1 VLA架构 具身智能 理想汽车 自动驾驶基础模型
SHARE
⚡ Prompt 语宙 AI 导读 · 30 秒核心看点
  • MindVLA-o1以原生多模态VLA统一视觉、语言、行为,瞄准自动驾驶与具身智能一体化。
  • 通过3D ViT、前馈式3DGS和隐世界模型,提升三维感知、未来预测与实时轨迹生成能力。
  • 结合闭环强化学习与软硬件协同设计,强调端侧高效部署与更优精度-延迟平衡。

💡 站外导读:当行业仍在争论端到端纯视觉与多传感器融合路线孰优孰劣时,理想汽车已悄然开辟新赛道。其最新发布的MindVLA-o1,不仅是单纯的自动驾驶模型,更是一个面向“物理AI”时代的原生多模态基础架构。它直击当前自动驾驶系统感知理解与行为决策割裂、依赖海量真实数据、模型泛化能力有限的核心痛点,试图通过统一的VLA架构,将车辆乃至机器人“看见、思考、行动”的能力融为一体,为智能出行乃至整个具身智能产业的未来,提供了全新的技术蓝图。

MindVLA-o1是什么

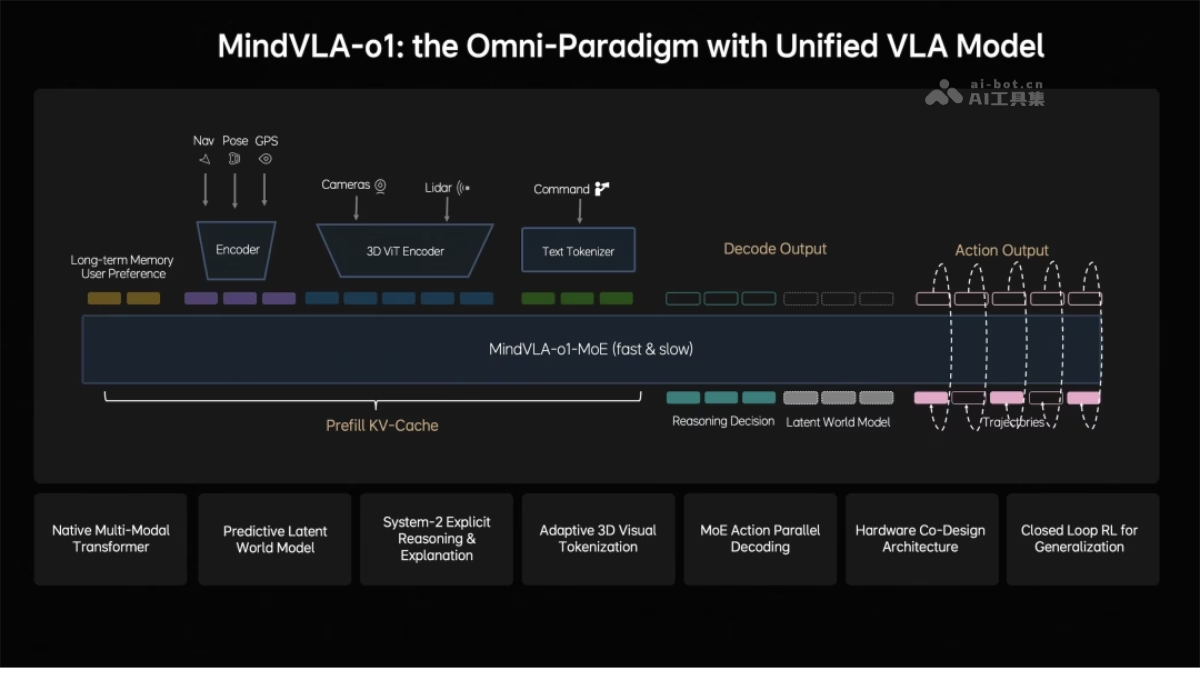
MindVLA-o1是理想汽车推出的下一代自动驾驶基础模型,采用原生多模态MoE架构,统一融合视觉、语言、行为三种模态。模型通过3D ViT编码器实现空间理解,借助隐式世界模型进行未来预测,以统一行为生成机制输出驾驶轨迹。结合闭环强化学习与软硬件协同设计,MindVLA-o1能看得更远、想得更深、行得更稳,标志着自动驾驶向通用具身智能体演进的关键一步。
阅读目录
  • MindVLA-o1是什么
  • MindVLA-o1的主要功能
  • MindVLA-o1的技术原理
  • MindVLA-o1的关键信息和使用要求
  • MindVLA-o1的核心优势
  • MindVLA-o1的同类竞品对比
  • MindVLA-o1的应用场景
      • 📝 站长洞察 (Editor’s Insight)

MindVLA-o1

MindVLA-o1的主要功能

  • 3D空间感知:MindVLA-o1通过3D ViT编码器与前馈式3DGS表示实现三维空间感知,精准理解场景中的静态环境与动态物体。
  • 多模态思考推理:模型引入预测式隐世界模型,在隐空间中推演未来场景演化,实现视觉理解与语言推理的深度融合。
  • 统一行为生成:系统采用VLA-MoE架构与并行解码机制,生成符合动力学约束的高精度驾驶轨迹,满足实时性要求。
  • 闭环自我进化:基于Feed-forward场景重建与强化学习框架,模型在仿真环境中持续自我进化,突破真实数据规模限制。
  • 高效端侧部署:通过软硬件协同设计定律优化,系统在车载端侧芯片上实现高效部署,兼顾模型精度与推理效率。

MindVLA-o1的技术原理

  • 3D自监督视觉编码:模型以视觉为核心的3D ViT编码器将LiDAR点云作为几何提示,引入前馈式3DGS表示分别建模静态环境与动态物体,通过下一帧预测任务实现自监督训练,使模型同时具备语义理解与三维感知能力。
  • 预测式隐世界模型:为避免直接生成未来图像的高计算成本,模型在紧凑的隐空间中进行高效预测,经三阶段训练构建未来场景的隐空间表征与推演能力,实现理解当前、想象未来、逻辑判断的统一。
  • 统一行为生成:VLA-MoE架构中的Action Expert专门处理驾驶轨迹生成,采用并行解码一次性输出所有轨迹点满足实时性,通过离散扩散进行多轮迭代优化,确保轨迹空间连续且符合动力学约束。
  • 闭环强化学习:将传统逐步优化式重建升级为Feed-forward场景重建,结合生成式模型扩展仿真能力,依托统一3DGS渲染引擎与分布式训练框架实现低成本高效率的强化学习闭环。
  • 软硬件协同设计:基于Roofline模型刻画硬件约束,评估近2000种架构配置寻找精度与延迟的Pareto最优解,发现端侧场景下更宽更浅的模型架构更为高效,将架构探索周期从数月缩短至数天。

MindVLA-o1的关键信息和使用要求

  • 定位:理想汽车下一代自动驾驶基础模型,面向具身智能的原生多模态VLA架构。
  • 发布时间:2026年3月17日,由基座模型负责人詹锟在NVIDIA GTC 2026正式发布。
  • 五大技术创新:3D空间理解、多模态思考、统一行为生成、闭环强化学习、软硬件协同设计。
  • 技术演进:从端到端到VLA再到原生多模态,代表物理AI时代的开端。
  • 应用扩展:同一套VLA模型可控制车辆与机器人,自动驾驶仅是物理AI的起点。
  • 数据层面:依赖MindData统一VLA数据引擎持续采集、清洗和自动标注大规模驾驶数据。
  • 算力层面:需配合MindSim可控多模态世界模型与RL Infra强化学习基础设施,支持大规模闭环训练。
  • 硬件层面:基于NVIDIA Drive Orin或Thor平台部署,需满足模型精度与推理延迟的Pareto最优配置。
  • 仿真层面:依托统一3DGS渲染引擎与分布式训练框架,实现低成本高效率的强化学习迭代。

MindVLA-o1的核心优势

  • 原生多模态统一架构:MindVLA-o1将视觉、语言、行为三种模态纳入同一框架进行联合训练与对齐,非后期拼接,实现更高效率与更好泛化能力。
  • 3D空间深度理解:通过3D ViT编码器与前馈式3DGS表示,模型同时具备语义理解与三维感知能力,突破传统BEV拍平场景、OCC过于稠密的局限。
  • 隐空间高效推演:预测式隐世界模型在紧凑隐空间中”想象”未来,避免直接生成图像的高计算成本,实现理解当前与预测未来的统一。
  • 实时精准决策:VLA-MoE架构结合Action Expert、并行解码与离散扩散优化,兼顾轨迹生成精度与实时性要求。。
  • 端侧高效部署:软硬件协同设计定律将架构探索周期从数月缩短至数天,在车载芯片上找到精度与延迟的最优平衡。

MindVLA-o1的同类竞品对比

对比维度 MindVLA-o1 特斯拉 FSD 华为 ADS
架构路线 原生多模态VLA统一架构 端到端纯视觉 端到端+多传感器融合
感知方案 视觉为主+LiDAR几何提示 纯视觉 多传感器融合
推理能力 隐世界模型预测未来 端到端隐式推理 规则+AI混合
行为生成 MoE+并行解码+离散扩散 端到端直接输出 分段式决策
仿真训练 Feed-forward重建+强化学习 影子模式+仿真 数据闭环为主
部署优化 软硬件协同设计定律 自研芯片Dojo/HW4.0 昇腾芯片优化
应用扩展 车辆+机器人通用VLA 专注自动驾驶 专注自动驾驶
技术阶段 物理AI/具身智能 AI-based端到端 AI-based端到端

MindVLA-o1的应用场景

  • 自动驾驶:MindVLA-o1作为下一代自动驾驶基础模型,可处理城市道路、高速公路、复杂路口等全场景驾驶任务,实现从感知理解到决策规划的全链路智能化。
  • 智能座舱交互:依托原生多模态架构的语言理解能力,系统可理解乘客语音指令,结合视觉感知实现人机自然交互与主动服务。
  • 机器人控制:同一套VLA模型可扩展至机器人平台,驱动机械臂、轮式机器人等不同形态具身智能体完成物理世界任务。
  • 仿真测试验证:通过MindSim世界模型生成高保真虚拟场景,支持极端天气、罕见事故等长尾场景的大规模闭环测试与模型迭代。
  • 智能交通管理:基于3D空间理解与预测能力,可扩展应用于车路协同、交通流量预测等城市级智慧交通系统。

📝 站长洞察 (Editor’s Insight)

理想汽车此次发布的MindVLA-o1,其意义远超一款新车系统的升级,它清晰地指明了自动驾驶乃至通用人工智能的下一个演进方向:从“专用AI”走向“具身智能基础模型”。其提出的“原生多模态VLA统一架构”是关键,这意味着模型从底层设计就深度融合感知、认知与行动,而非后期模块拼接。这解决了当前AI在复杂物理世界交互中“感知碎片化”与“决策僵化”的根本矛盾。更值得关注的是其“软硬件协同设计”和“闭环自我进化”的理念,这标志着自动驾驶的竞争已从算法单项比拼,升级为涵盖数据、仿真、算力与部署的全栈系统工程能力对决。将同一模型架构延伸至机器人控制,揭示了其构建“通用物理世界智能体”的宏大野心。这不仅是技术路线的领先,更是产业思维与生态构建的降维打击,预示着智能汽车的核心价值正从“交通工具”向“移动智能体”与“数据生成平台”剧烈转变。

❓ 常见问题解答(FAQ)
MindVLA-o1和传统自动驾驶模型有什么区别?

MindVLA-o1不是把感知、预测、规划拆开做,而是将视觉、语言、行为统一进原生多模态VLA架构中联合训练。相比传统端到端或模块化方案,它更强调3D空间理解、隐空间推演和统一行为生成。

MindVLA-o1为什么强调3D空间智能?

因为它通过3D ViT编码器和前馈式3DGS表示来理解真实三维场景,并借助LiDAR几何提示增强空间感知。这样既能看懂静态环境,也能处理动态物体,为驾驶决策提供更可靠的空间基础。

MindVLA-o1能否用于机器人场景?

文章明确指出,同一套VLA模型可扩展到车辆与机器人,自动驾驶只是物理AI的起点。其核心价值在于把“看见、思考、行动”统一建模,因此具备向具身智能场景迁移的潜力。

🔬 语宙深潜追问 · 进阶实操拆解
MindVLA-o1最适合先落地哪些场景?

优先从低速、结构化、风险可控场景切入,如园区接驳、封闭道路、低速泊车与具身操作。先验证感知-规划-控制闭环,再逐步扩展到更复杂长尾场景,能更稳地积累数据与安全边界。

原生多模态VLA如何做端侧部署优化?

核心是压缩视觉token、降低跨模态对齐开销,并用蒸馏、量化和分层推理减少算力占用。工程上建议把高频反应链路放端侧,复杂推演放云端或边缘协同,兼顾实时性与泛化能力。

🗳️ 读者观点微投票 · 您的实战立场是?
原生VLA该优先上车还是先做仿真验证?
🕸️ 语宙向量知识图谱 · 语义强关联深度内链
🌐 所属权威专题:Gemini 全模态与空间智能 →
  • 小米OneVL开源:0.24秒延迟!具身智能团队发布SOTA级自动驾驶VLA世界模型
  • TinyVLA – 华东师范和上海大学推出面向机器人操控VLA模型
  • 阿里达摩院重磅发布WorldVLA:统一视觉-语言-动作模型,让机器人“既会看又会动”
  • 智谱开源GLM-4.5V:106B参数视觉推理新标杆,代码复刻、视频理解多场景实测
🏛️ Prompt 语宙研究院 · Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
📄 Markdown 纯净版
💡 这篇内容对您有启发吗?
📡 RSS 订阅✨ 提交 AI 工具 / 合作
🚀 Prompt 语宙 AI 创作者生态:探索 2,800+ 全球实用 AI 工具与高精度生图提示词咒语库
🧭 语宙 AI 导航 (ai.paooo.com)🎨 AI 生图 Prompt 库📚 核心专题导航⚡ AIGC 早报生成器
小米全新 AI 战略:构建未来的智能基础设施,重塑行业格局!
秒哒3. 5 全球首发iOS无代码打包与多端共享后端,百度要把应用开发门槛再砍一刀
诺奖团队登顶《Science》!RFdiffusion3 实现原子级全生成式蛋白质设计:解耦14原子坐标建模与实测高活性催化
成本狂降90%!DeepSeek-V4.1-Flash 重磅升级登顶 WebDev 开源榜首:首创帕累托极致性价比,每百万Token仅0.3美元直逼顶尖闭源
claw-code: Claude Code 泄露源码净室重写,开源 Agent 框架移植 Rust 追求高性能
TAGGED:MindVLA-o1VLA架构具身智能理想汽车自动驾驶基础模型
分享
Email 复制链接 打印
Share
Prompt 语宙研究院 头像
ByPrompt 语宙研究院
Follow:
Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
上一篇 LangGraph – 基于图结构构建与部署多代理动态工作流的开源框架 LangGraph – 基于图结构构建与部署多代理动态工作流的开源框架
下一篇 Midjourney V8震撼发布:速度飙升5倍、原生2K直出,AI图像生成进入新时代 Midjourney V8震撼发布:速度飙升5倍、原生2K直出,AI图像生成进入新时代
Ad image
Ad image

最近更新

WordPress 7.2版本更新与默认随机重定向、Secrets API撤回及MCP核心能力拆解封面图
官方博客竟把关闭过滤器写错了!WordPress 7.2前瞻全拆解:默认/random/暗藏隐私与SEO风险、Secrets API紧急撤回与3项MCP只读能力落地
AI 工具
Anthropic上市募资与算力长约的隐喻:现金光环上升,数据中心暗链延伸,治理水晶承受张力与阻力冲击。
募资超1070亿美元却背负9000亿算力长约!Anthropic史上最大IPO背后的三大隐忧:1040亿年内亏损、地方抵制潮与PBC治理死结
AIGC 资讯
微软Copilot与Claude/ChatGPT价格战隐喻:发光玻璃表格堡垒守住Excel,数据流高效汇聚,企业AI竞争升级
3000万付费仅吃下4.5亿席位不到7%!微软Ignite正面叫板Claude与ChatGPT:月均30美元VS 205美元价格战与Excel保卫战全拆解
AIGC 资讯
联想AI推理时代的端边云全栈算力插画:玻璃拟态服务器核心发光,光流连接云端与边缘节点,呈现营收与订单增长动能。
AI营收暴涨80%且握5300亿服务器订单!联想Q2单季营收首破2000亿、净利狂飙166%:端边云全栈算力如何接住推理时代红利?
AIGC 资讯

相关推荐

IC-Portrait – ETH联合浙大等推出的个性化肖像生成框架
AIGC 资讯

IC-Portrait – ETH联合浙大等推出的个性化肖像生成框架

Prompt 语宙研究院
3D与空间智能 AI绘画提示词 ComfyUI stable diffusion 开源大模型
12岁孩童用眉笔画胡子破解AI年龄验证:轻量级模型的技术漏洞引发行业警示
AIGC 资讯最新趋势

12岁孩童用眉笔画胡子破解AI年龄验证:轻量级模型的技术漏洞引发行业警示

Prompt 语宙研究院
AI模型 年龄验证 技术漏洞 隐私保护 面部识别
Video-T1 – 清华联合腾讯推出的视频生成技术
AIGC 资讯

Video-T1 – 清华联合腾讯推出的视频生成技术

Prompt 语宙研究院
AI智能体 AI视频生成 AI音频与语音 开源大模型
Kimi K2.6 – 月之暗面开源的最新旗舰模型
AIGC 资讯

Kimi K2.6 – 月之暗面开源的最新旗舰模型

Prompt 语宙研究院
AI编程 Claude Kimi OpenAI 大模型微调
/ Prompt 语宙 /

探索生成式 AI 的无限创作潜能,一站式获取前沿 AIGC 资讯、高阶 Prompt 咒语与全球实用 AI 工具。

核心专栏

  • 语宙 AI 工具导航
  • EVA 视觉抠图工坊Hot
  • 出海数字营销宝典
  • AI 生图咒语灵感库
  • 24H 硅谷 AI 情报流

生态与服务

  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作

标签

开源大模型 AI智能体 AI办公效率 AI绘画提示词 OpenAI 大模型微调 Midjourney AI编程 stable diffusion AI视频生成 ChatGPT 3D与空间智能 HuggingFace AI音频与语音 RAG检索增强 Claude Flux AIGC Gemini 通义千问 Anthropic Llama Cursor DeepSeek Prompt AI Agent Kimi 智谱AI 具身智能 YouTube
Prompt 语宙Prompt 语宙
Follow US
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.