Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
阅读: LLaVA-OneVision-1.5重磅发布:低成本高性能多模态模型,全栈开源助力AI应用爆发
Share
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
LLaVA-OneVision-1.5重磅发布:低成本高性能多模态模型,全栈开源助力AI应用爆发
Prompt 语宙 > AI 工具 > LLaVA-OneVision-1.5重磅发布:低成本高性能多模态模型,全栈开源助力AI应用爆发
AI 工具AIGC 资讯

LLaVA-OneVision-1.5重磅发布:低成本高性能多模态模型,全栈开源助力AI应用爆发

站外新闻
最近更新: 2026年6月7日 下午8:16
LLaVA-OneVision-1.5 Qwen3 RICE-ViT 多模态大模型 开源AI模型
SHARE

💡 站外导读:在多模态AI技术狂飙突进的今天,企业面临一个核心痛点:如何以可控的成本,获得顶尖的多模态理解与生成能力?高昂的训练费用、复现的复杂性以及数据的稀缺性,正成为阻碍技术落地和社区创新的主要壁垒。开源生态的繁荣,正试图打破这一僵局,推动AI从实验室走向千行百业。

LLaVA-OneVision-1.5是什么

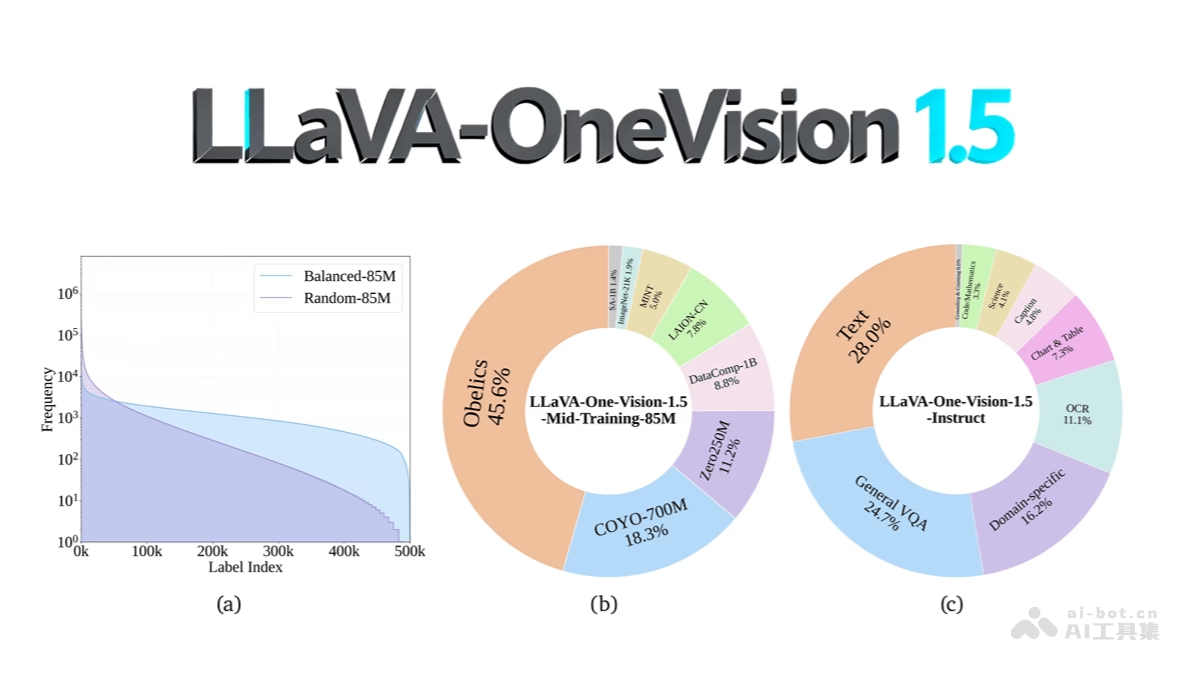
LLaVA-OneVision-1.5 是开源的多模态模型,通过高效训练和高质量数据实现高性能、低成本和强复现性。采用自研的 RICE-ViT 作为视觉编码器,结合 2D 旋转位置编码和区域感知注意力机制,支持可变输入分辨率,增强对象和 OCR 能力。语言模型基于 Qwen3,通过三阶段训练流程(语言–图像对齐、高质量知识中期预训练和视觉指令对齐)进行优化。训练中采用离线并行数据打包和混合并行策略,提升算力和显存效率。数据方面,构建了 85M 预训练数据集,采用“概念均衡”策略,涵盖多种来源;22M 指令数据覆盖八大类别,经过多源聚合和格式统一。LLaVA-OneVision-1.5 在多模态基准上表现出色,成本可控,且全链条透明开放,提供代码、数据和模型资源,助力社区低成本复现和拓展。
阅读目录
  • LLaVA-OneVision-1.5是什么
  • LLaVA-OneVision-1.5的主要功能
  • LLaVA-OneVision-1.5的技术原理
  • LLaVA-OneVision-1.5的项目地址
  • LLaVA-OneVision-1.5的应用场景
      • 📝 站长洞察 (Editor’s Insight)

LLaVA-OneVision-1.5

LLaVA-OneVision-1.5的主要功能

  • 多模态理解与生成:能处理和理解图像、文本等多种模态的信息,生成高质量的文本描述、回答问题或进行推理。
  • 视觉问答(VQA):针对图像中的内容回答问题,支持广泛的视觉任务,如物体识别、场景理解等。
  • 图像描述生成:为输入的图像生成准确且富有细节的描述文本,帮助用户更好地理解图像内容。
  • 指令遵循与执行:根据用户提供的指令执行相应的任务,如图像编辑、信息提取等,具有良好的指令泛化能力。
  • 跨模态检索:支持基于文本查询图像或基于图像查询文本,实现跨模态的信息检索。
  • 长尾识别能力:对数据中出现频率较低的类别或概念也能进行有效识别和理解,提升模型的泛化能力。
  • 多语言支持:支持多种语言的输入和输出,具备一定的跨语言理解和生成能力。
  • 知识增强:通过高质量的知识数据进行预训练,使模型具备更丰富的世界知识,更好地处理复杂的多模态任务。
  • 高效训练与复现:采用优化的训练策略和数据打包技术,实现高效的训练过程,提供完整的代码和数据资源,方便社区复现和拓展。

LLaVA-OneVision-1.5的技术原理

  • 视觉编码器:采用自研的 RICE-ViT(Region-aware Cluster Discrimination Vision Transformer)作为视觉主干,通过区域感知注意力机制和统一的区域簇判别损失,增强对图像中局部区域的语义理解,同时支持可变输入分辨率。
  • 投影器设计:通过多层感知机(MLP)将视觉特征映射到语言模型的文本嵌入空间,实现视觉特征与语言特征的有效对齐。
  • 语言模型:基于 Qwen3 作为语言骨干,提供强大的语言生成和理解能力,支持多模态任务中的文本处理。
  • 三阶段训练流程:包括语言–图像对齐、高质量知识中期预训练和视觉指令对齐,逐步提升模型的多模态对齐能力和任务泛化能力。
  • 离线并行数据打包:通过特征驱动的“概念均衡”策略构建预训练数据集,并采用离线并行数据打包技术,减少 padding 浪费,提高训练效率。
  • 混合并行与长上下文优化:在训练过程中采用混合并行(张量并行、流水并行和序列并行)以及长上下文优化技术,提升算力利用和显存效率。
  • 数据构建与优化:构建了大规模的预训练数据集和指令微调数据集,通过多源聚合、格式统一和安全筛除等手段,确保数据的高质量和多样性。

LLaVA-OneVision-1.5的项目地址

  • Github地址:https://github.com/EvolvingLMMs-Lab/LLaVA-OneVision-1.5
  • HuggingFace模型库:https://huggingface.co/collections/lmms-lab/llava-onevision-15-68d385fe73b50bd22de23713
  • arXiv技术论文:https://arxiv.org/pdf/2509.23661
  • 在线体验Demo:https://huggingface.co/spaces/lmms-lab/LLaVA-OneVision-1.5

LLaVA-OneVision-1.5的应用场景

  • 智能客服:通过理解用户上传的图像或文本信息,提供自动化的客服支持,解答问题并提供解决方案。
  • 内容创作:帮助创作者生成图像描述、创意文案或故事,提升创作效率和质量。
  • 教育辅助:在教育领域,用于解释图像中的内容,辅助教学,帮助学生更好地理解复杂的视觉信息。
  • 医疗影像分析:辅助医生解读医学影像,提供初步诊断建议或生成影像报告。
  • 智能驾驶:在自动驾驶系统中,用于理解道路场景,辅助决策,提升驾驶安全性。
  • 图像编辑与设计:根据用户指令对图像进行编辑、裁剪、添加特效等操作,提升图像处理的便捷性。

📝 站长洞察 (Editor’s Insight)

LLaVA-OneVision-1.5的发布,标志着开源多模态模型进入了“高效、透明、普惠”的新阶段。其核心价值远超一个新模型本身:它通过RICE-ViT等自研技术,在架构层面实现了对复杂场景(如OCR、小目标)的精准理解;更关键的是,它公开了完整的85M+22M数据集构建管线和三阶段训练配方,将“如何炼好模型”的方法论系统化、产品化。这解决了过去开源模型‘只给鱼不给渔’的痛点,为社区和企业提供了可复制的工业化流水线。在Sora、GPT-4o引领的多模态浪潮下,此类全栈透明的开源项目,是降低AI创业门槛、激发下游应用创新的关键基础设施。未来,竞争将不仅在于模型单点性能,更在于谁能构建更高效、更开放的生态。

🚀 Prompt 语宙 AI 创作者生态:探索 2,000+ 全球实用 AI 工具与高精度生图提示词咒语库
🧭 语宙 AI 导航 (ai.paooo.com)🎨 AI 生图 Prompt 库⚡ AIGC 早报生成器
阿里AntV开源Infographic框架:AI驱动、197种模板,一键生成高质量信息图
Voice Changer – Cartesia推出转换声音同时保留原始情感的变声器模型
背后没有操作系统与真实文件!WorldTUI 开源 208MB 极客小模型:基于 Qwen2.5-Coder 纯神经符号“表演”Linux 终端交互全景实测深度拆解
Uber总裁公开质疑AI投入:四个月烧光全年预算,Token暴涨为何难换实质回报?
IronClaw:Rust驱动的本地安全AI助手,WASM沙盒隔离+加密保险柜,彻底解决数据隐私难题
TAGGED:LLaVA-OneVision-1.5Qwen3RICE-ViT多模态大模型开源AI模型
分享
Email 复制链接 打印
Share
上一篇 字节抖音联合新加坡国立大学开源SAIL-VL2:MoE架构视觉语言模型革新多模态AI 字节抖音联合新加坡国立大学开源SAIL-VL2:MoE架构视觉语言模型革新多模态AI
下一篇 StableAvatar: 复旦微软联手,音频驱动虚拟人视频生成革命,无需后处理即可生成无限长度高清视频 StableAvatar: 复旦微软联手,音频驱动虚拟人视频生成革命,无需后处理即可生成无限长度高清视频
发表评价

发表评价 取消回复

您的邮箱地址不会被公开。 必填项已用 * 标注

Please select a rating!

Ad image
- 入群领取知识星球折扣卷, 仅剩99份 -
Ad imageAd image

最近更新

开源全双工实时语音新王者!AI降临派开源Sophon-Realtime v1:32B统一大脑单token判话轮、VoiceBench斩获82.8分力压群雄技术全景拆解
AI 工具
流光脑波AI大脑占位特色图
折叠屏开卖双周生态迎大考!苹果iPhone Duo携手DeepSeek与B站开启双屏重构:10万App撑场下的自适应渲染与iOS 27体验博弈全景拆解
最新趋势
单卡吞吐飙升86%且总参数达1.6万亿!美团重磅开源原生多模态大模型LongCat-2.5:首创W4A4 FlatQuant量化与百万上下文长程Agent技术全景拆解
AI 工具
49.1% 登顶 FrontierCode 绝杀全场!Anthropic 重磅发布 Claude Fable 5.2 与 Mythos:千级智能体 8 天手搓可启动操作系统全景架构深度拆解
最新趋势

相关推荐

AnimaX框架:北航清华联合发布,文本驱动多视图3D动画生成,兼容任意骨骼结构
AI 工具AIGC 资讯

AnimaX框架:北航清华联合发布,文本驱动多视图3D动画生成,兼容任意骨骼结构

站外新闻
3D动画生成 AIGC 具身智能 视频扩散模型 骨骼动画
美团GEO营销门户 – 美团推出的生成式引擎优化平台
AIGC 资讯

美团GEO营销门户 – 美团推出的生成式引擎优化平台

站外新闻
腾讯混元Tencent-HY-MT1.5开源翻译模型:1.8B端侧量化仅需1GB,33种语言离线秒译
AI 工具

腾讯混元Tencent-HY-MT1.5开源翻译模型:1.8B端侧量化仅需1GB,33种语言离线秒译

站外新闻
多语言翻译 开源大模型 端侧部署 翻译模型 腾讯混元
混元图生视频 – 腾讯混元开源的图生视频模型
AIGC 资讯

混元图生视频 – 腾讯混元开源的图生视频模型

站外新闻
/ Prompt 语宙 /

探索生成式 AI 的无限创作潜能,一站式获取前沿 AIGC 资讯、高阶 Prompt 咒语与全球实用 AI 工具。

核心专栏

  • Remaker AI
  • BGRemaker 抠图Hot
  • AIGC 工具
  • Prompt 咒语生成器
  • 去水印工具

生态与服务

  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器

标签

AIGC Midjourney prompt AI Agent openai GPT Image 2 具身智能 字节跳动 Anthropic 多模态大模型 AI绘画 EvoLink灵感 开源工具 开源大模型 开源模型 早报 AI智能体 大语言模型 MoE架构 腾讯混元 强化学习 AI视频生成 chatgpt 阿里通义 DeepSeek 多模态AI Claude Code AI工具 世界模型 教程
Prompt 语宙Prompt 语宙
Follow US
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.