


💡 站外导读:在大模型参数军备竞赛愈演愈烈之际,高昂的推理成本与资源消耗成为企业落地AI的核心痛点。阿里通义此次开源的Qwen3-Next,直击这一行业难题,通过创新的混合架构与极致激活策略,在80B总参数中实现仅3B参数的轻量化激活,为高并发、长上下文场景提供了兼具性能与经济性的新范式,标志着大模型从“比大”向“比效”的关键转折。
Qwen3-Next是什么
Qwen3-Next是阿里通义开源的新一代混合架构大模型,包含指令版(Qwen3-Next-80B-A3B-Instruct )和思维版(Qwen3-Next-80B-A3B-Thinking)两个版本。模型用全球首创的Gated DeltaNet和Gated Attention混合架构,实现更快的处理速度、更强的效果和更省的资源消耗。模型总参数量达80B,每次推理仅激活约3B参数。模型预训练加速机制使长文生成速度显著提升。Qwen3-Next适用长上下文推理、高并发和低延迟需求场景,模型现已上线阿里云百炼支持API调用和QwenChat网页版支持在线体验。
Qwen3-Next的主要功能
- 指令理解和执行:特别优化的指令版(Instruct)擅长理解和执行用户的指令。
- 深度思考和推理:思维版(Thinking)支持多步推理和深度思考问题。
- 长文本处理:模型能处理和理解长达32K以上的长文本输入。
- 高效率推理:基于混合动力引擎,结合速度和精度,实现快速且准确的推理。
- 节省资源:在保持大模型能力的同时,通过激活部分参数节省计算资源。
Qwen3-Next的技术原理
-
混合架构:结合75%的Gated DeltaNet和25%的Gated Attention,平衡速度和精度。
-
Gated DeltaNet:用在处理长文本,提供快速的推理速度和线性增长的内存占用。
-
Gated Attention:负责精确召回关键信息,确保模型在处理长文本时不会丢失重点。
-
-
极致省钱架构:模型总参数量为80B,每次推理时仅激活约3B参数,显著降低计算成本。
-
预训练加速机制:通过原生MTP(Multi-Token Prediction)加速技术,模型在预训练阶段就能一次预测多个token,在生成长文本时减少推理步数,提高吞吐量。
-
专家系统(MoE):模型包含512个专家,每次处理请求时动态选择最相关的10个专家和1个共享专家来工作,实现负载均衡和资源优化。
Qwen3-Next的项目地址
- HuggingFace模型库:https://huggingface.co/collections/Qwen/qwen3-next-68c25fd6838e585db8eeea9d
Qwen3-Next的性能表现
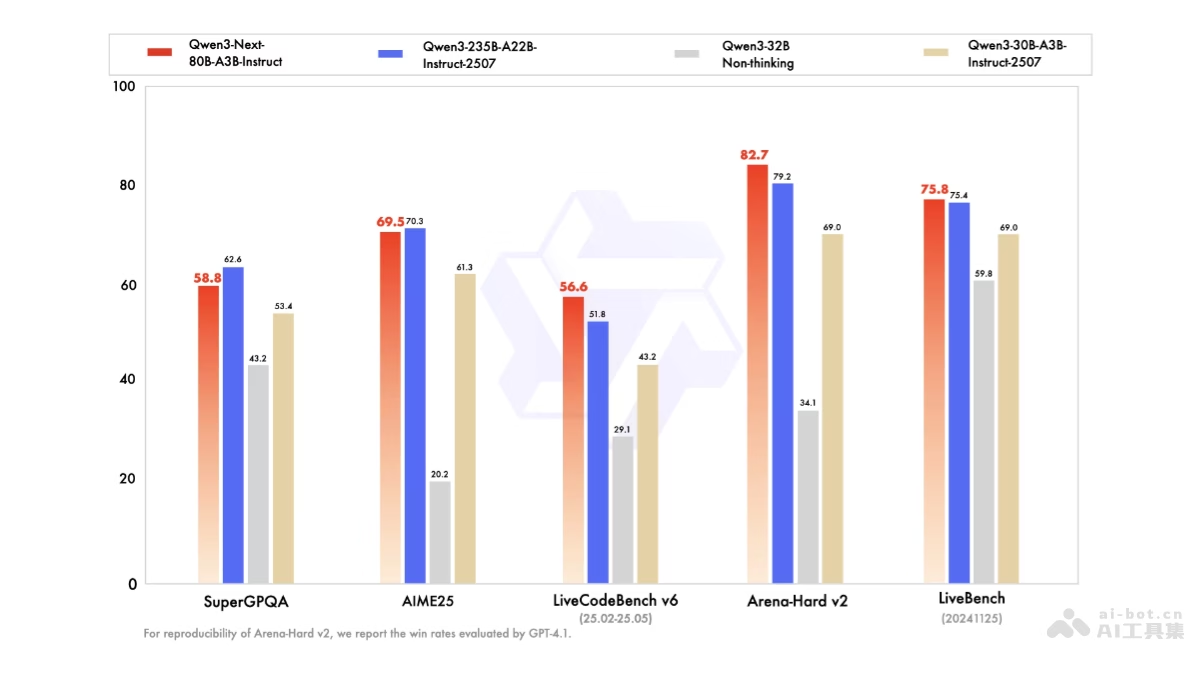
- Instruct 模型表现:在多个基准测试中,Qwen3-Next-80B-A3B-Instruct 模型的指令能力与235B旗舰模型相当,并且在处理长文本方面表现更强。
- Thinking 模型表现:Qwen3-Next-80B-A3B-Thinking 模型在推理能力方面超越Gemini Flash,部分指标甚至逼近235B旗舰模型。
如何使用Qwen3-Next
- 阿里云百炼:访问阿里云百炼官网,搜索Qwen3-Next,根据提供的API参考进行模型调用。
- QwenChat 网页版:直接访问QwenChat官网,在线与模型进行交互。
- Hugging Face:在Hugging Face上,找到Qwen3-Next模型集合,进行模型调用和体验。
Qwen3-Next的应用场景
-
智能客服:利用模型指令理解和执行能力,提供自动化的客户服务和支持。
-
内容生成:在新闻、博客、社交媒体等领域,能自动生成文章、故事或其他文本内容。
-
数据分析:数据分析人员分析大量文本数据,提取关键信息,支持市场研究和商业智能。
-
教育辅助:在教育领域,辅助学生学习,提供个性化教学内容和辅导。
-
法律咨询:法律人士分析法律文件,提供法律咨询和研究支持。
📝 站长洞察 (Editor’s Insight)
Qwen3-Next的发布,绝非一次简单的模型迭代,而是阿里在“高效大模型”这一前沿赛道上的关键落子。其混合架构(Gated DeltaNet+Gated Attention)与MoE专家系统的深度融合,本质上是在解构传统Transformer的“暴力计算”路径,转向更精细的“智能调度”范式。这背后是行业对模型边际成本与收益的重新审视——当通用能力逼近天花板,如何以更低的边际成本服务更广的垂直场景,将成为下一阶段的竞争焦点。阿里此举,既是对自身云服务成本结构的优化,也为开源社区提供了“够用、好用、省用”的新标杆,可能引发一波关于模型架构“轻量化重构”的行业思潮。
Qwen3-Next是什么模型?
Qwen3-Next是阿里通义开源的新一代混合架构大模型,包含指令版和思维版两个版本。它采用Gated DeltaNet与Gated Attention结合的设计,总参数80B,但每次推理仅激活约3B参数,主打高效、低成本和长上下文能力。
Qwen3-Next适合哪些使用场景?
它适合长上下文推理、高并发和低延迟需求场景,也可用于智能客服、内容生成、数据分析、教育辅助和法律咨询等任务。由于激活参数少,尤其适合对推理成本敏感的企业应用。
Qwen3-Next怎么使用和体验?
可通过阿里云百炼进行API调用,也可在QwenChat网页版在线体验;此外,Hugging Face上也提供了模型集合,便于下载、调用和测试。
📊 Qwen3-Next 与对比模型在五项基准上的得分对比(AI 视觉结构化提取)
核心发现:Qwen3-Next-80B-A3B-Instruct 在五项基准中整体表现强劲,尤其在 Arena-Hard v2 和 LiveBench 上领先或接近领先对比模型,体现出较高的综合效率与能力。
| 基准 | Qwen3-Next-80B-A3B-Instruct | Qwen3-235B-A22B-Instruct-2507 | Qwen3-32B-Non-thinking | Qwen3-30B-A3B-Instruct-2507 |
|---|---|---|---|---|
| SuperGPQA | 58.8 | 62.6 | 43.2 | 53.4 |
| AIME25 | 69.5 | 70.3 | 20.2 | 61.3 |
| LiveCodeBench v6 (25.02-25.05) | 56.6 | 51.8 | 29.1 | 43.2 |
| Arena-Hard v2 | 82.7 | 79.2 | 34.1 | 69.0 |
| LiveBench (20241125) | 75.8 | 75.4 | 59.8 | 69.0 |
混合架构模型适合哪些业务场景?
适合高并发、长上下文和预算敏感的场景,比如客服、知识问答和企业助手。若任务更依赖极致推理或复杂代码生成,仍要用真实业务集做压测,确认质量没有被压缩。
MoE 与 Gated 结构上线要注意什么?
重点看路由稳定性、专家负载均衡和延迟抖动。部署时要监控 token 级耗时、热点专家拥塞和冷启动问题,否则理论上的低成本可能被尾延迟吃掉。


