


MoshiVis是什么
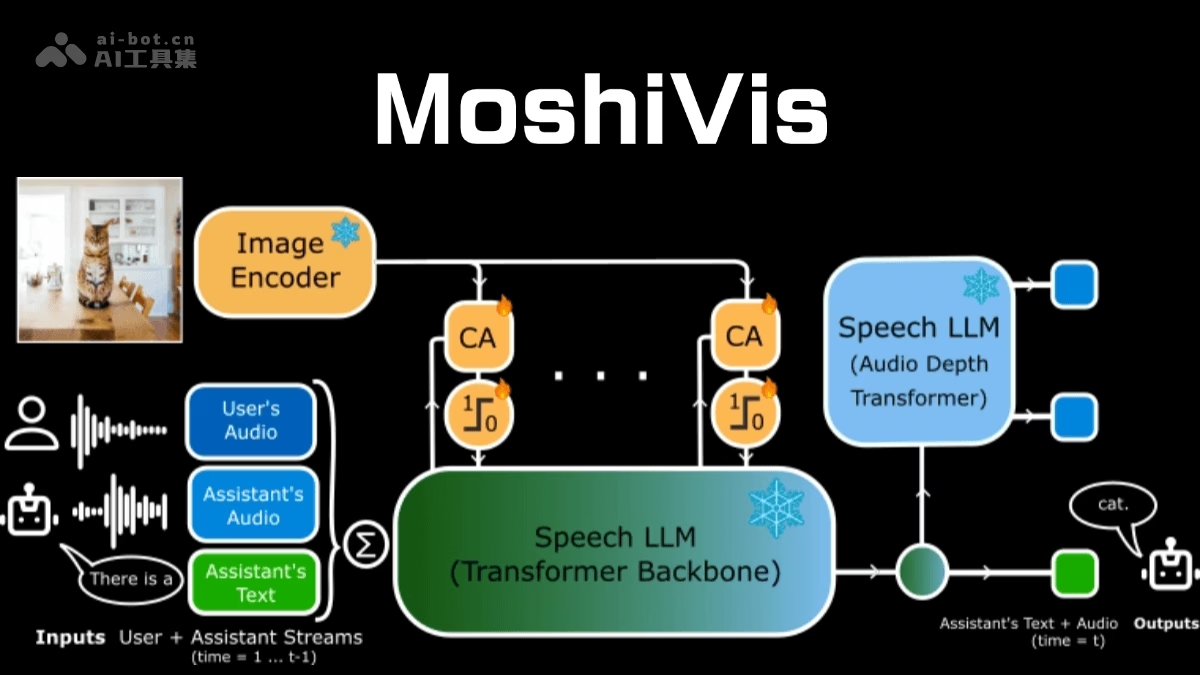
MoshiVis 是 Kyutai 推出的开源多模态语音模型,基于 Moshi 实时对话语音模型开发,增加了视觉输入功能。能实现图像的自然、实时语音交互,将语音和视觉信息相结合,让用户可以通过语音与模型交流图像内容。模型在 Moshi 的 7B 基础架构上,增加了约 206M 的适配器参数,集成了 400M 的 PaliGemma2 视觉编码器。通过跨注意力机制和门控机制,MoshiVis 能将视觉信息自然地融入语音流中,保持低延迟和自然对话风格。支持 PyTorch、Rust 和 MLX 三种后端,推荐使用 Web UI 前端进行交互。
MoshiVis的主要功能
- 视觉输入功能:MoshiVis 能接收图像输入,与语音交互相结合。用户可以通过语音指令与模型交流图像内容,例如询问图像中的场景、物体、人物等信息。
- 实时交互:模型支持实时语音交互,用户可以自然地与模型对话,无需等待长时间的处理。
- 多模态融合:MoshiVis 通过跨注意力机制将视觉信息与语音流相结合,模型能同时处理语音和视觉输入。
- 低延迟与自然对话:MoshiVis 在处理图像和语音信息时,能保持低延迟,确保交互的实时性。模型继承了 Moshi 的自然对话风格,能生成自然流畅的语音回应。
- 多后端适配:MoshiVis 支持 PyTorch、Rust 和 MLX 三种后端,用户可以根据需求选择合适的后端进行部署。推荐使用 Web UI 前端进行交互
- 无障碍应用:MoshiVis 适用于无障碍 AI 接口,能帮助视障人士通过语音交互理解视觉场景。
MoshiVis的技术原理
- 多模态融合机制:MoshiVis 通过集成轻量级交叉注意模块,将视觉编码器的视觉信息注入到 Moshi 的语音标记流中。使模型能同时处理语音和视觉输入,实现语音与图像内容的交互。具体来说,视觉编码器将图像特征提取出来,然后通过交叉注意力机制与语音流进行融合,模型能理解图像内容并生成与之相关的语音回应。
- 动态门控机制:为了更好地处理视觉输入与非视觉对话主题之间的切换,MoshiVis 引入了动态门控机制。可以根据对话内容的上下文动态调整视觉信息的影响力,确保模型在讨论图像相关话题时能充分利用视觉输入,在其他话题中减少视觉信息的干扰,提高对话的自然性和流畅性。
- 参数高效微调:MoshiVis 采用了单阶段、参数高效的微调流程。在训练过程中,模型利用图像-文本和图像-语音样本的混合数据进行训练,降低训练成本并提高模型的适应性。减少了对大规模图像-语音配对数据的需求,保留了语音模型的韵律特征,如说话者的语调。
MoshiVis的项目地址
- 项目官网:kyutai.org/moshivis
- Github仓库:https://github.com/kyutai-labs/moshivis
- arXiv技术论文:https://arxiv.org/pdf/2503.15633
MoshiVis的应用场景
- 老年人辅助:对于视力不佳或行动不便的老年人,MoshiVis 可以作为智能助手,帮助他们识别物品、阅读文字或获取环境信息。
- 智能家居控制:在智能家居环境中,用户可以通过语音指令让 MoshiVis 识别房间内的设备或场景,进行相应的控制操作。
- 视觉辅助学习:在教育领域,MoshiVis 可以帮助学生通过语音交互学习图像内容,例如识别动植物、历史文物等。
- 社交媒体互动:用户可以上传图片,MoshiVis 通过语音生成有趣的描述或评论,增强社交媒体的互动性。
- 工业检查:在工业环境中,MoshiVis 可以帮助工人通过语音交互检查设备状态、识别故障部位。
🧭 文中关联 AI 工具官网与参数卡(语宙 AI 导航)
❓ 常见问题解答(FAQ)
MoshiVis 和 Moshi 有什么区别?
MoshiVis 基于 Moshi 实时对话语音模型扩展而来,核心区别是新增了视觉输入能力。它通过视觉编码器、跨注意力和门控机制,把图像信息融入语音流,实现图像与语音的实时交互。
MoshiVis 适合哪些实际应用场景?
文章提到的典型场景包括无障碍辅助、老年人帮助、智能家居控制、视觉辅助学习、社交媒体图片互动和工业检查。它尤其适合需要“看图并用语音交流”的任务。
MoshiVis 的部署和使用门槛高吗?
MoshiVis 支持 PyTorch、Rust 和 MLX 三种后端,并推荐使用 Web UI 前端交互,说明它兼顾了研究与实际部署需求。对于开发者来说,选择合适后端即可按场景集成。
🔬 语宙深潜追问 · 进阶实操拆解
视觉输入加入后延迟怎么不爆炸?
要把视觉编码做成低频更新,而不是每轮对话都全量重算;同时用跨注意力只注入关键视觉 token。部署时可采用流式语音解码、异步视觉预处理和小缓存窗口,尽量把端到端延迟控制在可对话范围内。
开源多后端部署适合哪些产品形态?
最适合边缘设备、私有化助手和行业终端,例如智能家居、导览机、辅助阅读设备。不同后端可按算力选择量化、裁剪或云边协同,但要统一输入输出协议,避免模型能力和工程适配割裂。
🗳️ 读者观点微投票 · 您的实战立场是?
多模态实时语音模型最该优先做什么?


