

💡 站外导读:把网站迁移至 CDN 原本是为了降低延迟并替源站挡住并发洪峰,但无数运维与 SEO 团队都在切换 DNS 的第一天踩中过同一个“反直觉深坑”:源站负载不仅没降,反而被突然涌入的爬虫打到飙红,紧接着一气之下打开全量防爬盾又把 Googlebot 拦在了验证码门外。Google 工程师 Gary Illyes 与 Cherry Prommawin 联合官方技术博客拆解了这一悖论的底层机理与三步破局方案。
为什么切上 CDN 反而引爆源站流量?Googlebot 提速算法与冷缓存穿透悖论
“拔掉消防栓阀门”的物理真相:边缘低延迟被系统判定为服务器硬件扩容
在 Google Search Central 11 月发布的官方技术指南《Moving to a CDN without overwhelming your origin》以及 Gary Illyes 与 Cherry Prommawin 主讲的节目中,两位工程师直言不讳地指出了 CDN 迁移最容易被误解的时序陷阱:刚启用 CDN 时,它并不会在第一毫秒就充当源站的盾牌。原因首先来自 Google 抓取基础设施计算站点抓取容量上限(crawl capacity limit,内部亦称 hostload)的核心规则——爬虫会持续监测主机响应耗时与连接稳定性,响应越慢则自动减速避免压垮业务,反之只要服务器延迟大幅下降且保持稳定,在存在抓取需求的前提下,系统就会判定底层基础设施极度健康,进而逐步调高抓取速率。
当站点将 DNS 切换至全球分布的 CDN 边缘节点后,TCP 握手与响应耗时骤降,在 Google 爬虫系统眼里,这几乎等同于网站刚刚完成了一次大规模硬件扩容。然而致命的反差在于“冷缓存(cold cache)”机制:全新接入的 CDN 边缘节点初始缓存是空的,面对每一个独立 URL 的首次访问,边缘节点必然触发缓存未命中(cache miss),不得不一路回源向真实源站拉取 HTML、CSS、JavaScript 与图片资产,直到同一 URL 迎来第二次请求时才能形成缓存命中(cache hit)。更棘手的是,人类访客高度集中在首页或少数热门促销页,很快就能暖热边缘缓存;而搜索引擎爬虫的天职却是横向遍历全站海量长尾库存 URL,每一次首次探访都意味着 100% 穿透回源——正如 Gary Illyes 的形象比喻:“CDN 等于拔掉了水龙带上的阀门,结果爬虫全在直接对着消防栓猛喝。”
比源站过载更致命的二次事故:全量 WAF 与验证码如何把 Googlebot 逐出索引
当恐慌运维遇上“点击红绿灯验证”:合法爬虫被关进 403 黑屋的掉收录链路
如果说冷缓存回源只是短暂的算力阵痛,那么接下来的人为误操作往往会直接摧毁全站自然搜索流量。当站点管理员在监控面板上看到迁移后自动化请求曲线陡然拉升时,极易误判自己正遭遇恶意爬虫或 Botnet 暴力采集,在焦虑驱动下直接登录 Cloudflare 等 CDN 控制台,把“Bot Protection(全量机器人防护)”开关一拨到底。Search Engine Journal 作者 Roger Montti 就曾目睹过一个经典故障案例:某高流量网站只要一开启 CDN 流量就断崖式下跌,一旦关闭流量立刻回升,团队与客服排查许久才定位到元凶正是过激的机器人拦截规则。
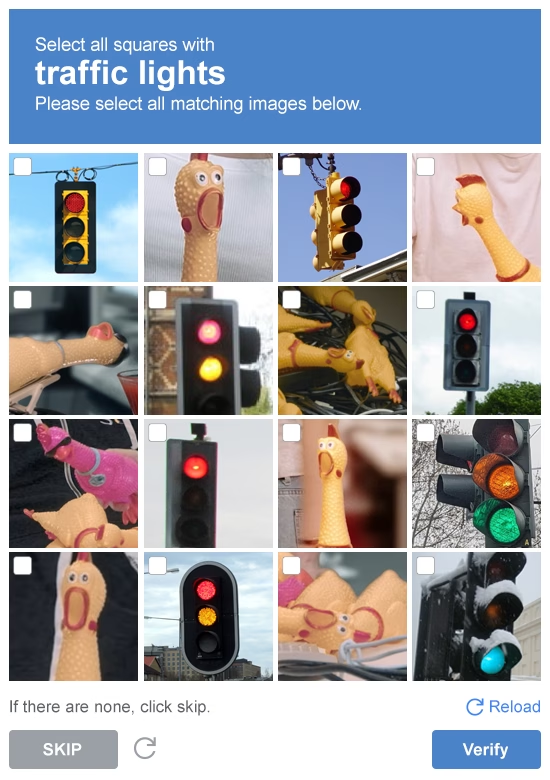
Cherry Prommawin 在剖析这类“一刀切(blanket security rules)”策略时指出,未经豁免的全局防爬规则会把所有自动化客户端视同一律,当 WAF 检测到机器特征后,往往会弹出 CAPTCHA 人机校验页面要求识别交通信号灯或小鸡图片。Googlebot 固然擅长解析复杂网页,却根本无法识别红绿灯图片,只能卡在报错页或 403 拦截墙前原地失败。从 Google 搜索系统的视角来看,这意味着该站点已被人为封锁或持续损坏,若此类误杀规则长期开启而不加以豁免,爬虫会被迫撤退,紧接着网站的普通网页、商品列表乃至图片资产都将开始逐步从搜索索引中彻底脱落。
给 CDN 迁移配好“防爆阀”:Google 官方三层无损切流与紧急制动清单
上线前程序化预热缓存、配置 Verified Bot 白名单与 429/503 短时降速窗口
面对“不拦则源站承压,乱拦则丢失收录”的两难境地,Google 工程师在官方博客中给出了一套可落地的三步防爆作战方案。第一步是在全面切换流量入口之前实施“缓存预热(Cache Pre-warming)”:站点运维不应指望上线后靠外部流量自然填充边缘节点,而应当在正式向搜索引擎敞开大门前,通过程序化脚本以可控速率预先经由 CDN 拉取全站高流量入口页、即将上线的大促落地页以及爬虫最高频访问的核心 URL 列表,提前把边缘缓存池灌满,从源头上削平冷启动阶段的穿透尖峰。
第二步是以“精细化豁免与定向拦截”替代全局 CAPTCHA:当今主流 CDN 与 WAF 平台均内置了“Known / Verified Bots(已验证爬虫)”管理开关,管理员务必在开启防爬规则的同时放行受信任的搜索引擎及合法 AI 爬虫(并可通过 Google 公开发布的官方 IP 段清单进行源站与边缘双端校验),将拦截矛头通过 `robots.txt` 或特征规则精准指向具体的恶意采集器。第三步则是预备“紧急制动闸”:如果在缓存预热爬坡期间,源站依然因为高并发抓取而面临宕机风险,切忌直接返回 403 封禁,而应在服务端或 CDN 限速策略中配置临时返回 HTTP `429 (Too Many Requests)` 或 `503 (Service Unavailable)` 状态码,持续几个小时(最长不超过 1 到 2 天),让爬虫安全、平稳地放慢脚步为人类用户让路。
| 迁移场景 / 运维动作 | 底层触发与执行机制 | 对源站与 Googlebot 的实际影响 | Google 官方推荐工程处置 |
|---|---|---|---|
| DNS 直接冷切换至 CDN | 边缘响应极快触发 Hostload 提速,但初始缓存全空导致首访全量 Miss | 海量长尾 URL 首次抓取 100% 穿透回源,源站负载不降反升 | 切流前通过脚本按可控并发对核心与高频页面执行程序化预热 |
| 恐慌开启全量 Bot 防护 / CAPTCHA | WAF 将高频自动化请求一律拦截并下发图形验证码或 403 墙 | Googlebot 无法识别验证码持续失败,页面与商品逐步掉出索引 | 开启 Verified Bots 白名单与官方 IP 校验,仅定向封堵恶意采集器 |
| 长期返回 429 / 503 限流响应 | 持续向抓取系统暴露服务器不可用或过载信号超过 1–2 天安全窗口 | 短期虽保住源站,但长期被判定为站点持续故障从而削减收录 | 仅限紧急过载时短时开启(数小时至最多 1–2 天),缓解后立即恢复 |
| 预热 + 白名单 + 短时限流组合拳 | 边缘提前持有热点资产,可信爬虫无障碍通行,突发尖峰温和削峰 | 源站平稳过渡,边缘命中率达标且搜索抓取配额稳步正向扩容 | 上线后联动监测 CDN 回源命中率与 GSC Crawl Stats 状态码分布 |
从边缘缓存到 AI 爬虫并发时代:站点迁移后的运维监测与恢复边界
严防短时限流演变为永久 5xx 事故,同步对齐 Search Console 抓取统计曲线
对于正在规划或刚刚完成 Cloudflare、Fastly 或 CloudFront 接入的技术团队,理解这一套时序边界同样关系到 AI 搜索时代的抓取稳定性。如今除了传统 Googlebot 之外,各类大模型检索与用户触发型智能体爬虫同样对响应延迟高度敏感,边缘加速带来的低 TTFB 效应会被多重放大;但如果把 `429` 或 `503` 应急制动当作常态长期挂在线上,一旦超过 1 至 2 天的安全阈值,搜索引擎就会将其重新判定为服务器长期不可用,最终同样引发降权甚至退库。
因此,标准 SRE 级 CDN 迁移验收流程必须同时盯紧两条监测曲线:一侧在源站 Nginx/应用监控中追踪回源 Cache-Control 命中率与真实回源 QPS,另一侧在 Google Search Console 的“设置 → 抓取统计信息(Crawl Stats)”中核对每日抓取请求量、平均响应时间与 HTTP 200/403/429/503 状态码分布。只要确认核心目录缓存预热完成且 Verified Bot 通行无阻,站点就能真正安全度过最初的冷缓存危险窗口,把 CDN 的带宽护盾转化为稳固的搜索排名红利。
📝 站长洞察 (Editor’s Insight)
这条来自 Google 工程师的提醒之所以值得所有站长和 SRE 收藏,是因为它用极简的工程直觉戳破了一个普遍幻觉:CDN 不是在 DNS 解析生效那一秒就自动挡在服务器前面的防弹衣。在冷缓存期,面对人类访问它是一层护盾,面对全站扫荡的爬虫它却成了一个“替源站把延迟压低、诱使爬虫开足马力猛撞”的加速器。实际运维中,切忌一看到爬虫 QPS 暴涨就条件反射打开 Cloudflare 质询盾——宁可用精细限速临时返回几小时 429,也绝不能用一刀切的验证码把搜索引擎和合法 AI 检索网关在门外。


