


HumanOmni是什么
HumanOmni 是专注于人类中心场景的多模态大模型,视觉和听觉模态融合而成。通过处理视频、音频或两者的结合输入,能全面理解人类行为、情感和交互。模型基于超过240万视频片段和1400万条指令进行预训练,采用动态权重调整机制,根据不同场景灵活融合视觉和听觉信息。HumanOmni 在情感识别、面部描述和语音识别等方面表现出色,适用于电影分析、特写视频解读和实拍视频理解等多种场景。
HumanOmni的主要功能
- 多模态融合:HumanOmni 能同时处理视觉(视频)、听觉(音频)和文本信息,通过指令驱动的动态权重调整机制,将不同模态的特征进行融合,实现对复杂场景的全面理解。
- 人类中心场景理解:模型通过三个专门的分支分别处理面部相关、身体相关和交互相关场景,根据用户指令自适应地调整各分支的权重,适应不同任务需求。
- 情绪识别与面部表情描述:在动态面部情感识别和面部表情描述任务中,HumanOmni 表现出色,超越了现有的视频-语言多模态模型。
- 动作理解:通过身体相关分支,模型能够有效理解人体动作,适用于动作识别和分析任务。
- 语音识别与理解:在语音识别任务中,HumanOmni 通过音频处理模块(如 Whisper-large-v3)实现对语音的高效理解,支持特定说话人的语音识别。
- 跨模态交互:模型结合视觉和听觉信息,能更全面地理解场景,适用于电影片段分析、特写视频解读和实拍视频理解等任务。
- 灵活的微调支持:开发者可以基于 HumanOmni 的预训练参数进行微调,适应特定数据集或任务需求。
HumanOmni的技术原理
- 多模态融合架构:HumanOmni 通过视觉、听觉和文本三种模态的融合,实现对复杂场景的全面理解。在视觉部分,模型设计了三个分支:面部相关分支、身体相关分支和交互相关分支,分别用于捕捉面部表情、身体动作和环境交互的特征。通过指令驱动的融合模块动态调整权重,根据用户指令自适应地选择最适合任务的视觉特征。
- 动态权重调整机制:HumanOmni 引入了指令驱动的特征融合机制。通过BERT对用户指令进行编码,生成权重,动态调整不同分支的特征权重。在情感识别任务中,模型会更侧重于面部相关分支的特征;在交互场景中,会优先考虑交互相关分支。
- 听觉与视觉的协同处理:在听觉方面,HumanOmni 使用Whisper-large-v3的音频预处理器和编码器处理音频数据,通过MLP2xGeLU将其映射到文本域。视觉和听觉特征在统一的表示空间中结合,进一步输入到大语言模型的解码器中进行处理。
- 多阶段训练策略:HumanOmni 的训练分为三个阶段:
- 第一阶段构建视觉能力,更新视觉映射器和指令融合模块的参数。
- 第二阶段发展听觉能力,仅更新音频映射器的参数。
- 第三阶段进行跨模态交互集成,提升模型处理多模态信息的能力。
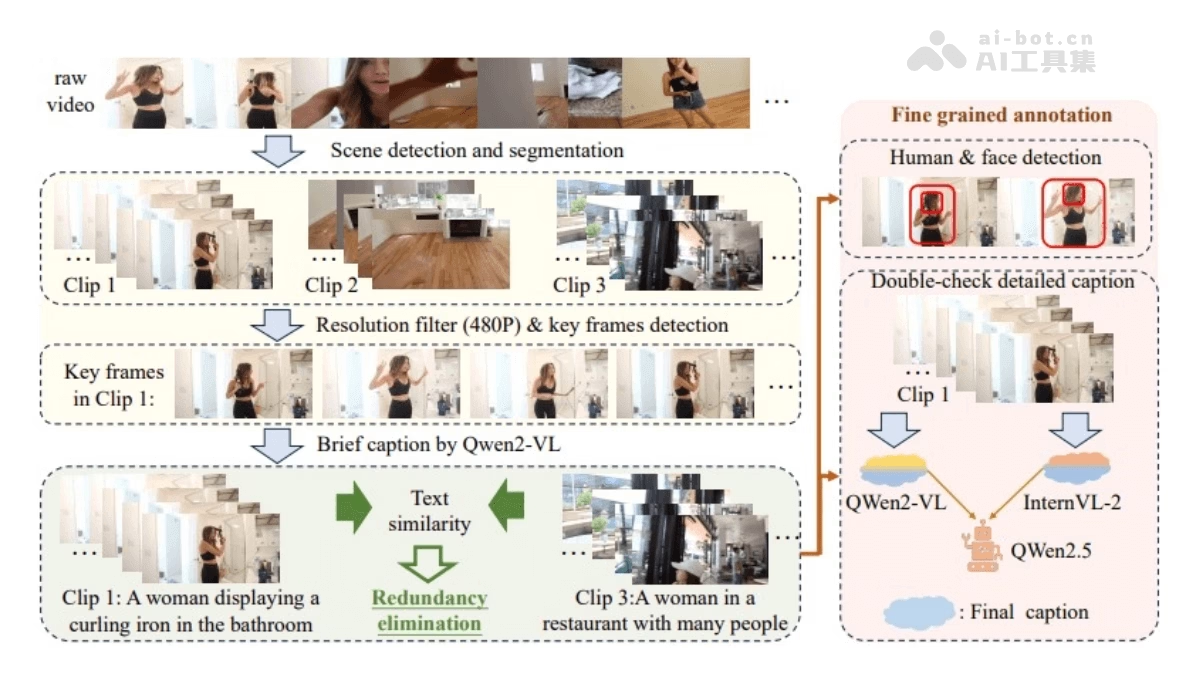
- 数据驱动的优化:HumanOmni 基于超过240万个人类中心视频片段和1400万条指令数据进行预训练。数据涵盖了情感识别、面部描述和特定说话人的语音识别等多个任务,模型在多种场景下表现出色。
HumanOmni的项目地址
- Github仓库:https://github.com/HumanMLLM/HumanOmni
- HuggingFace模型库:https://huggingface.co/StarJiaxing/HumanOmni-7B
- arXiv技术论文:https://arxiv.org/pdf/2501.15111
HumanOmni的应用场景
- 影视与娱乐:HumanOmni 可用于影视制作,如虚拟角色动画生成、虚拟主播和音乐视频创作。
- 教育与培训:在教育领域,HumanOmni 可以创建虚拟教师或模拟训练视频,辅助语言学习和职业技能培训
- 广告与营销:HumanOmni 能生成个性化广告和品牌推广视频,通过分析人物情绪和动作,提供更具吸引力的内容,提升用户参与度。
- 社交媒体与内容创作:HumanOmni 可以帮助创作者快速生成高质量的短视频,支持互动视频创作,增加内容的趣味性和吸引力。
🧭 文中关联 AI 工具官网与参数卡(语宙 AI 导航)
❓ 常见问题解答(FAQ)
HumanOmni 主要解决什么问题?
HumanOmni 主要面向人类中心场景,重点理解人物的面部表情、身体动作、语音内容和交互关系。它把视频、音频和文本结合起来,适合做情感识别、面部描述、动作理解和实拍视频分析。
HumanOmni 的核心技术亮点是什么?
核心亮点是三分支视觉架构与指令驱动的动态权重调整机制。模型分别处理面部、身体和交互特征,并根据用户指令自适应融合;同时结合 Whisper-large-v3 处理音频,增强跨模态理解能力。
HumanOmni 适合哪些应用场景?
它适合影视与娱乐、教育培训、广告营销和社交媒体内容创作等场景。比如虚拟角色动画、虚拟教师、个性化广告视频,以及基于人物情绪和动作分析的短视频生成与互动内容创作。
🔬 语宙深潜追问 · 进阶实操拆解
这类模型如何避免只会看脸不会懂场景?
训练时要把面部、语音、镜头语境一起对齐,而不是只喂特写片段。实操上可用分层标注、跨模态对比学习和动态权重调节,让模型在表情、语气和上下文之间建立稳定关联。
做电影分析时该怎么设计提示词?
先明确任务是情绪、角色关系还是镜头语言,再要求模型分段输出证据。最好让它引用具体时间点、台词和表情变化,避免泛泛而谈;长视频场景下还要配合分段摘要和关键帧检索。
🗳️ 读者观点微投票 · 您的实战立场是?
人类中心多模态模型最该先攻克哪项能力?


