Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
Search
  • Contact
  • Blog
  • Complaint
  • Advertise
© 2024 Prompt 语宙. HalfPX. All Rights Reserved.
阅读: OmniHuman – 字节跳动推出的单张照片生成全身动态视频生成框架
Share
登陆
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
Search
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • Contact
  • Blog
  • Complaint
  • Advertise
© 2023 Prompt 语宙. Paooo.com. All Rights Reserved.
OmniHuman – 字节跳动推出的单张照片生成全身动态视频生成框架
Prompt 语宙 > AIGC 资讯 > OmniHuman – 字节跳动推出的单张照片生成全身动态视频生成框架
AIGC 资讯

OmniHuman – 字节跳动推出的单张照片生成全身动态视频生成框架

站外新闻
最近更新: 2026年6月9日 上午8:23
SHARE

OmniHuman是什么

OmniHuman是字节跳动推出的端到端多模态条件化人类视频生成框架,能基于单张人类图像和运动信号(如音频、视频或两者的组合)生成逼真的人类视频。OmniHuman基于多模态运动条件混合训练策略,克服以往方法因高质量数据稀缺而导致的性能瓶颈,支持任意宽高比的图像输入(包括肖像、半身和全身图像),能适应多种场景。OmniHuman 在歌唱、对话、手势处理等方面表现出色,支持多种视觉和音频风格,同时兼容音频、视频及组合驱动,生成高质量的视频内容。
阅读目录
  • OmniHuman是什么
  • OmniHuman的主要功能
  • OmniHuman的技术原理
  • OmniHuman的项目地址
  • OmniHuman的应用场景

OmniHuman

OmniHuman的主要功能

  • 多模态驱动的视频生成:
    • 支持音频驱动(如说话、唱歌)和姿势驱动(如手势、动作),且能结合两者进行混合驱动,生成自然流畅的人类动作视频。
    • 支持多种输入形式,包括面部特写、半身像、全身像,兼容不同比例和风格的图像。
  • 高逼真度与多样化动作:
    • 生成的视频在视觉上高度逼真,具备自然的面部表情、肢体动作和流畅的动态效果。
    • 能处理复杂的动作和对象交互,例如唱歌时演奏乐器、手势与物体的自然互动等。
  • 灵活的视频生成:
    • 支持任意宽高比和时长的视频生成,根据输入信号生成不同长度的视频片段。
    • 兼容多种图像风格,包括写实、卡通和风格化人物。
  • 多场景适应性:在多种场景下生成高质量视频,包括不同的背景、光照条件和相机角度。

OmniHuman的技术原理

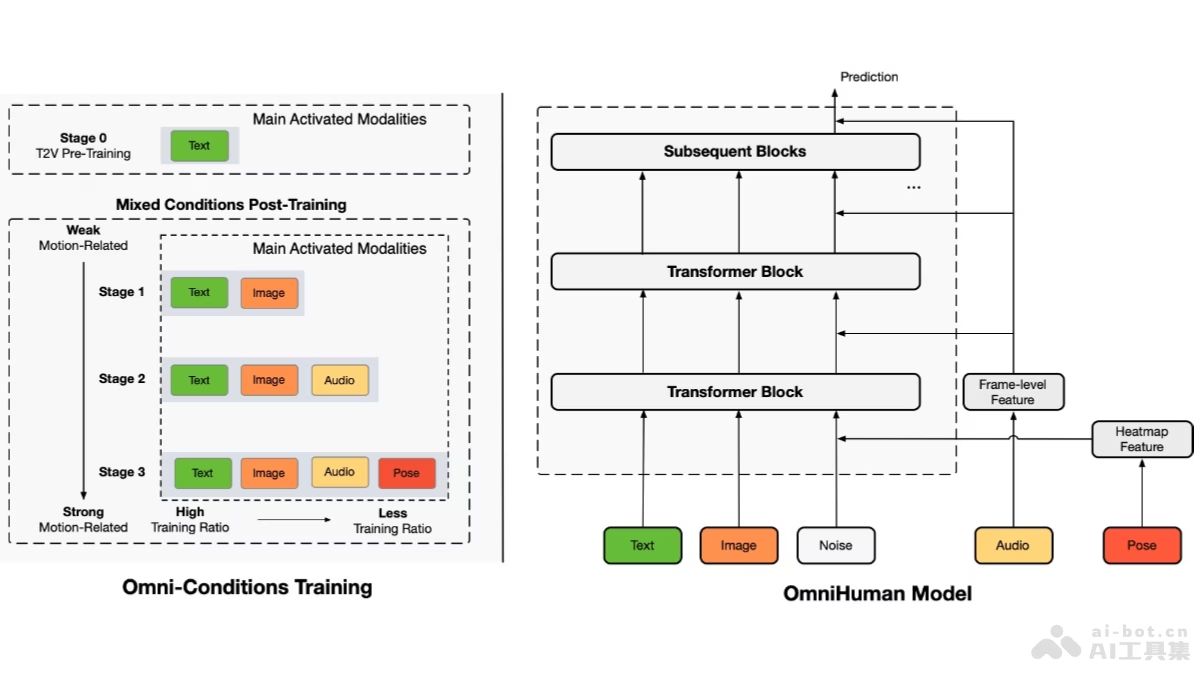
  • 混合条件训练策略:
    • 多条件融合:将文本、音频和姿势等多种运动相关条件混合到训练过程中,减少数据筛选导致的浪费,运用不同条件之间的互补性。
    • 分阶段训练:基于三阶段训练策略,逐步引入不同条件(文本、音频、姿势),根据条件的强弱调整训练比例,优化模型的泛化能力。
    • 训练原则:更强条件的任务用较弱条件的任务及其对应数据,扩展数据规模。条件越强,训练比例应越低,避免模型过度依赖强条件。
  • 扩散变换器架构:
    • 基于DiT的模型:OmniHuman 基于先进的视频生成模型架构DiT,用因果3DVAE(Causal 3DVAE)将视频投影到潜在空间,并基于流匹配(Flow Matching)作为训练目标。
    • 条件注入:
      • 音频条件:用wav2vec模型提取音频特征,将其与视频帧特征结合,生成音频令牌(tokens),基于交叉注意力机制注入到模型中。
      • 姿势条件:用姿势引导器(Pose Guider)处理姿势条件,将姿势热图特征与视频帧特征结合,生成姿势令牌(tokens),将其与噪声潜在表示一起输入模型。
      • 文本条件:保留DiT架构中的文本分支,用在描述生成视频的内容。
    • 参考条件处理:采用创新的参考条件策略,基于修改3D旋转位置嵌入(RoPE),将参考图像特征与视频特征融合,无需额外的网络模块。
    • 推理策略:
      • 分类器自由引导(CFG):在推理过程中,对音频和文本条件应用CFG策略,基于逐步降低CFG强度,平衡表达性和计算效率,减少生成视频中的瑕疵(如皱纹)。
      • 长视频生成:用上一个视频片段的最后几帧作为运动帧,确保长视频生成中的时间连贯性和身份一致性。

OmniHuman的项目地址

  • 项目官网:https://omnihuman-lab.github.io/
  • arXiv技术论文:https://arxiv.org/pdf/2502.01061

OmniHuman的应用场景

  • 影视与娱乐:生成虚拟角色动画、虚拟主播、音乐视频等,提升内容制作效率和视觉效果。
  • 游戏开发:为游戏角色和NPC生成自然动作,增强游戏沉浸感和互动性。
  • 教育与培训:创建虚拟教师、模拟训练视频,辅助语言学习和职业技能培训。
  • 广告与营销:生成个性化广告、品牌推广视频,提升用户参与度和内容吸引力。
  • 社交媒体与内容创作:帮助创作者快速生成高质量短视频,支持互动视频创作,增加内容趣味性
快手可灵2.1 AI视频模型重磅升级:更高效、更便宜,支持图生视频与文生视频
CogView3 – 智谱AI推出的开源AI图像生成模型
Mistral OCR 4 – Mistral AI 推出的最新一代文档理解模型
可灵2.0 – 快手推出的新一代AI视频生成模型
Kairos 3.0: 大晓机器人开源商业级世界模型,用物理AI加速具身智能落地
分享
Email 复制链接 打印
Share
上一篇 CogView-4 – 智谱AI推出的文本到图像生成模型 CogView-4 – 智谱AI推出的文本到图像生成模型
下一篇 HMA – MIT联合Meta等推出的机器人动作视频动态建模方法 HMA – MIT联合Meta等推出的机器人动作视频动态建模方法
发表评价

发表评价 取消回复

您的邮箱地址不会被公开。 必填项已用 * 标注

Please select a rating!

Ad image
- 入群领取知识星球折扣卷, 仅剩99份 -
Ad imageAd image

最近更新

量子芯片科技感占位特色图
告别JSON幻觉与死循环!阿里AgentScope开源Piccolo决策模型全家桶:Logits直出概率、递归自改进框架与SRE级Agent落地深度拆解
AI 工具
流光脑波AI大脑占位特色图
告别外挂补丁!高通定调2029商用6G:首创AI原生物理层、端边云全域算力协同与通感一体硬件架构全景深度拆解
最新趋势
量子芯片科技感占位特色图
99.96%准确率刷新鉴伪极限!Pangram重磅发布Image 1.0与Flash视频检测模型:热力图逐像素溯源与低清抗扰架构全景深度拆解
AI 工具
Google DeepMind发布Gemini Omni 1.2 Flash多模态视频生成与多轮对话编辑
单次15秒高清连贯、价格暴降30%!Google DeepMind发布Gemini Omni 1.2 Flash:多轮对话局部重绘与Arena霸榜全景拆解
AIGC 资讯

相关推荐

DeepSeek Artifacts – Hugging Face推出的AI编程工具,基于DeepSeek V3
AIGC 资讯

DeepSeek Artifacts – Hugging Face推出的AI编程工具,基于DeepSeek V3

站外新闻
CLaMP 3- 清华团队推出的音乐信息检索框架
AIGC 资讯

CLaMP 3- 清华团队推出的音乐信息检索框架

站外新闻
BAGEL – 字节跳动开源的多模态基础模型
AIGC 资讯

BAGEL – 字节跳动开源的多模态基础模型

站外新闻
Gemma 4 12B – 谷歌开源的多模态大模型
AIGC 资讯

Gemma 4 12B – 谷歌开源的多模态大模型

站外新闻
/ Prompt 语宙 /

Experience the limitless creative possibilities of generative AI and unlock new levels of innovation.

Quick Link

  • Remaker AI
  • BGRemaker 抠图Hot
  • AIGC 工具
  • Prompt 咒语生成器
  • 去水印工具

Support

  • Contact
  • Blog
  • Complaint
  • Advertise

标签

AIGC Midjourney prompt AI Agent GPT Image 2 openai 字节跳动 具身智能 多模态大模型 Anthropic AI绘画 EvoLink灵感 开源工具 开源大模型 开源模型 早报 大语言模型 MoE架构 AI智能体 腾讯混元 强化学习 AI视频生成 阿里通义 chatgpt 多模态AI DeepSeek Claude Code AI工具 开源框架 教程
Prompt 语宙Prompt 语宙
Follow US
© 2009-2026 Prompt 语宙. Paooo.com. All Rights Reserved.