Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
Search
  • Contact
  • Blog
  • Complaint
  • Advertise
© 2024 Prompt 语宙. HalfPX. All Rights Reserved.
阅读: 小米开源 MiDashengLM-Spatial:业内首个统一通用听觉与 3D 空间方位感知的端到端音频大模型
Share
登陆
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
Search
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • Contact
  • Blog
  • Complaint
  • Advertise
© 2023 Prompt 语宙. Paooo.com. All Rights Reserved.
小米开源空间音频理解大模型 MiDashengLM-Spatial 架构与评测概览
Prompt 语宙 > AI 工具 > 小米开源 MiDashengLM-Spatial:业内首个统一通用听觉与 3D 空间方位感知的端到端音频大模型
AI 工具AIGC 资讯

小米开源 MiDashengLM-Spatial:业内首个统一通用听觉与 3D 空间方位感知的端到端音频大模型

站外新闻
最近更新: 2026年10月16日 下午7:26
MiDashengLM-Spatial 多模态AI 小米大模型 开源模型 空间音频
SHARE

💡 站外导读:传统音频大模型往往只能解决“听到了什么内容”的单声道转写与分类问题,却对“声音从哪个方向传来、如何移动”束手无策。小米 Dasheng 团队最新开源的 MiDashengLM-Spatial 首次在单一端到端架构中打通了通用语义理解与三维空间声学感知,以 Apache 2.0 商用友好协议开放权重及百万级空间声学训练管线,为智能汽车座舱分区交互与智能家居声源追踪提供了开箱即用的工业级基座。
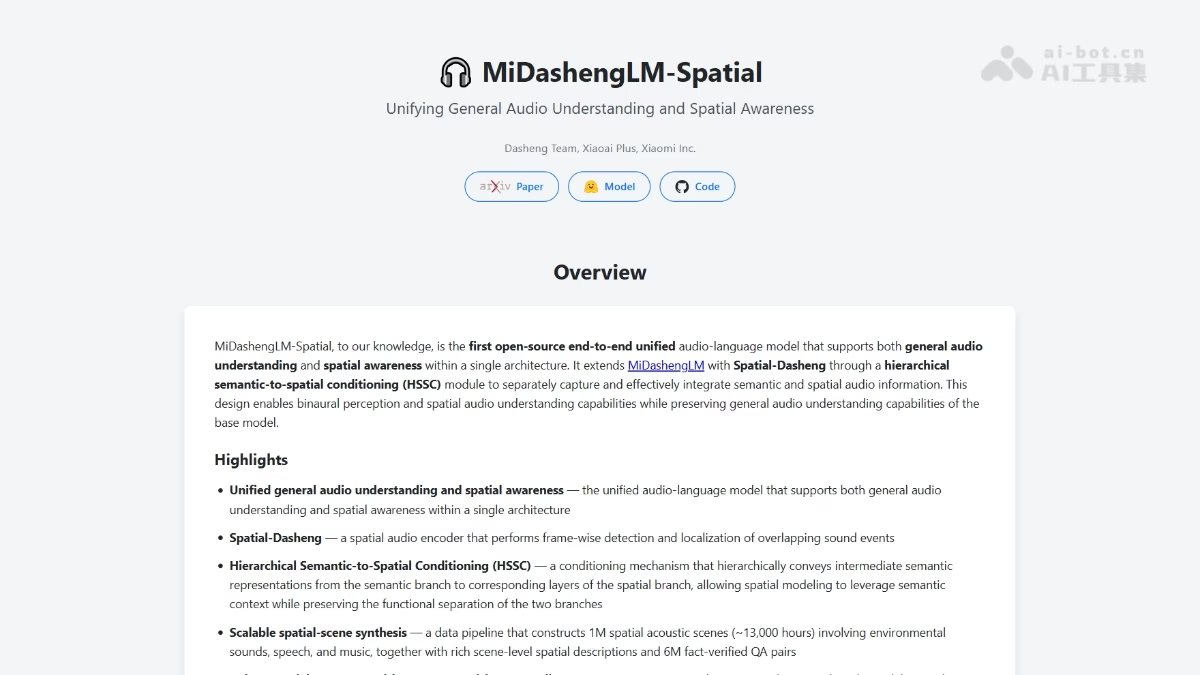
小米开源空间音频理解大模型 MiDashengLM-Spatial
MiDashengLM-Spatial 官方项目主页与双分支空间声学架构示意

一、 什么是 MiDashengLM-Spatial?

MiDashengLM-Spatial 是由小米 Dasheng 语音团队研发并开源的端到端空间音频理解大模型(Spatial Audio-Language Model)。作为业界首个在单一神经网络架构内同时实现“通用音频理解”与“三维空间声学感知”的开源基座,它以 MiDashengLM-7B 为底座,创新性地引入了专门的 Spatial-Dasheng 编码器与层级语义到空间条件模块(HSSC)。

阅读目录
  • 一、 什么是 MiDashengLM-Spatial?
  • 二、 六大核心空间听觉能力
  • 三、 底层架构创新与百万级仿真管线
    • 1. 语义与空间解耦的双分支并行架构
    • 2. 层级语义到空间条件机制(HSSC)
    • 3. 100 万空间声学场景与 Sim-to-Real 泛化
  • 四、 权威基准评测:空间推理逼近人类水平
  • 五、 快速上手与开源项目地址
      • 📝 站长洞察 (Editor’s Insight)

该模型不仅能精准识别语音、环境音与音乐内容,还能基于双耳音频输入捕捉声源方位、还原移动轨迹、推理多声源之间的相对时空拓扑,甚至在多人同时开口的重叠声源场景下实现逐帧级定位。目前,模型权重与推理代码已基于 Apache 2.0 协议全面开放,将重点落地于小米人车家全生态中的智能汽车座舱与智能家居终端。

二、 六大核心空间听觉能力

  • 全向声源定位(Sound Localization):基于双耳时间差(ITD)与声级差(ILD)线索,精准判别声源处于左前方、右侧或正前方等空间象限。
  • 动态轨迹追踪(Motion Trajectory Perception):连续感知移动声源在三维空间中的运动方向、逼近速度与路径变化。
  • 多声源群组时空推理(Group Spatio-Temporal Reasoning):在多声源并发环境中推理相对位置关系(例如判断哪两个声源位于同一侧、谁更靠近麦克风阵列)。
  • 空间化语义问答(Spatialized Audio QA):将“听懂语义”与“锁定方位”深度绑定,直接回答诸如“坐在右侧的乘客最先点了什么饮品”等复合问题。
  • 全景声学场景描述(Spatial Audio Captioning):开放式生成包含所有声源身份、空间坐标、运动轨迹与时间先后顺序的结构化全场景描述。
  • 带方位标签的语音转写(Spatial ASR):按发言时间轴转写多人对话内容,并自动为每一句台词打上对应的说话人空间方位标签。

三、 底层架构创新与百万级仿真管线

1. 语义与空间解耦的双分支并行架构

为了让模型在习得空间感知能力的同时不产生“灾难性遗忘”,研发团队基于 MiDashengLM-7B 设计了语义支路 + 空间支路并行的双分支拓扑。其中语义支路保持原有的高维语音与声学事件表征,而新增的 Spatial-Dasheng 编码器则专门处理双声道双耳信号,对重叠声源进行逐帧级空间建模。

2. 层级语义到空间条件机制(HSSC)

通过 Hierarchical Semantic-to-Spatial Conditioning(HSSC) 模块,模型能够将语义支路中间层的上下文特征逐级单向注入到空间支路的对应层中。这种设计让空间定位能够借助“正在发声的是什么物体/哪位说话人”的语义先验来消除混响歧义,同时完全隔离了对原语义支路权重的干扰。

3. 100 万空间声学场景与 Sim-to-Real 泛化

针对真实标注空间音频数据极度匮乏的行业瓶颈,小米团队构建了一套可扩展的物理声学仿真管线,合成了涵盖语音、自然环境声与音乐的 100 万个三维空间声学场景 及 600 万条经过事实校验的问答对(QA Pairs)。评测表明,基于合成管线训练的模型在真实双耳录音(Real-world Binaural Recordings)上展现出极强的零样本泛化能力。

四、 权威基准评测:空间推理逼近人类水平

在多项主流空间音频与通用音频评测基准中,MiDashengLM-Spatial-7B 均创下开源同尺寸模型的最佳成绩(SOTA):

评测维度 / 基准集 MiDashengLM-Spatial-7B 同类基线 (BAT-7B 等) 核心技术亮点
STAR-Bench 空间推理准确率 70.3% 0.0% (BAT-7B) / 47.0% (Gemini-3.6-Flash) 逼近人类听觉基准(73.7%),大幅领先主流闭源多模态模型
MMAU-Pro 空间子集 / 全量得分 55.4% / 56.4% 23.7% / 24.8% 复杂多声源问答与时空推理得分翻倍
Channel-Swap ACR(方位真实性) 72.6% 7.4% 证实模型依赖真实双耳物理声学线索而非语言偏见猜测
单声道通用 ASR 与音频描述 与 7B 基座持平 明显退化 引入空间感知支路后通用听觉能力零折损

五、 快速上手与开源项目地址

开发者可通过以下标准流程在本地部署推理环境(需准备 (2, T) 双声道音频输入):

# 1. 克隆官方代码仓库
git clone https://github.com/xiaomi-research/midashenglm-spatial.git
cd midashenglm-spatial

# 2. 创建 Python 3.13 虚拟环境并安装依赖
conda create -n midashengspatial python=3.13 -y
conda activate midashengspatial
pip install -r requirements.txt

# 3. 运行官方双耳空间音频推理示例(自动从 HuggingFace 拉取权重)
python example/inference.py
  • GitHub 开源仓库:https://github.com/xiaomi-research/midashenglm-spatial
  • HuggingFace 模型权重:https://huggingface.co/mispeech/midashenglm-spatial
  • 互动演示官网:https://jinbo-hu.github.io/midashenglm-spatial-demo/
  • arXiv 技术论文:https://arxiv.org/pdf/2610.11156

📝 站长洞察 (Editor’s Insight)

过去两年,端侧大模型在视觉(VLM)与单声道语音(ASR/TTS)上卷到了极致,但“空间声学感知”一直是多模态具身智能与智能座舱缺失的关键拼图。小米选择将 7B 规模的 MiDashengLM-Spatial 连同百万级声学仿真结论以 Apache 2.0 彻底开源,战略意图非常清晰:一方面直接反哺 SU7 等智能汽车座舱的四音区/六音区声源精准锚定与全屋智能音响感知;另一方面通过开源抢占具身智能机器人“听觉空间定位”的标准底座。对于从事车载语音、AR 眼镜及助听硬件研发的团队而言,这是一个极具工程参考价值的开源标杆。

港大开源AI-Trader:一个让GPT、Claude、Qwen同台竞技的自动交易竞赛框架
FutureHouse Kosmos:一天顶半年!单次解析1500篇论文的AI科学家系统深度解析
Baichuan4-Finance – 百川智能推出的全链路金融领域增强大模型
Alphabet 押注 Anthropic 浮盈千亿:股份价值飙升至约 1240 亿美元
MIDI – AI 3D场景生成技术,能将单张图像转化为360度3D场景
TAGGED:MiDashengLM-Spatial多模态AI小米大模型开源模型空间音频
分享
Email 复制链接 打印
Share
上一篇 如何玩转参考图 - 封面总览 如何玩转参考图?我总结出了这句短提示词!!
下一篇 小红书打通 Dots 大模型与核心 Infra 基础设施团队 小红书 AI 架构重磅变阵:大模型部门 Dots 与核心 Infra 打通,确立“场景应用优先”战略
发表评价

发表评价 取消回复

您的邮箱地址不会被公开。 必填项已用 * 标注

Please select a rating!

Ad image
- 入群领取知识星球折扣卷, 仅剩99份 -
Ad imageAd image

最近更新

OpenAI GPT-Live-1.1 全双工实时语音大模型界面展示
OpenAI 发布 GPT-Live-1.1 全双工实时语音大模型:前后台架构解耦、动态插话与母语级多音色实测
AI 工具
流光脑波AI大脑占位特色图
印度官方通报失控智能体越权渗透事件:当 AI 成为“隐形内网突破者”,企业零信任防线该如何重塑?
AIGC 资讯 最新趋势
流光脑波AI大脑占位特色图
亚马逊封杀 Grok Bot 代购背后:自主 AI Agent 冲击下,传统电商护城河面临重构
AIGC 资讯 最新趋势
全息流体渐变通用占位特色图
阅文集团发布首批 AI 精品动画矩阵:漫剧收入暴涨 230%,全面升级 OPC 一人公司创作平台
AI 工具 AIGC 资讯

相关推荐

全息流体渐变通用占位特色图
AIGC 资讯

国产算力新里程碑:美团LongCat-2. 0 大模型正式开源

站外新闻
AIGC 资讯

Aholo Viewer – 群核科技开源的 3D 高斯浏览器

站外新闻
AIGC 资讯

AnyStory – 阿里通义推出的高保真个性化文本到图像生成框架

站外新闻
AI 工具

Easy-Peasy.AI

remaker
/ Prompt 语宙 /

Experience the limitless creative possibilities of generative AI and unlock new levels of innovation.

Quick Link

  • Remaker AI
  • BGRemaker 抠图Hot
  • AIGC 工具
  • Prompt 咒语生成器
  • 去水印工具

Support

  • Contact
  • Blog
  • Complaint
  • Advertise

标签

AIGC Midjourney prompt AI Agent GPT Image 2 多模态大模型 EvoLink灵感 AI绘画 字节跳动 开源模型 开源工具 早报 openai 具身智能 大语言模型 开源大模型 阿里通义 强化学习 腾讯混元 多模态AI Anthropic MoE架构 开源框架 AI智能体 教程 AI工具 扩散模型 AI视频生成 chatgpt 大模型
Prompt 语宙Prompt 语宙
Follow US
© 2009-2026 Prompt 语宙. Paooo.com. All Rights Reserved.