

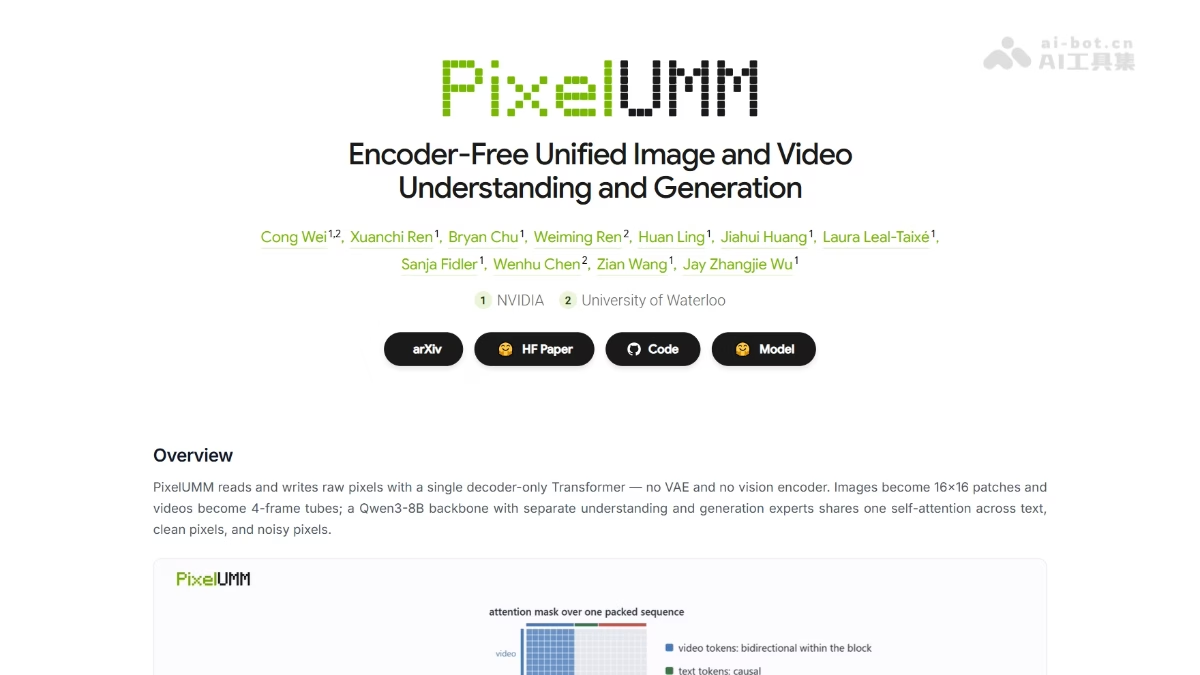
💡 站外导读:在大模型多模态浪潮中,主流文生图与生视频架构(如 Stable Diffusion、Sora、Wan 等)几乎无一例外依赖 VAE(变分自编码器)将像素压缩至潜空间(Latent Space),而视觉理解又依赖独立的 CLIP 或 SigLIP 编码器。这种“双重隔离”不仅带来了潜空间编解码的信息永久性损耗与细节伪影,更导致“生成”与“理解”被割裂为完全异构的双模型体系。NVIDIA 联合滑铁卢大学开源的 PixelUMM 带来了革命性的工程解答:彻底剔除 VAE 与视觉编码器,仅凭单一 Decoder-only 架构即可在原始像素空间中直接读写高画质图像与视频,并在同一自注意力矩阵中统一多模态理解与跨模态生成。
一、破除潜空间羁绊:为什么端到端“原始像素级读写”是多模态终局?
在传统的计算机视觉生成方案中,高维原始图像直接进入自注意力网络往往会引发严重的计算复杂度爆炸()。为了应对这一挑战,以 Latent Diffusion 为代表的技术流派引入了 VAE,将原始 RGB 像素压缩至低维潜空间(如 8× 或 16× 压缩)。然而,这种工程妥协伴随着极高的代价:
- 高频信息永久丢失:复杂的几何边缘、微小的代码文字与密集纹理在经过非线性下采样后不可逆地模糊,造成所谓的“AI 生图蜡质感与畸变”。
- 架构分裂与割裂的流水线:为了实现视觉理解,系统不得不外挂 SigLIP、CLIP 等预训练视觉编码器,使得“看懂图像”与“生成图像”位于完全不同的语义空间中,无法原生实现双向赋能。
PixelUMM 彻底打破了这一桎梏。 它完全移除了 VAE 与视觉编码器,将图像直接切分为 16×16 patch,将视频切分为 4 帧 tubelet(p16/t4),以原始 RGB 像素向量作为基础视觉单元输入网络。而在生成端,输出同样由极轻量的线性映射头直接回归像素值,实现了真正纯净、无压缩损耗的端到端像素级读写闭环。
二、解密 MoT 共享自注意力:理解专家与生成专家如何同频共振?
如何在同一个 Decoder 架构中既保持高精度的多模态推理理解,又具备强大的扩散去噪生成能力?PixelUMM 团队交出的答卷是 MoT(Mixture-of-Transformers) 架构:
- 核心基座与共享自注意力:PixelUMM 选用经过海量优质语料淬炼的 Qwen3-8B 作为骨干网络。理解分支(Understanding Expert)与生成分支(Generation Expert)各自拥有独立的前馈神经网络(FFN),但物理共享同一套 Self-Attention 注意力矩阵。
- 同一注意力空间的语义交融:这意味着提示词文本 Token、未加噪的干净视觉条件 Token(Clean Pixels)以及待去噪生成的扩散潜变量 Token(Noisy Pixels)能在同一个注意力矩阵中直接计算关联度,实现了上下文的多模态无缝交融。
- 像素空间的 Flow-Matching 扩散训练:在生成任务上,团队采用了流匹配(Flow-Matching)训练算法。经过严密的物理消融对比实验,研究人员证实:在原始像素空间进行扩散训练的梯度范数与在 VAE 潜空间几乎完全一致,而且像素空间由于省去了复杂的反向传播编解码链条,训练过程更加平稳,收敛特性极为健康。
三、六大核心全模态能力:文生图、文生视频、图生视频与高精度视觉理解实测
得益于 Encoder-Free 的轻量统一设计,PixelUMM 在单一权重下全面覆盖了全生命周期的多模态处理能力:
- 高质量文本生视频(T2V):支持生成最高 832×464 分辨率、96 帧、24fps 的 4 秒连贯视频,动态物理规律与色彩保真度完全比肩同等体量的主流潜空间视频扩散模型。
- 文本生图像(T2I):无需额外的扩散分支或外置图像生成头,在单一网络前向流中直接生成原生高分辨率图片。
- 图生视频(I2V)与视频编辑:将用户输入的干净参考图或待编辑视频帧直接送入“理解专家”提取精准条件特征,待生成的噪声帧走“生成专家”,在共享自注意力中实现零延迟、高保真的条件引导,在四项主流视频基准评测中提升高达 0.89~3.49 分。
- 21 项通用多模态理解(VLM):在 VQA、图表深度理解、工业 OCR 等 21 项视觉理解基准中,达到 8B 级独立 VLM 的平均顶尖水准,并在结构化图表问答(ChartQA 达到 82.96)与细粒度计数(CountBench 斩获 94.30)上展现出压倒性优势。
四、PixelUMM 对决字节跳动 BAGEL:无编码器 vs 传统 Latent 架构深度对比
为了直观评估 PixelUMM 在前沿多模态阵营中的工程定位,我们将 PixelUMM 与字节跳动近期开源的知名统一多模态模型 BAGEL 进行全维度横向比对:
| 对比维度 | PixelUMM(NVIDIA × 滑铁卢大学) | BAGEL(字节跳动) |
|---|---|---|
| 核心架构哲学 | Encoder-Free:彻底移除 VAE 与视觉编码器,像素级端到端直读直写 | Encoder-Based:基于 Wan 系 VAE + SigLIP 编码器,依赖潜空间扩散 |
| 骨干网络 (Backbone) | Qwen3-8B | Qwen2.5-7B-Instruct |
| 总参数量与激活机制 | 15.2B(MoT 架构,稠密激活) | 14B MoE(每 Token 激活约 7B) |
| 视觉 Token 化方案 | 图像 16×16 Patch / 视频 4 帧 Tubelet (p16/t4) 原始 RGB 直接映射 | VAE 降维压缩至 Latent 特征后再进行 Patchify 投影 |
| 生成端输出头 | 轻量线性投影头(仅 12.6M 参数)或 PixelShuffle 头 | 重量级 VAE 解码器逆向还原像素 |
| 图表问答 (ChartQA) | 82.96(像素直读优势明显) | 78.50 |
| 细粒度计数 (CountBench) | 94.30(细部未被压缩抹平) | 82.50 |
| 综合多模态理解 (MMMU) | 41.67 | 55.30(SigLIP 预训练特征底蕴更强) |
五、工程部署与本地推理快速上手指南
PixelUMM 官方代码库与模型权重已在 GitHub 和 Hugging Face 完整开放。遵循以下标准 SRE 流程即可在单节点多卡环境下快速拉起推理服务:
# 1. 克隆代码仓库并配置 Python/CUDA 运行环境
git clone https://github.com/nv-tlabs/PixelUMM.git
cd PixelUMM
pip install -r requirements.txt

# 2. 从 Hugging Face 下载 PixelUMM S8-F22 预训练检查点与 Qwen3-8B 分词器
export PIXELUMM_CKPT="/path/to/checkpoints/S8-F22-R05"
export PIXELUMM_QWEN_DIR="/path/to/qwen3-8b-dir"
export PIXELUMM_OUTPUT="./outputs"

# 3. 运行模型权重物理兼容性核验
python check_checkpoint.py

# 4. 执行文生视频 (T2V) 推理任务
python inference.py \
  --task t2v \
  --prompt "A cinematic drone shot of a futuristic cyberpunk harbor at dusk, 4k ultra-detailed" \
  --height 464 --width 832 --num_frames 96 --fps 24
📝 站长洞察 (Editor’s Insight)
从计算机视觉技术演进史来看,PixelUMM 标志着多模态架构正在完成从“拼装异构时代”向“原生统一时代”的关键跃迁。过去三年,社区为了规避原始像素高维空间的计算爆炸,普遍妥协于 VAE 的潜空间降维。然而,随着注意力机制的优化与硬件算力密度的提升,潜空间在几何边缘、微小文本 OCR 以及高频动态纹理上的“模糊糊弄”日益成为生成质量的硬天花板。PixelUMM 证明了原始像素空间的 Flow Matching 不仅在梯度范数上与 VAE 空间高度一致,甚至由于去除了非线性编解码映射而具备更高的训练稳定性。尽管当前采用轻量线性头在局部可能偶现细微网格,但配合时间优先的 PixelShuffle 即可完美抹平。更深远的意义在于:当单一 Transformer 同时读写像素与文本,多模态智能体真正拥有了类似人类视觉皮层的直觉反应能力,这是未来构建全自洽具身智能与交互式世界模型的奠基之作。


