

💡 站外导读:在 GitHub Copilot、Cursor 以及各类代码大模型群雄逐鹿的当下,传统开发工具巨头 JetBrains 给出了极其犀利的工程回击:开源面向智能体编程(Coding Agent)的专用 MoE 模型 Mellum2.1。长期以来,通用大模型虽然通晓天文地理,但在复杂代码工程中往往面临“幻觉修 Bug、代码补全延迟高、高并发吞吐受限以及企业数据隐私外泄”等顽疾。Mellum2.1 创新性地将数百万次真实沙盒环境强化学习(RL)作为训练核心主体,辅以 12B 总参数/仅 2.5B 激活的精巧 MoE 架构与原生 MTP 投机加速,不仅在单卡 H200 上跑出两倍于同级稠密模型的极致吞吐,更实现了真正的本地闭环自主探库与精准修复。
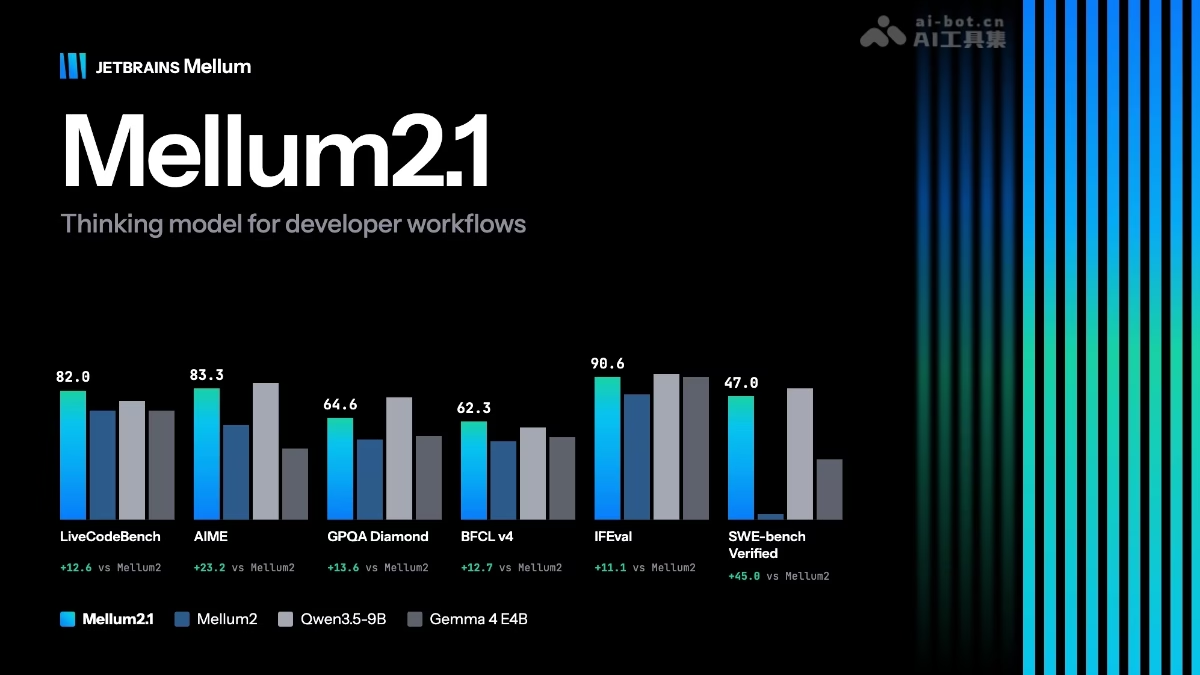
一、从“代码补全”到“全流程自主探库”:JetBrains 编程智能体的代际进化
在日常软件工程开发中,开发者真正需要的不仅仅是一个能够“猜出下一行代码”的补全工具,而是一个具备全仓库上下文理解、能定位单测失败根因并完成端到端修复的虚拟工程搭档。早期的 Mellum2 虽然在补全延迟上表现优异,但面对复杂仓库的跨文件依赖与构建报错时依然力不从心。
Mellum2.1 实现了根本性的定位跃迁。 它被专门训练用于执行高难度智能体编程任务:
- 自动化探索代码库:自主搜索函数定义、追踪调用链拓扑,理解大型单体架构或微服务工程结构。
- 精准编辑与自查修改:在修改业务逻辑后,主动检查关联语法与类型错误,甚至能自主执行单元测试,根据失败堆栈回溯定位 Bug 根因并重新起草修复补丁。
- 企业级私有化数据安全:针对金融、军工及头部大厂严苛的数据出境合规要求,Mellum2.1 完全支持在企业自建集群本地部署,确保核心代码库和业务数据 100% 物理留存内网。
二、架构解密:12B MoE 低激活设计与 MTP 预测的吞吐奇迹
在企业级自托管与 IDE 插件高频调用的严苛 SLA 约束下,推理延迟和并发吞吐直接决定了工具的生与死。Mellum2.1 在模型底层采用了两大硬核性能加速黑科技:
- 12B 总参数 / 仅 2.5B 激活的 MoE 专家网络:Mellum2.1 拥有 12B 参数的宽广模型容量,但在每一次前向推理时,动态路由机制仅精准激活其中的 2.5B 参数。这种设计在维持庞大知识容量的同时,将计算算力与显存带宽消耗降低了 80% 以上。
- 原生多 Token 预测(MTP,Multi-Token Prediction):传统自回归模型单次前向只能输出 1 个 Token,而 Mellum2.1 在底层网络中内置了 MTP 头,能在单次计算中推断多个后续 Token。实测表明,在单并发请求下代码生成速度直接提升 1.6 倍;而在高负载并发场景下,Mellum2.1 的吞吐量直接逼近行业主流标杆 Qwen3.5-9B 的近两倍。
三、强化学习成为训练主体:数百万真实沙盒如何锻造“不胡说”的工程直觉
以往大模型的训练范式往往是“预训练为主,SFT 调优,最后通过极简的 RLHF 走个过场”。这种流水线导致模型在代码领域经常产生“语法看似正确、实测一跑就崩”的幻觉。Mellum2.1 在业内率先颠覆了这一范式:将强化学习(RL)从收尾环节扩展为整个训练阶段的核心主体。
为了给模型提供真正无偏且严密的强化学习信号,JetBrains 团队打造了专属的自动化沙盒矩阵基础设施:
- 数百万沙盒与千套真实工程环境:在训练生命周期内动态启动数百万个隔离容器,覆盖 C++、Java、Kotlin、Python、Go、Rust、TypeScript 等多语言主流构建工具链与单测框架。
- 严格的数据过滤与无死角验证:在数据入库前剔除所有存在测试缺陷、依赖不全或不可验证的开源项目,确保模型接收到的每一个奖励(Reward)信号都来自于物理编译器与测试套件的真实反馈。
- 试错驱动的工程直觉进化:模型在数百万次与沙盒环境的攻防对抗中,习得了真正的软件工程推断能力——当遇到构建报错时,它学会的不是胡乱重写,而是查阅依赖版本与环境配置。
四、Mellum2.1 对决阿里 Qwen3.5-9B:专业编程智能体 vs 通用基座全面对比
作为当今开发者最为关注的开源代码中坚力量,我们将 Mellum2.1 与阿里巴巴开源的同级别明星模型 Qwen3.5-9B 进行深度指标对比:
| 核心指标 | Mellum2.1(JetBrains) | Qwen3.5-9B(阿里通义) |
|---|---|---|
| 基础架构模式 | 12B 稀疏混合专家 (MoE),单 Token 激活 2.5B | 9B 稠密 (Dense) 传统架构,每次全参数激活 |
| 核心定位与特长 | 代码库级自主探索、编辑自查、单测闭环修复、企业内网部署 | 通用语言大模型,兼具数学与基础代码能力 |
| 强化学习训练机制 | 数百万真实沙盒容器 RL 训练,真实编译器信号驱动 | 常规大规模预训练 + 奖励模型偏好对齐 (DPO/PPO) |
| 推理吞吐量表现 | 高负载吞吐逼近 Qwen3.5-9B 两倍,单卡支持更高并发数 | 基准吞吐水平,稠密参数受显存带宽制约明显 |
| 投机加速支持 | 内置 MTP(多 Token 预测),单请求速度提升 1.6 倍 | 需外接第三方投机解码模型,原生未内置 |
| 原生工具集成 | 针对 IntelliJ / PyCharm 等 IDE 内部协议及 MCP 深度定制 | 通用 Function Calling / OpenAI 兼容接口 |
五、企业级私有化部署与生产实践指南
Mellum2.1 现已在 Hugging Face 官方仓库(JetBrains/Mellum2.1-12B-A2.5B-Thinking)开源。在生产环境中,推荐使用 vLLM 进行高吞吐部署,并开启 131K 极限长上下文以支持超大仓库解析:
# 1. 使用 vLLM 快速拉起兼容 OpenAI 规范的 Mellum2.1 服务
python3 -m vllm.entrypoints.openai.api_server \
  --model JetBrains/Mellum2.1-12B-A2.5B-Thinking \
  --tensor-parallel-size 1 \
  --max-model-len 131072 \
  --trust-remote-code \
  --port 8000

# 2. 通过标准 API 发起复杂仓库 Bug 定位与修复任务
curl -X POST http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "JetBrains/Mellum2.1-12B-A2.5B-Thinking",
    "messages": [
      {
        "role": "user",
        "content": "分析以下 pytest 失败堆栈,定位订单并发扣款异常的原因并输出符合仓库规范的修复补丁..."
      }
    ],
    "temperature": 0.2
  }'
📝 站长洞察 (Editor’s Insight)
JetBrains 开源 Mellum2.1 标志着 AI 编程赛道正式从“拼参数体量的蛮力时代”进入到“拼真实工程场景理解密度的深水区”。过去两年,很多团队试图直接使用 70B 甚至超大闭源模型作为 IDE 辅助,但在实际生产场景中,超过 500ms 的补全延迟就会彻底打断程序员的心流,而高昂的 API 调用成本与代码越境出海的合规风险更让企业望而却步。JetBrains 作为拥有 20 多年 IDE 底层研发经验的老牌巨头,其最大的工程护城河在于对“代码语法树(AST)、调用图依赖与真实编译报错”的深刻理解。Mellum2.1 巧妙地通过 MoE 将推理活跃参数压至 2.5B,配合 MTP 技术把推理延迟压缩到极致,同时通过数百万真实沙盒强化学习训练出精准的“自主查错与重构能力”。这不仅是给开源社区的一份厚礼,更为希望在内网低成本部署高可靠 Coding Agent 的企业团队提供了绝佳的工业级范式。


