

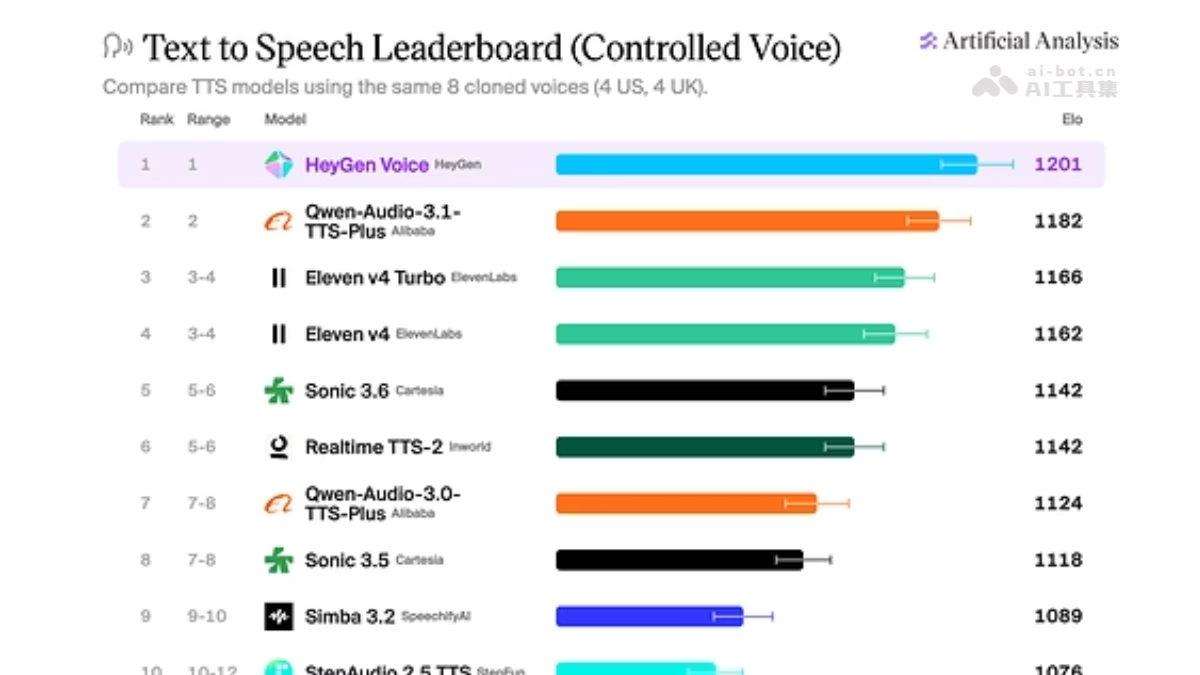
💡 站外导读:在 AI 数字人视频生成领域,即便画面分辨率高达 4K,如果声音带有机械的“朗读腔”、缺乏真人自然的呼吸停顿与情绪起伏,甚至声音与唇形动画出现哪怕 50 毫秒的微小割裂,用户的沉浸感就会瞬间崩塌。作为全球 AI 数字人领跑者,HeyGen 近日正式推出了自研端到端语音大模型 HeyGen Voice,并在权威第三方评测机构 Artificial Analysis 的 TTS Controlled Voice 榜单中强势登顶。该模型最核心的工程突破在于将语音生成与视觉身份模型 Avatar V 统一在同一技术栈中,彻底告别了拼接外部 TTS 供应商的传统拼装模式,并通过首创的双参数解耦控制机制,让数字人真正具备真人的韵律灵魂与丰沛情感。
一、终结“拼装式数字人”的致命硬伤:为什么音视频必须同源端到端?
在当前市面上的绝大多数数字人解决方案中,技术链路通常由三个各自为战的异构模块拼装而成:
- 上游大语言模型(LLM)负责撰写文本脚本;
- 中游第三方 TTS 供应商(如 ElevenLabs、Azure Speech)负责合成音频波形;
- 下游唇形驱动模型(如 Wav2Lip、SadTalker)提取音频能量,强行修改脸部肌肉变形。
这种多阶段串行流水线存在着致命的“上下文信息级联丢失”:中游 TTS 根本不知道数字人此刻的肢体姿态与视线方向,下游唇形模型也只能对着波形机械对口型,导致数字人常常在激烈演讲时面无表情,或者在轻声低语时嘴巴大张。HeyGen Voice 从根源上颠覆了这一现状——它与 HeyGen 核心数字人模型 Avatar V 诞生于完全相同的统一技术底座。 声音与面部身份、微表情、唇动时序由同一大模型端到端联合预测,在潜空间内完成了视听物理规律的原生对齐,彻底终结了“音画脱节”的历史难题。
二、同源 Avatar V 架构与独创双参数解耦控制机制
为了让数字人演绎脚本时既能“像本人”,又能具备极佳的戏剧张力,HeyGen Voice 创新性地引入了声音相似度(Similarity)与表现力增强(Expressiveness Boost)双参数物理级解耦机制:
- 解决“越像本人越平淡”的行业魔咒:在以往的声音克隆技术中,为了提高与原说话人的声音相似度,模型往往被迫拟合原音频的静态频谱分布,导致生成长篇台词时语气死板、缺乏抑扬顿挫;而一旦调高表现力,音色又极易发生漂移,变成另一个人。
- 解耦双控制旋钮:HeyGen Voice 将特征提取分为说话人固有音色特征向量与动态情感语调流两个独立可微调通道。在 HeyGen Studio 中,推荐的生产级配置为
similarity: max叠加expressiveness_boost: 0.5,既能 100% 锁死本人的音色指纹,又能自适应根据脚本语义加入叹息、重音、疑问上扬与停顿换气,真正消除了生硬的“机械朗读感”。
三、双轨克隆体系与企业级安全合规治理
针对不同层级的应用场景与算力预算,HeyGen Voice 设立了清晰的即时与专业双轨交付路径:
- 秒级即时克隆(Instant Clone):仅需提取用户一段录音的前 3 分钟素材,即可在数秒内构建音色特征图谱,直接通过原生 TTS 端点输出多语言语音,适合个人创作者快速产出社媒短视频。
- 专业高保真声音训练(Professional Clone):面向企业高管、专业讲师与品牌代言人,需经过严格的人脸活体与声音授权认证,上传 20 分钟至 3 小时多场景专业录音。系统将为其微调专属音色权重,并开放
speed(语速)、pitch(音调)、seed(随机种子)等细粒度声学底层调控能力,支持全生命周期在线增量重训。
四、HeyGen Voice 对决微软 MAI-Voice-2:前沿语音模型综合硬核对照
我们将 HeyGen Voice 与微软最新开源的语音模型 MAI-Voice-2 进行全维度工程技术对照:
| 评测维度 | HeyGen Voice(HeyGen 自研) | MAI-Voice-2(微软) |
|---|---|---|
| 第三方权威榜单 | Artificial Analysis TTS 榜 Controlled Voice 子榜 #1 | 内部盲测 72.1% 优于前代,尚未入围公开权威榜单前列 |
| 视听端到端协同 | 与 Avatar V 同源原生技术栈,音色与微表情潜空间联合对齐 | 纯音频独立模型,外接数字人时需依赖外部唇形对齐算法 |
| 情感与拟真度控制 | 独创 similarity + expressiveness_boost 双维度解耦调优 | 显式离散情感标签驱动(悲伤、耳语、兴奋、困惑等) |
| 声音克隆形态 | 即时克隆 (3分钟快速建档) + 专业克隆 (20分钟+ 权重微调) | 零样本小样本克隆 (5~60秒),无需模型微调 |
| 企业落地成本 | HeyGen 平台及官方 API 全量免费开放基础调用 | 依赖 Azure 专用算力实例按字符计费 |
五、企业出海与全球化音视频内容生产实战
HeyGen Voice 的全量开放彻底改写了跨国企业的内容生产成本结构。企业只需通过标准 API 即可将本地化视频制作周期从几周压缩至数分钟:
# 1. 调用 HeyGen Voice 原生端点合成多情感高保真语音
curl -X POST https://api.heygen.com/v3/models/audio/tts \
  -H "X-Api-Key: $HEYGEN_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "voice_id": "usr_voice_custom_professional_0921",
    "text": "Hello global partners! Today we are introducing our breakthrough Q4 enterprise roadmap.",
    "similarity": "max",
    "expressiveness_boost": 0.5,
    "speed": 1.05
  }'
📝 站长洞察 (Editor’s Insight)
HeyGen Voice 的发布不仅是 HeyGen 构筑自身商业护城河的关键一役,更指明了具身智能与数字人视听交互的未来演进方向。在生成式 AI 的上半场,大多数产品依靠“组合拼接”起家:前段接入外部 LLM,中段挂接第三方 TTS 引擎,后段跑开源唇形同步模型。这种“三段式外挂”架构虽然上线快,但在严肃商业交付中极易遭遇灾难性的质量坍塌——外部 TTS 的音量起伏、节奏突变与中英文夹杂往往会导致唇形模型抽搐变形。HeyGen 选择在底层重构整个技术栈,将音视频生成彻底同源化,用一个模型同时理解语意、生成语音韵律并驱动面部微表情。这种端到端的全栈自研不仅将口型与音色的时间轴误差消除在潜空间之内,更为长文本播客、沉浸式教育和企业品牌出海提供了无可挑剔的真实度保障。


