

💡 站外导读:在智能驾驶算法从“多传感器规则堆叠+多任务小模型组合”全面迈向“端到端多模态大模型”的技术分水岭上,传统车载芯片面临着前所未有的架构瓶颈:计算核间通信时延高、大模型算子支持低效、内存带宽被 Transformer 频繁打满。2026年10月29日,新芯航途(XHEART)正式推出全新一代智驾大模型专用芯片 X7 Ultra,提出颠覆性的“大模型定义芯片”研发范式,以 700 TOPS 的强劲算力、国内首发量产 Armv9 车规级 CPU 以及 98.7% 的极致计算利用率,为端到端智驾规模化落地铺平了硬件底座。本文为你全面拆解其技术架构与产业破局点。
一、范式转移:为什么端到端智驾必须由“大模型定义芯片”?
在智能驾驶发展的上半场,业界普遍采用“感知、预测、决策、规划”模块化级联的架构。在这一时期,芯片设计厂商只需在 SoC 中堆叠大量通用计算核心和针对卷积神经网络(CNN)优化的硬件加速单元,便能满足多路摄像头目标检测与激光雷达点云分割的计算需求。然而,随着以 Transformer 为底座的“端到端多模态大模型(End-to-End Foundation Model)”成为自动驾驶行业的绝对演进主线,传感器原始数据直接输入、车辆运动轨迹端到端输出的新范式,对底层车载算力平台提出了颠覆性的重构要求。
传统的车载计算芯片在应对端到端大模型时正遭遇严重的“水土不服”:
- 核间通信墙(Communication Wall):传统多核 NPU 采用离散小核拼装架构,在处理数十亿参数的复杂注意力机制时,大量计算耗费在跨核数据搬运与内存等待上,实际算力利用率往往暴跌至 30% 以下。
- 带宽饥渴症(Memory Bandwidth Wall):Transformer 架构中频繁出现的跨层张量读写与非线性激活,极易使车载 DDR/LPDDR 内存总线发生拥塞,导致芯片发热量飙升却输出迟缓。
- 浮点精度与对齐漂移:端到端大模型对于权重和激活值的精度极其敏感,传统低比特量化极易导致长时程轨迹规划出现“虚幻漂移”或突发异常减速。
正是在这一行业严峻挑战下,新芯航途(XHEART)在芯片立项之初便确立了“大模型定义芯片”的工程路线:不再沿用先堆硬件规格再让算法迁就的旧模式,而是从真实车载量产大模型的物理计算拓扑出发,倒推计算架构、片上存储层次与片内数据流转通道,从而诞生了 X7 Ultra 这一专为端到端大模型量身定制的车载计算底座。
二、硬核微架构拆解:TB/s 级超大核 NPU 与高并发多级缓存
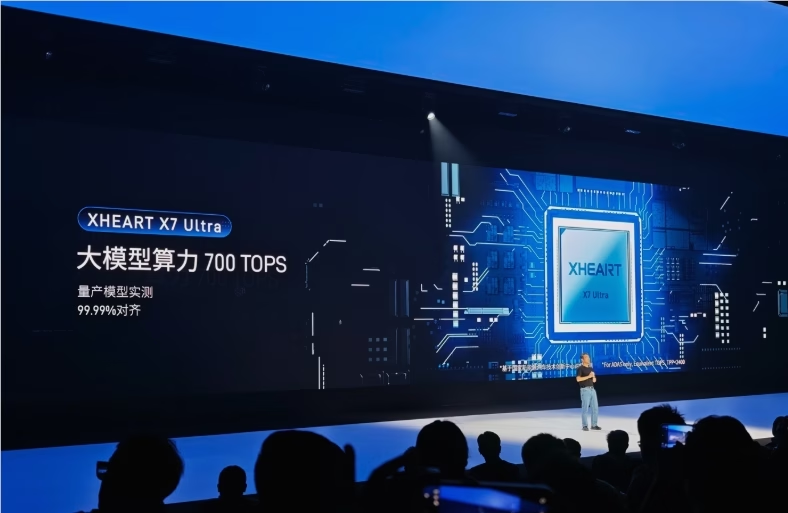
在核心算力指标上,X7 Ultra 实现了 700 TOPS 的大模型等效算力,更为难得的是,其在主流商业量产端到端大模型上的实测精度对齐度高达 99.99%,几乎完全消除了模型部署至端侧硬件时的精度衰减。
实现这一突破的核心支柱在于其颠覆性的 “超大核(Mega-Core)NPU 架构”:
- 核内极速数据交互:不同于传统芯片将算力分散在多个弱小核并通过复杂片上网络(NoC)通信的设计,X7 Ultra 采用了高度集成的超大计算核设计。计算单元在统一的物理核内紧密互联,将原本高延迟的核间数据交互彻底转变为核内超宽总线传输,实现了 TB/s(太字节每秒)量级的物理吞吐速率。
- 低时延高并发多级缓存:为了彻底根除“访存等待”,X7 Ultra 构建了兼顾超大物理容量与高并发吞吐的多级片上缓存(Multi-Level On-Chip Cache)体系。大模型前向推理中的中间特征图与注意力矩阵可长时间驻留片内高速缓存,大幅削减了对外挂 DRAM 的频繁访问,显著压降了整车端到端推理时延与动态运行功耗。
| 对比维度 | 传统多核拼接车载 SoC | 新芯航途 X7 Ultra (端到端原生) |
|---|---|---|
| 架构设计哲学 | 芯片规格驱动算法(先做芯片,再适配算法) | 大模型定义芯片(算法拓扑倒推芯片架构) |
| NPU 物理拓扑 | 多个离散小核,受制于 NoC 路由与仲裁时延 | 一体化超大核 NPU,TB/s 级核内总线互联 |
| 算力硬件利用率 | 通常仅在 25% ~ 40% 之间 | 实测高达 98.7% |
| 内存带宽消耗 | 基准值(频繁发生总线打满与内存争抢) | 大幅削减 80% 内存带宽占用 |
| Transformer 算子加速 | 依赖通用矢量单元模拟,效率低下 | 硬化专用引擎加速 Layernorm/Softmax/Transpose |
| CPU 核心架构 | 上一代 Armv8 / Cortex-A78 系列 (NEON 引擎) | 国内首发量产 Armv9 车规 CPU + SVE2 向量引擎 |
三、算子级硬件加速:98.7% 算力利用率与内存带宽骤降 80%
在端到端 Transformer 模型的运算流水线中,并非所有算力开销都集中在传统的矩阵乘法(GEMM)上,诸如 Layernorm(层归一化)、Softmax(指数归一化)以及 Transpose(张量转置与重排)等高频非线性算子往往构成了隐藏的性能黑洞。
针对这一痛点,X7 Ultra 在硬件硅片层面直接集成了高精度大模型专用算子加速引擎:
- 硬化非线性运算加速:针对注意力机制中的 Softmax 与 Layernorm 算子进行微指令级硬件硬化,消除通用指令循环开销,单算子处理延迟压降数倍以上。
- 张量零开销转置:在片内数据通路中直接融合硬件转置流水线,张量维度变换与内存连续化操作在数据写入时即可同步完成,不再额外挤占通用计算核心周期。
- 原生 FP16 / FP32 混合精度支持:提供原生的单精度与半精度浮点向量计算能力,确保在极其苛刻的高动态感知与控制决策时,不因低比特截断而产生安全隐患。
在这套全方位算子加速矩阵的赋能下,X7 Ultra 实现了令业界瞩目的工程成果:NPU 物理并行度被全额释放,硬件计算利用率高达 98.7%;相较于行业现役旗舰车载计算芯片,其外部内存带宽消耗暴跌 80%,整机运行能效实现了 100% 的翻倍提升。
四、国内首发量产 Armv9 车规级 CPU:SVE2 向量引擎赋能高精时空协同
除了作为核心主力的 NPU 突破外,端到端自动驾驶系统仍需要强劲的通用 CPU 集群来承担底盘安全监控、高精度定位融合、轨迹安全检查器(Safety Checker)以及多传感器时空同步等关键通用逻辑。
新芯航途 X7 Ultra 在国内率先实现了 Armv9 车规级 CPU 的规模化量产首发,带来了一系列具有划时代意义的底层升级:
- 能效与性能全面跃迁:得益于先进的 Armv9 架构与底层流水线优化,CPU 实现了 20% 的通用性能跃升以及 10% 的能效比改善。
- 升级大集群高吞吐架构:全面重构多核协同调度与 L3 缓存共享机制,显著增强了多核高并发下的访存带宽与跨核同步性能,为高频时钟同步与异构计算协同打下坚实支撑。
- 集成全新 SVE2 矢量处理引擎:彻底淘汰了上一代落后的 NEON 扩展,集成了第二代可扩展向量扩展(SVE2)。SVE2 在雷达数字信号处理(DSP)、激光雷达坐标点云变换与非结构化数据清洗任务中,展现出数倍于传统架构的并行吞吐性能。
随着 X7 Ultra 芯片的正式量产发布,中国智能驾驶计算平台正彻底摆脱对海外通用公版算力的被动跟随,以“专用架构定义大模型端侧算力”的新范式,开启高阶自动驾驶全面普及的新篇章。
📝 站长洞察 (Editor’s Insight)
从特斯拉 FSD V12 到国内蔚小理华等智驾头部梯队,汽车产业已经彻底达成了“端到端多模态大模型是通向完全自动驾驶唯一生门”的共识。然而,过去几年业界采购的主流车载芯片,本质上仍是为传统 CNN 卷积网络和规则级几何算法设计的通用产物。面对动辄数亿至数十亿参数的 Transformer 神经网络,传统架构在端侧推理时频繁遭遇核间通信阻塞和显存带宽瓶颈,往往出现“标称算力 1000TOPS,实际算力利用率不足 30%、功耗与发热却持续拉满”的巨大脱节。新芯航途 X7 Ultra 的正式亮相,标志着车载芯片真正跨入了以真实生产模型为导向的“专芯专用”时代。通过在硬件硅片上原生集成 Layernorm/Softmax 专用算子引擎、重构 TB/s 级核内总线,并国内首发量产 Armv9 车规 CPU,它以高达 98.7% 的计算利用率和带宽消耗降 80% 的实测数据,给出了大模型端侧落地的硬核工程解法。这一突破不仅极具工业量产降本价值,更为全球智驾产业链由“拼算力参数数字”转向“拼有效大模型工时与架构效率”树立了全新标杆。


