

💡 站外导读:在人工智能从单纯的文字逻辑理解向物理世界与具身智能渗透的浪潮中,大模型的“原生多模态”与“长程智能体工程能力”已成为最核心的胜负手。美团最新发布的万亿级多模态旗舰大模型 LongCat-2.5,凭借总参数量达 1.6 万亿(推理时仅激活 480 亿参数)的精妙 MoE 设计,在权威基准评测 AutomationBench 与 BrowseComp 中强势斩获全球第一。该模型在离散视觉 Token 联合表征、超长程强化学习探索,以及国产算力深度适配三大技术维度上实现了重大工程突破。
一、算力架构与参数规模:1.6 万亿 MoE 架构的能效极致
在底层模型参数体系设计上,LongCat-2.5 采用了稀疏混合专家(MoE)架构,模型总参数量高达 1.6 万亿(1.6T)。但在每次进行 Token 前向推理时,系统会自适应动态路由并仅激活约 480 亿(48B) 参数。
这种“大容量、小激活”的架构设计,不仅保留了万亿参数巨模型所独有的复杂逻辑抽象与跨领域知识储备,更将单 Token 推理的时延与计算成本压制在可大规模商用的工程边界之内,兼顾了顶级智能与极致工程效率。
二、三大核心技术突破:原生视觉 Token 与长程强化学习
1. 创新多层级离散视觉 Token(Multi-level Discrete Visual Tokens)
以往的多模态模型普遍采用“视觉编码器(如 CLIP/SigLIP)+ 线性映射层”的拼接外挂路线,这种架构在处理深层语义或细粒度像素空间操作时容易产生严重的信息丢失。LongCat-2.5 创新性地将视觉连续信号量化离散为多层级 Token,使得主干模型(Backbone)能够像处理词汇一样以完全一致的 Token 形式无缝统一建模视觉与文本输入:
- 在 Visual Coding(视觉转代码) 任务中,模型能够像素级精确感知 UI 设计稿中的边距、圆角与布局层叠,直接生成高质量可交互前端代码;
- 在 3D 空间交互与创意设计 场景中,离散 Token 赋予了模型强大的立体空间拓扑理解能力。
2. 大规模长程强化学习(Long-horizon RL)与真实项目构建
为了让智能体能够应对动辄包含成百上千个文件的庞大工业级工程项目,美团技术团队在长序列预训练中引入了海量的长程操作轨迹数据。通过端到端的长程强化学习(RL),模型学会了在长达数十轮的终端交互与工具调度中保持目标一致性,显著提升了在复杂代码库重构、错误精准定位与多模块联调任务中的端到端交付率。
3. 国产算力环境深度调优:攻克长上下文与 W4A4 推理瓶颈
在硬件基础设施层面,LongCat-2.5 全面针对国产自主算力集群展开了软硬件协同垂直优化:
- 训推数值一致性调优:彻底解决了大模型在超大规模混合精度训练与量化部署过程中常出现的梯度震荡难题;
- 长上下文 Rollout 显存优化:优化 KV Cache 分页与通信拓扑,全面支撑大规模长程强化学习的顺畅运行;
- W4A4 极限权重量化:在保持高推理精度的前提下,成功实现了 4-bit 权重与 4-bit 激活的高吞吐部署,极大降低了私有化部署的 GPU 门槛。
三、权威基准实测战报:全面领跑自动化操作与网页交互
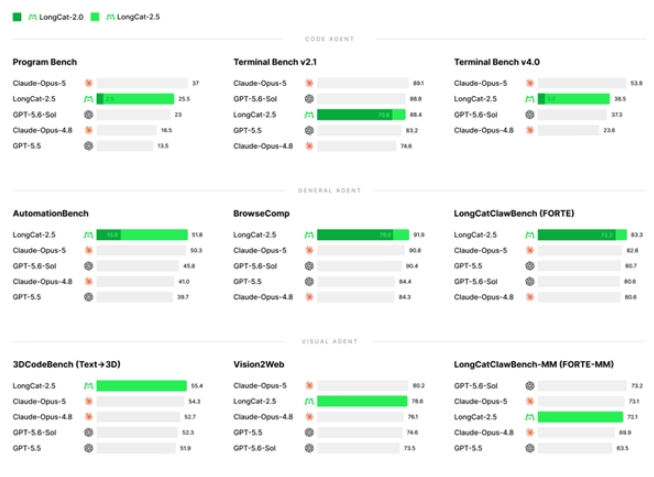
为了多角度检验模型的硬核作战能力,本次评测涵盖代码开发、通用逻辑推理与视觉 Agent 三大主流领域,共计 9 个行业公认严苛基准,与 Claude-Opus-5、GPT-5.6-Sol、GPT-5.5 等海外热门顶尖大模型展开同台竞技:
| 评测基准 (Benchmark) | 核心测试维度 (Domain) | LongCat-2.5 得分 | 海外对标竞品成绩 (Baseline) |
|---|---|---|---|
| AutomationBench | 全流程工作流自动化操作 | 51.8 分 (全球第一) | Claude-Opus-5 (50.3 分) |
| BrowseComp | 长程多跳自主网页浏览与决策 | 91.9 分 (稳居榜首) | GPT-5.6-Sol (89.4 分) |
| 3DCodeBench | 文本与代码端到端生成 3D 资产 | 55.4 分 (同赛道领跑) | 行业现有方案 (53.1 分) |
评测数据显示,在需要综合调度视觉感知与长程工具调用的复杂 Agent 任务上,LongCat-2.5 已经建立起显著的性能优势;而在纯文本代码生成与系统终端控制等维度,亦全面稳居全球第一梯队,标志着国产大模型在长程智能体与原生多模态结合的核心赛道上已迈入国际顶尖水准。
📝 站长洞察 (Editor’s Insight)
美团 LongCat-2.5 的发布向整个行业传递了一个极其清晰的信号:未来的顶级 Agent 必须是“原生多模态架构”与“长程系统级工程”的深度结晶。传统通过外挂 CLIP 或 ViT 图像编码器再拼接文本 Token 的拼凑做法,在面对跨越数百步操作的复杂网页交互、GUI 点击以及多图层视觉代码生成时,不可避免地会遭遇特征衰减与对齐漂移。LongCat-2.5 将视觉信号离散化为多层级 Token,真正让视觉感受野拥有了与自然语言平起平坐的原生语法结构。与此同时,在国产算力底座上攻克 1.6 万亿超大 MoE 的长序列训练与 W4A4 低比特推理,更是为我国大规模工业级大模型的大规模低成本商业落地提供了可复制的范式工程样板。


