

💡 站外导读:在多模态与长时程智能体(Long-horizon Agents)的技术演进中,传统视觉编码器与大语言模型的“松耦合拼接”往往导致高分辨率图像 Token 爆炸与语义理解断层,而在国产算力集群中更面临单卡显存不足 80GB 的残酷工程天花板。美团龙猫(LongCat)团队正式揭晓新一代 1.6 万亿参数原生多模态模型 LongCat-2.5,单 Token 激活仅约 480 亿参数,通过首创的残差向量量化(RVQ)离散视觉表征与全自研国产超节点 FSDP 双重分片架构,在降低算力门槛的同时实现了端到端智能体复杂任务的跨越式突破。
随着大模型从单一问答交互向具备真实环境执行能力的“自主智能体(Autonomous Agents)”演化,工业界对模型的长时程规划、长序列代码生成以及跨模态环境理解提出了近乎苛刻的要求。然而,千亿甚至万亿参数模型的预训练与推理往往受限于算力硬件规格,特别是国产智算芯片普遍面临单卡显存不足 80GB 的物理约束。
美团龙猫(LongCat)核心研究团队于 2026 年 11 月 2 日正式官宣并开源 LongCat-2.5。该模型总参数量高达 1.6 万亿,但得益于极具创新的稀疏混合专家(MoE)路由设计,每生成一个 Token 仅激活约 480 亿(48B)参数。目前在线体验与开发者 API 已正式上线,GitHub 与 Hugging Face 权重正在全面同步。本文将从原生多模态表征、强化学习链路、国产算力分布式并行与 W4A4 推理量化四大维度,深入剖析其底层技术突破。
一、 架构跃迁:1.6T MoE 稀疏基座与 RVQ 多层级离散视觉表征
传统的“视觉语言模型(VLM)”大多采用类似 CLIP 或 SigLIP 的预训练视觉塔,将图像特征通过投影层线性映射后直接喂给语言解码器。这种设计在处理高分辨率复杂屏幕或动态网页交互时,不仅会产生数十万个长上下文 Token,还会造成视觉与文本语义空间的严重割裂。
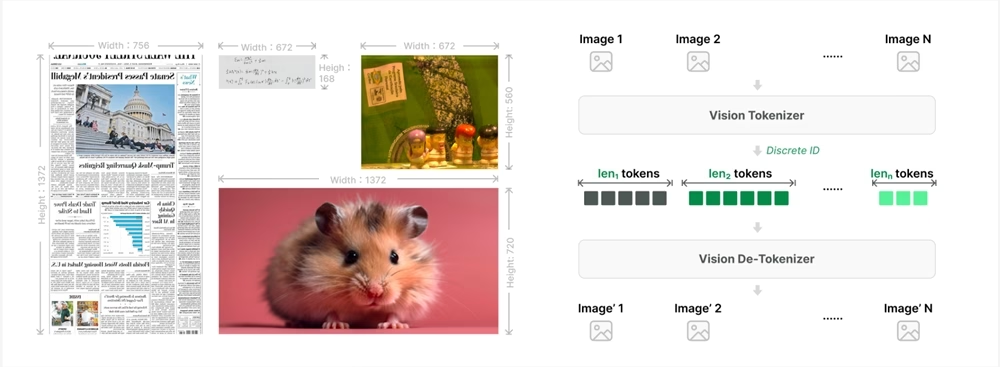
LongCat-2.5 从底层彻底颠覆了拼接范式,采用原生多模态(Native Multimodal)统一建模路线:
- 残差向量量化(Residual Vector Quantization, RVQ):沿用 LongCat-Next 的语义对齐编码器,将连续的视觉像素信号转换为多层级的离散视觉 Token。
- 原生分辨率自适应离散化:图像与视屏无需强行缩放剪裁,直接在原生分辨率下进行切片离散化,并通过离线视觉 Token 预计算机制,使得主干模型可以像处理自然语言文本一样无缝吞吐视觉序列。
- 码本 Embedding 与主干联合梯度更新:视觉码本(Codebook Embedding)与主语言解码器完全联合训练,并在激活约 3B 参数的小型 MoE 验证子模块上实现了视觉与文本概念的深层语义空间交织。
二、 Agentic RL 训练回路:可验证环境与防 Reward Hacking 机制
在智能体长程任务中,单纯依赖高质量人类示范的 SFT(监督微调)存在明显的上限瓶颈。LongCat-2.5 全面导入了闭环的 Agentic RL(智能体强化学习)训练体系,构建了一套自动化数据合成与动态校验流水线:
1. 自动化任务生成与真实环境沙箱
训练流水线从 GitHub 真实代码仓库以及美团内部真实业务场景中提取数万项复杂工程问题,自动合成可交互的容器沙箱与包含严格断言的测试用例。每项任务均需通过严格的 fail-to-pass(修改前测试失败、修复后测试通过)与 pass-to-pass(不破坏原有存量测试)双向校验,彻底杜绝虚假合成数据注入。
2. 异步 Partial Rollout 策略与抗作弊约束
针对智能体任务长尾分布显著、部分复杂用例耗时极长的痛点,LongCat-2.5 采用了 Partial Rollout 异步采样策略,有效缓解了长尾等待开销并抑制了梯度样本的陈旧性。更为关键的是,为了根治强化学习中常见的 Reward Hacking(奖励作弊)现象,训练环境强制执行了三大防线:
- 物理断网隔离:阻断智能体通过外网获取测试答案或预训练泄漏资源;
- 彻底清除 Git 提交历史:防止 Agent 通过反查 Commit Log 逆向提取已知 Bug 修复补丁;
- LLM Judge 独立监督:引入高阶仲裁模型对执行动作链的合理性进行全生命周期审计。
三、 算力底座突破:单卡显存不足 80GB 下的双重分片 FSDP 与超节点拓扑
在算力自主可控的时代浪潮下,如何利用国产智算卡(多数显存规格在 32GB 至 64GB 之间,无法比拟海外 80GB/192GB 旗舰)高效训练万亿参数大模型,是国内顶级实验室面临的核心考题。
美团工程团队针对国产硬件特征量身定制了超节点(Super-node)并行拓扑与双重分片 FSDP 引擎:
- 双重分片优化:在传统 FSDP(Fully Sharded Data Parallel)的参数与梯度分片基础上,深度打通了节点内高速互联总线与跨节点 RDMA 网络的层级通信,实现了激活值与优化器状态的二次精细切分。
- 长序列 SFT 吞吐跃升:在长上下文智能体代码与跨模态多轮轨迹微调中,单卡有效吞吐量较标准的 DDP 基线狂飙 86%,一举击穿了显存溢出(OOM)瓶颈。
四、 推理端 W4A4 极限能效:Prefill/Decode 吞吐飙升超 42%
不仅要训得起,更要在生产环境中用得起。在部署推理阶段,LongCat-2.5 落地了业界极其领先的 W4A4 权重量化与激活值量化方案,将高达 1.6 万亿的 MoE 专家权重以及前向激活值全部压缩至 4-bit 精度:
| 推理性能核心指标 | W8A8 INT8 基线 | LongCat-2.5 W4A4 方案 | 实际能效提升幅度 |
|---|---|---|---|
| Prefill 阶段吞吐量 | 1.0x 基准 | 1.433x | +43.30% ⬆️ |
| Decode 生成吞吐量 | 1.0x 基准 | 1.428x | +42.77% ⬆️ |
| 首字延迟 (TTFT) | 基线延迟 | 显著压降 | -15.91% ⬇️ |
| 单 Token 耗时 (TPOT) | 基线耗时 | 极致平滑 | -19.72% ⬇️ |
| GMM(分组矩阵乘)算子 | 原生算子 | 深度汇编自研加速 | 平均提速 1.73 倍 |
五、 权威基准评测:Terminal Bench v4.0 力压 GPT-5.6-Sol
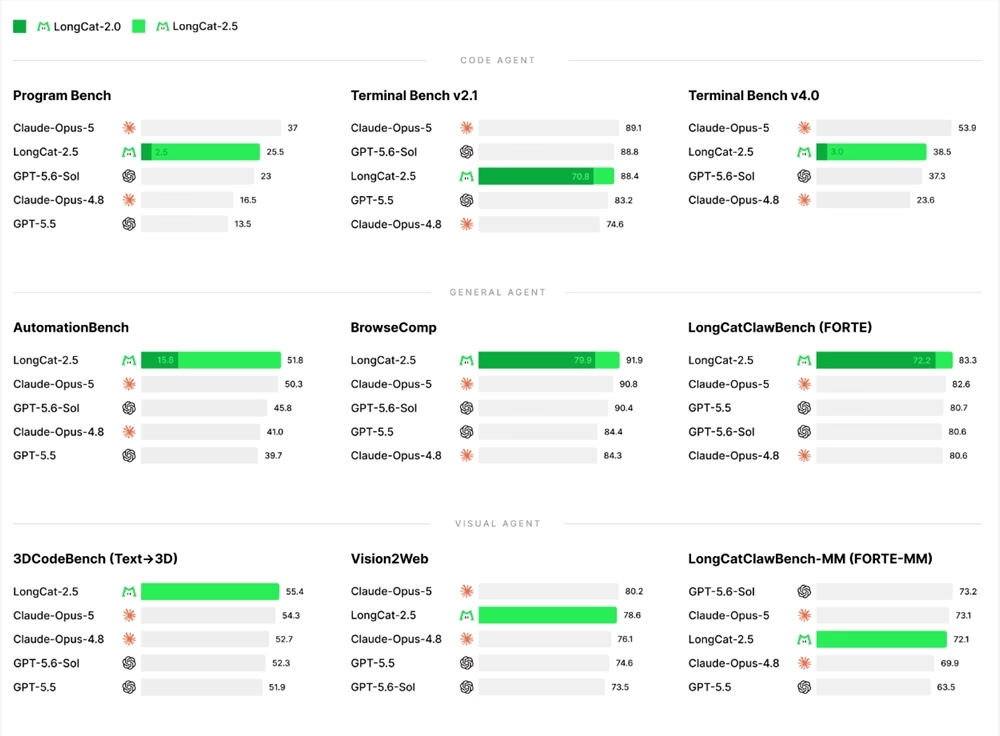
在权威的多模态与智能体公开评测集上,LongCat-2.5 展现了统治级的硬核工程能力:
- 终端与系统级交互:在衡量真实 Bash 终端操作能力的 Terminal Bench v2.1 中拿下 88.4 的高分;在难度大幅提升的 Terminal Bench v4.0 中取得 38.5 分,以明显优势超越了此前由 GPT-5.6-Sol 保持的 37.3 分历史纪录;
- 网页与自动化浏览:BrowseComp 斩获 91.9 分,AutomationBench 拿下 51.8 分,充分验证了离散视觉表征在处理 DOM 树与 UI 界面交互时的抗畸变优势;
- 协议与空间智能:在智能体开放生态协议 MCP Atlas 中录得 83.1 分,3DCodeBench 取得 55.4 分,视觉数学 MathVision 达到 96.5 分,网页视觉转换 Vision2Web 达 78.6 分。
📝 站长洞察 (Editor’s Insight)
LongCat-2.5 的横空出世,标志着国内大模型竞技场正在完成关键的范式跃迁:从单纯堆叠全注意力密度的参数虚火,转向面向真实工业长程任务的高能效工程实战。尤其令人瞩目的是美团在基础设施维度的工程攻坚——在没有海外顶级 GPU 集群支持的前提下,通过双重分片 FSDP 与超节点底层优化,将国产硬件逼出了 86% 的单卡吞吐增量;同时,通过 RVQ 将多模态统一为纯离散序列,彻底解决了视觉长上下文的计算爆炸难题。对于正在构建云端协同、端到端 Agentic 系统的企业而言,这种“存算解耦、稀疏激活、W4A4 极致能效”的系统化架构,才是支撑智能体走出实验室、大规模融入产业生产力的坚实基石。
LongCat-2.5 的核心技术突破是什么?
核心突破在于原生多模态建模、RVQ 多层级离散视觉表征,以及面向国产算力的自研双重分片 FSDP 架构。它在保持 1.6T 总参数规模的同时,将单 Token 激活量控制在约 480 亿。
LongCat-2.5 为什么适合长时程智能体任务?
因为它引入了闭环 Agentic RL 训练体系,结合真实环境沙箱、fail-to-pass 与 pass-to-pass 校验、异步 Partial Rollout 和独立 LLM Judge 监督,更适合代码修复、复杂规划和长序列执行。
LongCat-2.5 对国产显存环境有什么意义?
文章强调其针对单卡显存不足 80GB 的国产硬件约束做了工程优化,通过超节点拓扑和双重分片 FSDP 降低训练门槛,并配合 W4A4 推理量化提升部署可行性。
W4A4 量化最怕哪些精度损失?
最容易受影响的是长链路推理、细粒度多模态对齐和边界样本判断。落地时应先做分层评测:核心决策链保留更高精度,非关键路径再用更激进量化,避免“一刀切”导致整体可用性下降。
RVQ 多层视觉适合什么产品?
适合需要压缩视觉 token、同时保留结构信息的产品,比如长视频理解、工业质检和多模态智能体。它能把视觉信息分层编码,减少显存压力,但前提是任务本身对空间细节有明确收益。
🌐 English Executive Summary — Meituan LongCat-2.5: 1.6T MoE with RVQ Vision and FSDP/W4A4 for Low-Memory Deployment
Meituan has open-sourced LongCat-2.5, a long-context multimodal model built on a 1.6T-parameter MoE backbone where only ~48B parameters are activated per token. It introduces a first-of-its-kind RVQ multilevel discrete vision representation to process images/videos at native resolution while reducing token explosion, paired with a homegrown FSDP sharding strategy and W4A4 quantization to enable training and deployment on GPUs with under 80GB memory.
- MoE sparsity: ~1.6T total parameters with ~48B activated per token for improved inference efficiency.
- RVQ multilevel discrete vision reduces token growth by operating at native resolution for image/video inputs.
- Custom FSDP + W4A4 quantization targets practical deployment on sub-80GB VRAM hardware.


