

💡 站外导读:在人工智能通往通用智能(AGI)与物理世界实体交互的道路上,“世界模型(World Models)”一直被视为最难攻克的终极圣杯。过去的机器人大脑往往严重依赖狭隘的离散轨迹规划或单一的视觉模仿学习,一旦脱离受控的工业台架便立刻丧失通用泛化能力。知名视频生成先驱企业 Runway 突施冷箭,正式面向全球开源其旗舰级 270 亿参数世界动作模型——Praxis-1,并以极为友好的 Apache 2.0 协议开放全量模型权重与微调代码。不同于单纯由画面驱动的视频生成模型,Praxis-1 首次在 27B 规模的混合专家扩散 Transformer(MoE Diffusion Transformer)架构中实现了“未来画面演变”与“关节动作输出”的统一因果预测。在英伟达权威的 RoboLab-120 基准评测中,该模型一举击败一众科技巨头斩获榜首,标志着实体机器人技术迎来了属于自己的开源‘Linux 时刻’。
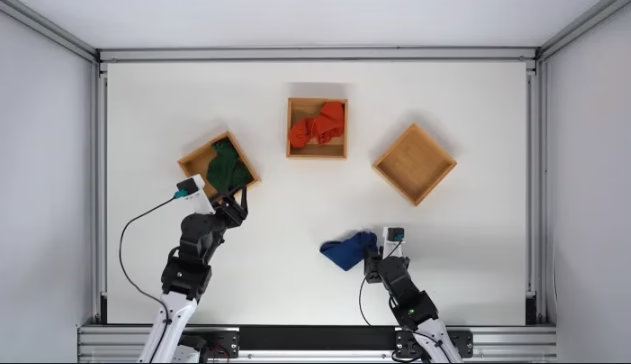
一、告别瞎子摸象:为什么具身智能必须走向“世界动作模型”?
在传统的机器人控制范式中,算法往往被分割为两个互不相通的半岛:一边是负责感知周围环境的计算机视觉(CV)模型,另一边是基于强化学习(RL)或路径规划的关节控制器。这种拼装模式存在一个致命软肋:感知与行动之间缺乏深度的物理因果理解。当机械臂试图推开一个未曾见过的纸箱时,它根本无法预判纸箱倒下后会压到什么物体,更无法根据物体的物理属性实时修正推力。
世界动作模型(World Action Model, WAM)的核心逻辑正在于此:一个真正理解物理世界的智能体,必须能够在内心推演‘如果我执行了动作 A,未来的物理世界将会发生怎样的形态演变’。通过将高维时空视频扩散(Video Diffusion)与低维连续电机动作(Action Tokens)融合在统一的因果网络中,智能体便拥有了类似人类的“空间想象力与物理直觉”。
二、Praxis-1 核心架构:MoE Diffusion Transformer 与统一潜空间
作为首个达到 270 亿参数体量的商业级世界动作模型,Runway 在 Praxis-1 上采用了极具开创性的计算拓扑:
- 混合专家扩散 Transformer(MoE Diffusion Transformer):模型底层将动力学推理拆分为多个稀疏激活的专家网络,在保持 27B 庞大容量的同时,单步推理仅激活约 45 亿参数,使得工业级推理延时能够压制在边缘工控机所能承受的毫秒区间。
- 多模态联合动作潜空间:模型打破了将视频与关节坐标分开编码的惯例,构建了统一的 Action-Video Latent Space。视频帧序列与 7 自由度机械臂末端位姿、夹爪力矩等物理动作共享注意力矩阵,确保预测出的每一个物理动作都严格对齐视觉物理定律。
- 双向自回归验证机制:系统既可以接收当前画面与目标任务并输出连续动作序列,也可以在给定动作输入的前提下反向生成未来数十帧的高清演化视频,为机器人的自我纠偏提供了高精度的数字孪生验证沙盒。
三、权威评测对决:RoboLab-120 击败英伟达与物理泛化突破
在 NVIDIA 旗下权威的 RoboLab-120 基准测试(包含精密组装、柔性物体操纵、动态避障等 120 种高难度现实环境)中,Praxis-1 展现出了令人瞩目的统治级表现:
| 参评模型与开源属性 | 核心模型架构体系 | RoboLab-120 综合成功率 | 未见机器人迁移 (SimplerEnv) |
|---|---|---|---|
| Runway Praxis-1 (Apache 2.0) | 27B MoE Diffusion Transformer | 46.2% (全场第一) | 80.0% (大幅跃升) |
| FLUX3Action (开源受限) | 12B Dense DiT 架构 | 42.9% | 61.5% |
| NVIDIA Cosmos3Nano (非商用) | 7B 视觉预训练模型 | 36.8% | 54.2% |
| Physical Intelligence π0.5 (闭源) | VLM-Flow 离散规划体系 | 28.0% | 52.4% (基准水平) |
四、从足式人形到工业六轴:跨硬件形态零样本迁移实录
在产业界最受关注的硬件适配测试中,Runway 与 Noble Machines、Standard Bots 以及 Ultra 等多家顶级硬件先锋展开了实机联测。令人震撼的是,即便面对其训练集完全未曾涵盖的 Google RT-1 机械本体,研究人员仅仅通过在 SimplerEnv 模拟器中执行少量轻度 LoRA 微调,Praxis-1 的操纵成功率便瞬间从原始基准的 52.4% 暴涨至 80.0%。
无论是搭载在两足人形机器人的动态越障步态规划中,还是部署在六轴工业机械臂的易碎品装箱工序中,Praxis-1 都展现出了对接触力学、重力摩擦以及复杂光照变化的高度鲁棒性,彻底洗刷了以往“仿真做得好,下地就翻车(Sim-to-Real Gap)”的工程噩梦。
五、Apache 2.0 彻底解绑:加速实体机器人商业落地的生态蝴蝶效应
更具产业冲击力的是 Runway 的授权策略:全量开放权重、推理端到端代码与下游微调框架,且遵循完全宽松的 Apache 2.0 商业许可。这意味着全球的具身智能初创企业不再需要从零烧钱训练百亿级基础世界模型,而是可以直接将 Praxis-1 作为“大脑内核”,插载在自己的专有硬件上展开商业化变现与闭环定制。
📝 站长洞察 (Editor’s Insight)
Runway 开源 Praxis-1 的历史意义,绝不亚于当年 Stability AI 开源 Stable Diffusion 对视觉创作领域的彻底重构。长期以来,具身智能赛道呈现出一种高度割裂的畸形生态:拥有顶级硬件本体的机器人制造商缺乏千亿级多模态世界模型能力,而手握顶尖算力与预训练大模型的算法巨头又往往将物理模型严密闭源在实验室深水区。Runway 凭借其在物理动力学连续视频生成领域的数年深厚积累,将原本只用于‘观赏娱乐’的视频扩散引擎,成功改造为能够指导机械手抓取、双足平衡与环境抗扰的‘物理世界因果大脑’。更重要的是,Apache 2.0 许可证的全面放开,意味着全球数以千计的中小具身智能团队可以直接站在 27B 的巨人肩膀上开发专有应用。具身智能的工业化落地进程,正被这场开源风暴硬生生提速至少两年。
Praxis-1是什么类型的模型?
Praxis-1是Runway开源的27B世界动作模型,核心是MoE Diffusion Transformer。它把视频未来演化预测和机器人连续动作输出统一到同一框架中,面向具身智能与机器人控制场景。
Praxis-1为什么被称为具身智能的Linux时刻?
因为它以Apache 2.0开放全量权重和微调代码,降低了企业训练和部署世界模型的门槛。再加上基准成绩领先,意味着行业可以在开源底座上快速做商业化二次开发。
Praxis-1在实测中表现如何?
文章提到它在NVIDIA RoboLab-120基准中取得46.2%综合成功率、位列第一;在SimplerEnv迁移测试中可从52.4%提升到80.0%。同时还展示了跨人形与六轴机械臂的零样本迁移潜力。
MoE扩散架构为何适合动作预测?
MoE可把不同技能路由给专门专家,扩散则更适合生成连续动作轨迹与视频演化。两者结合能同时兼顾多模态一致性和长时序控制,但训练稳定性、路由塌缩和推理延迟都要重点监控。
Apache 2.0开放后,企业该怎么接入?
优先做三层验证:先用离线回放评估动作安全边界,再在仿真里做任务成功率与失败恢复测试,最后小规模真机灰度。商业化关键不只是微调,还要补齐数据闭环、监控告警和安全策略。


