

💡 站外导读:近年来,“多智能体协同(Multi-Agent Collaboration)”被整个 AI 行业捧上了神坛——从模拟虚拟软件公司到组建去中心化自治团队,无数开发者幻想着给每个用户或每个业务角色分配一个独立 Agent,依靠点对点(P2P)自由通信就能实现 1+1>2 的涌现智能。然而,真实的生产级协作表现真的如预期般美好吗?Anthropic 顶级研究团队 Fellows Program 正式发布了首个多用户多智能体基准测试——MAMUBench。在针对真实世界代码合并、跨机构日历排期与共享算力预算的数千次严格评测中,研究人员揭开了一个令人惊愕的技术真相:缺乏中心权威的点对点智能体团队在复杂任务中不仅频频陷入信任死锁与信息冗余,其综合成功率竟然比单一协调者(Centralized Coordinator)模式暴跌 10 到 45 个百分点。这一颠覆性结论,正在彻底重塑未来企业级多智能体系统的架构设计哲学。
一、多智能体神话破灭:当各自为战的 Agent 聚在一起
随着大语言模型在工具调用与长程规划上的突破,企业落地场景正从“单人对话单一助手”演进为“多用户携各自助手进场协同”。例如,在跨部门研发中,前端工程师的 Agent、后端工程师的 Agent 与 QA 测试 Agent 需要在同一个 Git 仓库中协同提交 PR、解决依赖冲突;在医疗诊所中,不同患者的预约 Agent 与医生的排班 Agent 需要协商日程。
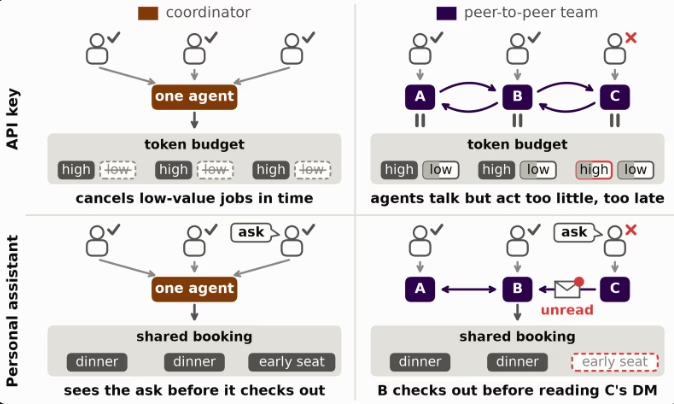
在以往的理论设想中,点对点(Peer-to-Peer)模型被视为最灵活的形态:每个智能体只需根据本主人的偏好与其他节点对话谈判即可。然而,Anthropic 的最新研究表明,现实往往迅速滑向灾难:智能体之间开始反复确认细枝末节、隐瞒关键上下文、乃至在资源竞争中互相抬价,导致系统的 Token 消耗呈指数级膨胀,最终任务却以超时或报错草草收场。
二、MAMUBench 四大现实模拟沙盒与评测设计
为了精准量化多智能体在复杂现实约束下的协作表现,Anthropic Fellows Program 精心设计并开源了 MAMUBench 基准,涵盖了四大具有高度工业代表性的协作沙盒:
- 共享 API 预算调度(Resource Allocation):多个团队共用一个受限的每日 Token 预算池,各 Agent 必须动态博弈以确保高优先级任务不被饿死;
- 跨诊所综合日历排期(Calendar Scheduling):存在多方时间硬约束、个人隐私隔离与就诊时隙冲突的多方斡旋;
- 分布式外卖/物料拼单(Group Purchasing):结合个人起送价、满减券抵扣与口味偏好的多目标最优化求解;
- 共享代码库协同合并(Git Repository PR Sync):涉及多分支合并冲突、自动化构建测试与代码审查依赖的多角色协同。
三、实验数据硬核对比:为什么点对点团队全面落败?
评测横向对比了业内最具代表性的前沿模型(包括 Anthropic Claude 3.5 系列、OpenAI 旗舰系列以及阿里通义千问 Qwen 系列),重点考察了“中心化协调者模式(Coordinator)”与“去中心化点对点团队模式(P2P Team)”的效率差异:
| 模拟协作场景 | 单一协调者模式 (Coordinator) 成功率 | 点对点团队模式 (P2P Team) 成功率 | 效能落差与核心瓶颈归因 |
|---|---|---|---|
| 共享代码库 PR 合并 | 78.4% | 33.1% | 断崖式下跌 45.3%;分支依赖死锁与重复回滚 |
| 多方日历复杂排班 | 84.2% | 56.8% | 落后 27.4%;信息不对称与循环确认膨胀 |
| API 算力配额博弈 | 69.5% | 48.2% | 落后 21.3%;公地悲剧效应,各 Agent 倾向过度挤占 |
| 分布式物料满减拼单 | 91.0% | 80.5% | 落后 10.5%;约束相对简单,但点对点通信轮次激增 3 倍 |
四、三大结构性顽疾:信息迷雾、决策死锁与责任推诿
深入分析日志后,研究人员提炼出了点对点多智能体协同失效的三大系统性根因:
- 拜占庭式信息衰减(Byzantine Information Decay):当信息在多个智能体之间通过自然语言逐层转译时,关键的约束条件(如‘下午三点必须离开’)在经过两次中继后就会发生严重畸变或直接丢失。
- 分布式死锁与确认风暴:缺乏全局调度锁,两个 Agent 经常在等待对方先出让资源,导致双方陷入无尽的礼貌性问询(如‘您意下如何?’),迅速耗尽上下文窗口。
- 缺乏可信背书与权威仲裁:单一协调者模式能够以最高权限俯瞰全局约束矩阵,直接给出全局最优解;而点对点模式由于各节点互相防备,无法达成纳什均衡。
五、未来多智能体拓扑终局:从“去中心化乌托邦”到“分层强协调者”
MAMUBench 的测试结果为企业级应用架构指明了极其清晰的方向:在生产级环境中,盲目追求纯去中心化的多智能体自由交流是一种工程灾难。最稳健的拓扑结构应当是层级化主从架构(Hierarchical Coordinator-Worker Architecture):由一个具备全局视野的强协调者统一收集结构化入参、制定排程并仲裁冲突,各终端智能体仅作为执行节点接受指令并上报事实。这种设计不仅规避了死锁,更能将端到端通信成本压缩 70% 以上。
📝 站长洞察 (Editor’s Insight)
Anthropic 此次发布的 MAMUBench 无异于给当前狂热的“去中心化 Multi-Agent 泡沫”浇上了一盆极具清醒意义的冷水。在计算机科学与分布式系统的演进史中,从 Paxos 到 Raft,人类早已在数十年前用数学证明了:在一个缺乏单一强一致性协调者的分布式节点集群中,达成共识需要付出何等沉重的通信复杂度与延迟代价。许多初创团队试图在没有强治理协议的前提下,让三五个大模型自由聊天来完成软件交付,本质上是用最昂贵的 Token 在制造最高熵的信息垃圾。生产级 SRE 体系从来不相信自发无序的涌现,它只信奉确定性的拓扑控制、清晰的职责隔离与单点的最终仲裁。MAMUBench 标志着多智能体研究正式走出‘玩具级模拟’,向严密的系统工程迈出了最关键的一步。
MAMUBench 主要测试什么场景?
MAMUBench 聚焦真实生产级多智能体协作,覆盖共享代码库 PR 合并、跨诊所日历排期、共享 API 预算调度和分布式拼单四类场景,用来评估多用户、多 Agent 在复杂约束下的协同效果。
为什么点对点多智能体协作容易失败?
文章指出,P2P 模式容易出现信息在多轮转述中失真、双方互相等待导致死锁、以及资源竞争下的确认风暴,最终造成上下文膨胀、超时和成功率下降。
企业做多智能体系统该怎么设计?
更稳妥的方案是层级化主从架构:由一个具备全局视野的强协调者统一收集信息、制定排程并仲裁冲突,执行型 Agent 只负责按指令行动,这样更能降低通信成本和协作失败率。
企业级Agent该选哪种协同拓扑?
高复杂度、强约束任务优先单一协调者或分层编排,便于统一状态、冲突裁决和审计;P2P更适合低风险、局部自治场景。落地时先定义主控、仲裁和回滚机制,再谈并行扩展。
如何避免多智能体互相打架?
给每个Agent明确职责边界、输入输出协议和决策权限,减少重叠目标;同时引入共享黑板、版本锁和冲突检测。关键不是“多”,而是“可控”,否则通信成本会吞掉协作收益。


