

💡 站外导读:当AI应用跑通PMF并迎来流量爆发,直接调用闭源大厂API的账单与可用率隐患很快会成为瓶颈。The Pragmatic Engineer联合Modal、Fireworks AI与Baseten三大推理团队,复盘Uber降本50%、Pinterest狂省90%及Revolut自建56块B200裸金属的架构抉择,拆解私有Eval、多租户“吵闹邻居”、KV冷缓存与专属GPU演进指南。
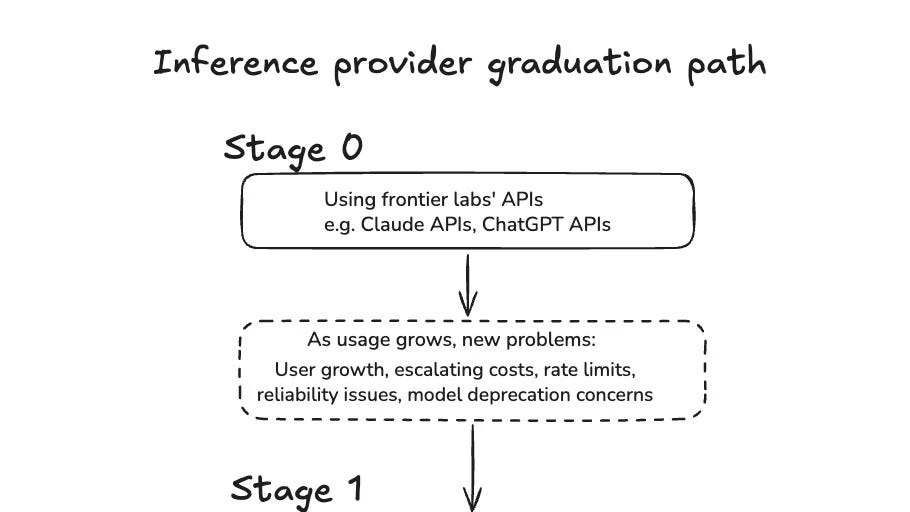
一、 走出大厂 API 舒适区:三大推理巨头定位与闭源 SLA 隐忧
越来越多科技公司正在把核心 AI 负载从闭源前沿实验室迁出:过去数月,Uber 将单 Token 成本砍掉约 50%,Pinterest 降本高达 90%,AT&T 也拿下了 56% 的降幅。迈出这一步通常有两条路:少数资金与运维雄厚的玩家选择“裸金属自建”,例如金融科技独角兽 Revolut 直接自购部署 56 块独立 NVIDIA B200 来扛内部推理;而绝大多数团队则会牵手专注开源权重托管的独立推理服务商(Inference Providers)。
尽管对外都提供流式 Token 与兼容接口,但 Modal、Fireworks AI 与 Baseten 三家头部厂商的技术路线各有侧重:Modal 定位为可编程云基础设施,推崇让开发者在 SDK 中看清每一行底层运行代码,并将性能调优反馈给开源生态;Fireworks AI 主打面向垂直负载的专属部署与后训练微调,例如其基于 Kimi K3 后训练的 Ember-1 模型,在同等质量下将推理 Token 消耗压低了 40%;Baseten 则围绕推理底座向上叠加沙箱、治理与自服务微调,主打构建 Agent 的一站式无锁定平台。
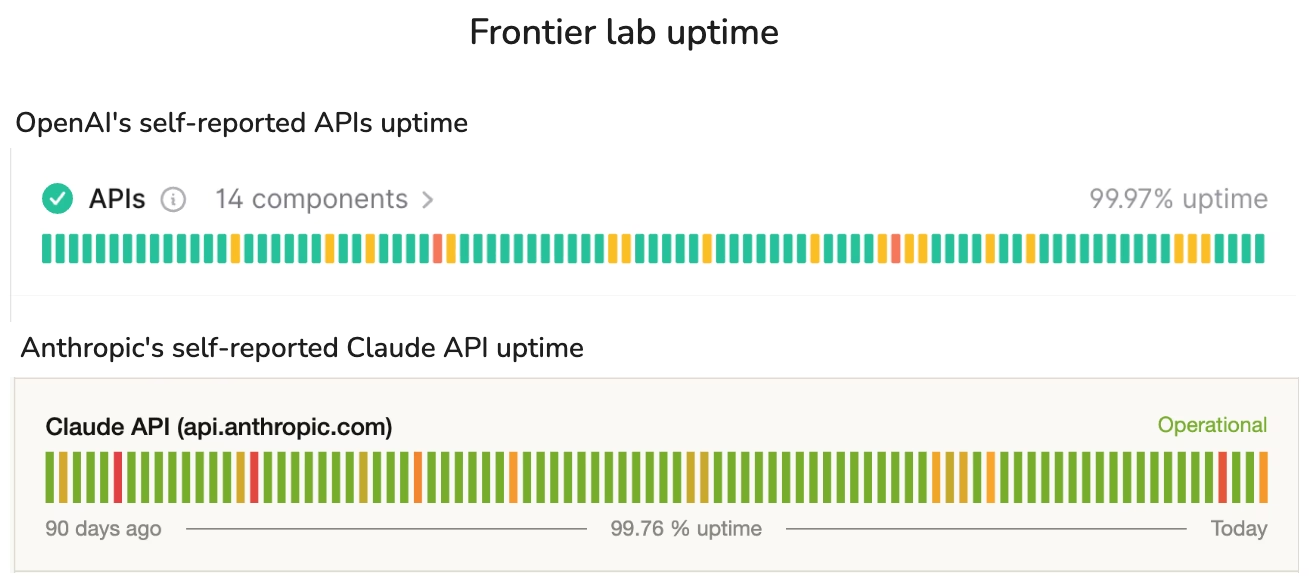
更深层的迁移推力来自可靠性落差。传统云厂商(如 AWS)常年维持四个九(99.99%+)的可用率,而前沿 AI 实验室公开的自我声明可用率明显偏低——Anthropic 为 99.5%,OpenAI API 为 99.97%(ChatGPT 为 99.2%)。更棘手的是,多租户共享队列下的“性能静默降级”并不会计入宕机时间,处于关键链路的应用往往莫名变慢却无从感知与干预,这也是 Ramp 等工程团队早早自研多供应商 LLM 容灾网关的直接诱因。
二、 迁移动因与选型方法论:私有 Eval 资产、单任务成本与精度偏差
工程团队决定切换至独立推理商,通常围绕成本(Cost)、延迟与版本可控(Control)以及定制化(Customization)三大核心诉求展开。在成本侧,大量线上请求根本用不到旗舰模型的全部智力,引入“提示词感知的智能路由(Smart Router)”把简单请求分流给高性价比开源模型,几乎是零门槛的降本动作;在控制力侧,专属推理部署能彻底锁定模型版本,避免大厂后台突然静默更新权重导致线上业务行为漂移。而在定制化侧,Modal 推理负责人 Richard Gong 透露目前仅约 10% 的深度用户会走到这一步,主要用于将垂直经验蒸馏/后训练到更小参数模型上,或在法律、医疗等私有数据领域补齐通用模型短板。
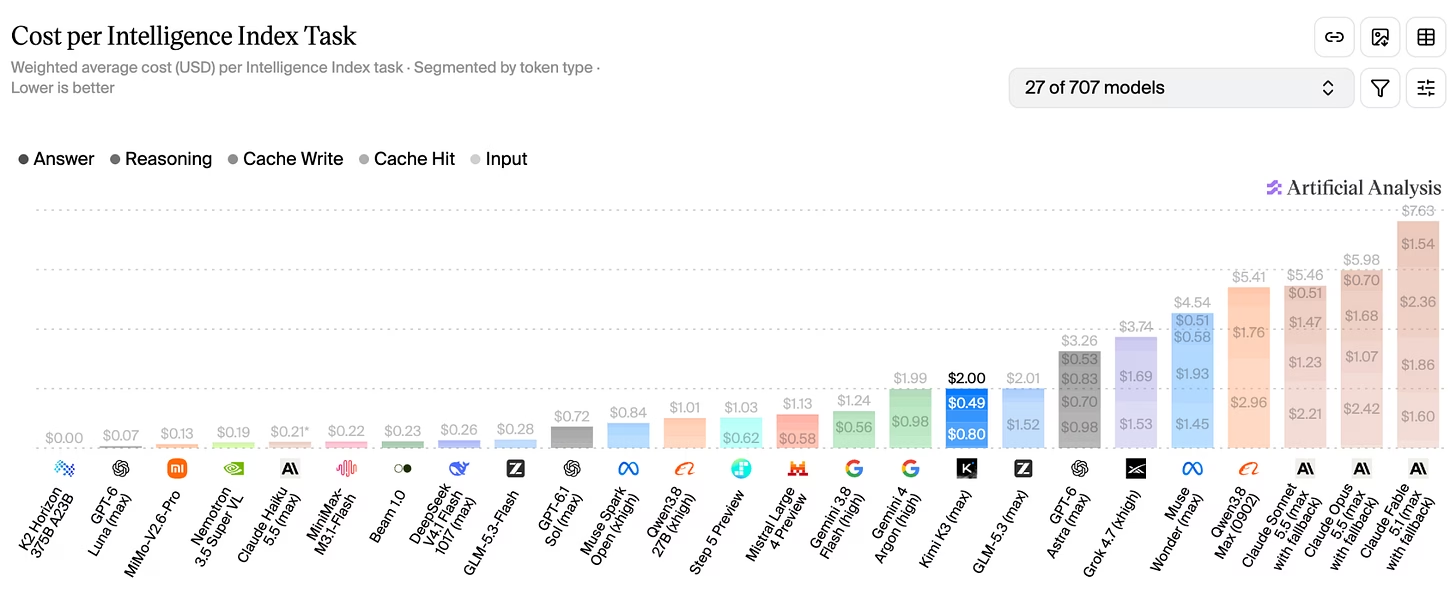
选型时切忌迷信通用榜单。微软 CEO 萨蒂亚·纳德拉近期在 The Pragmatic Engineer 播客中指出,企业的“私有 Eval 评估集”将成为未来核心知识产权:团队先用前沿模型跑通确定性工作流并攒下真实调用轨迹(Traces),再用私有 Eval 对多款开源模型做离线回放或小流量 A/B 测试。例如在 Artificial Analysis 的智能指数基准中,若按“单任务平均成本”而非单 Token 价格核算,Anthropic Sonnet 5.5 单任务均价为 5.46 美元,而 Kimi K3 仅需 2.00 美元(降幅约 60%)——按任务计价才不会忽略不同模型推理步数差异带来的隐藏账单。
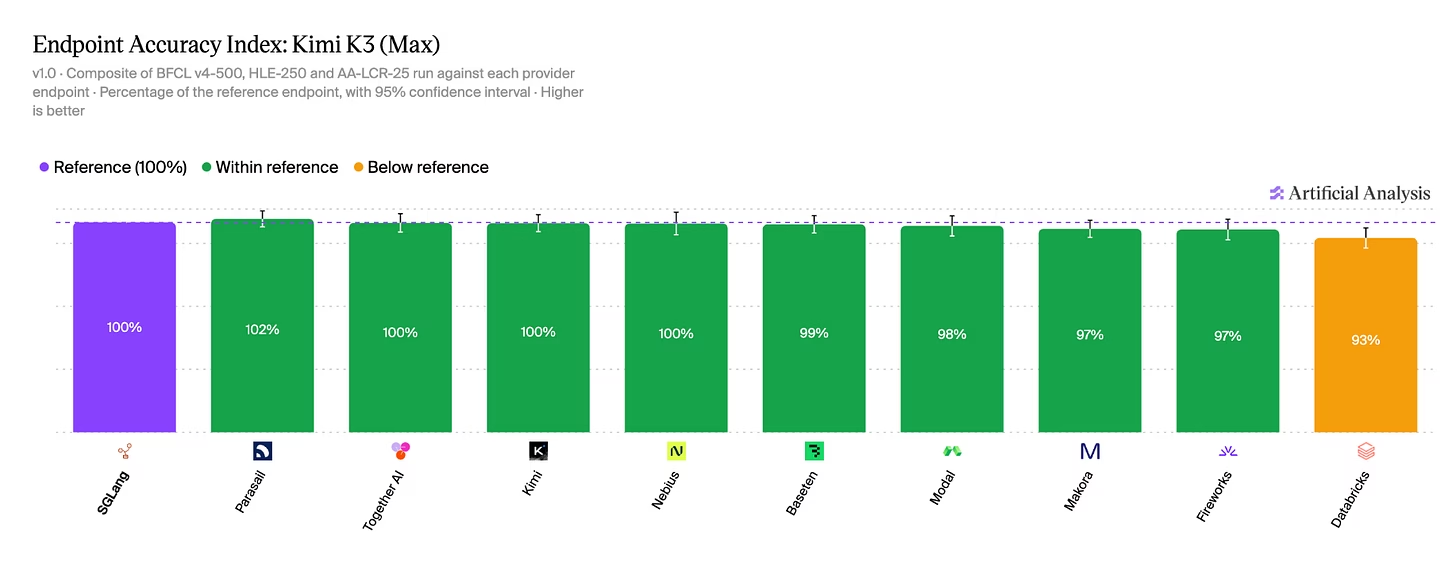
即便选定了同一款开源模型,不同推理服务商的实际输出质量也可能大相径庭:有些平台会悄悄截断最大上下文窗口,或采用不同的权重量化精度与默认 Temperature。Artificial Analysis 对 Kimi K3 在各推理商的端点准确率横评显示,各家得分分布在 93% 至 102% 之间(受非确定性与 95% 置信区间影响,部分微调调优版本甚至略低于或持平自托管基准),因此上架前必须在真实样本上跑通多端点精度核验。
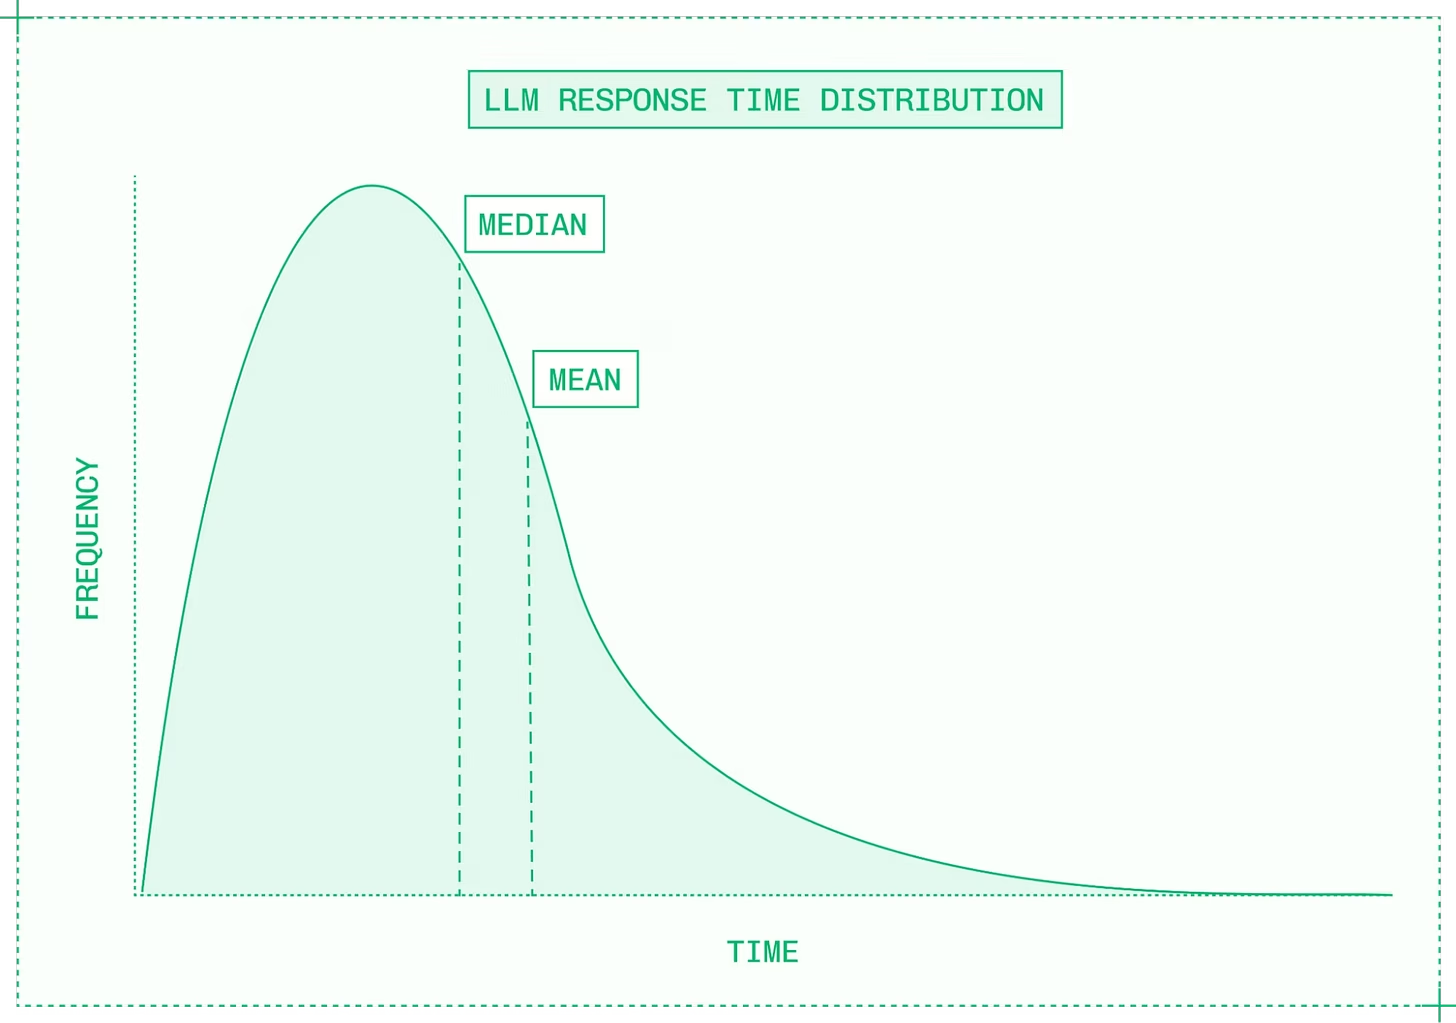
三、 演进三阶段与 Stage #1 暗礁:TTFT 长尾分布与无状态 REST 原罪
2. 无状态 REST 接口与有状态 Agent 上下文的根本冲突
Fireworks AI 联合创始人兼 CTO Dmytro Dzhulgakov 一针见血地指出,当年以 OpenAI Chat Completions 为蓝本将大模型接口设计成“无状态 REST API”几乎是一场“原罪”。表面上客户端每次都把完整系统提示词、历史对话与 Agent 工具上下文打包重传,但真正承载业务的是高度有状态的多轮会话;为了不重复烧掉算力和 TTFT 时间,分布式路由与边缘节点被迫在后台拼命做前缀 KV 缓存追踪。开发者如今可以通过接口返回体直接观测 Prompt Cache 命中率,并以固定前缀顺序、会话粘性路由等工程手段主动配合缓存命中。
四、 三大部署模式对比与 Stage #2 专属 GPU 进阶架构清单
当业务体量跨过单租户临界点,迈入 Stage #2 专属 GPU 节点后,软件工程师将正式接管一系列底层推理权衡:包括如何匹配模型尺寸与显存带宽、在“低交互延迟”与“高批处理吞吐”间做动态取舍、精细规划 KV Cache 显存配额、设计跨可用区容灾降级(Failover),以及在 Decode 解码阶段存在算力富余时引入投机解码(Speculative Decoding)借助小草稿模型进一步拔高生成吞吐。下表总结了三种演进形态的全面工程对照:
| 架构评估维度 | 闭源前沿实验室 API (冷启动期) | Stage #1:多租户开源推理 API | Stage #2:专属 GPU / 自建裸金属 |
|---|---|---|---|
| 代表模型与生态 | Anthropic / OpenAI 等闭源旗舰 | DeepSeek 4.1 Flash、GLM 5.3、Kimi K3.1 Pro 等 | 开源模型固定权重 + 私有领域后训练微调版 |
| 成本计价与降本幅度 | 按 Token 计价,高并发阶段账单陡增 | 智能路由替换简单任务,实测可降本 50%–90% | 需预付长期包卡承诺,超高并发下边际成本最低 |
| 可用率与性能可控性 | 官方 SLA 99.5%–99.97%,存在黑盒静默降级 | 支持多厂商容灾切换,但仍受吵闹邻居与冷启动影响 | 完全独占算力池,杜绝吵闹邻居并彻底锁定模型版本 |
| 核心延迟与缓存治理 | 依赖厂商内部黑盒缓存,仅可观测 Prompt 命中率 | 需优化客户端连接池与请求前缀顺序以保 KV 命中 | 自主掌控 KV Cache 容量、并发副本扩容与 Failover |
| 进阶吞吐与质量调优 | 无法修改模型权重,仅靠 Prompt 与推理预算调节 | 需核验服务商上下文上限、量化精度与端点准确率 | 支持小模型蒸馏微调及 Decode 阶段投机解码加速 |
📝 站长洞察 (Editor’s Insight)
这篇文章把“推理工程”从玄学调优拉回了传统后端架构师熟悉的坐标系。很多团队在冷启动期习惯无脑对接OpenAI或Anthropic,却忽略了“单任务成本”与“推理Token膨胀”的差异,也低估了99.5%可用率加上无状态API对复杂Agent的杀伤力。从工程实践来看,真正稳健的迁移绝非一上来就盲目采购裸金属GPU,而是遵循“私有Eval建基准 -> 多租户网关智能路由试水 -> 触发限流与p99长尾痛点后再锁专属GPU与KV Cache容量”的渐进路线。先用连接池与Prompt缓存命中率监控榨干多租户红利,再谈重资产锁卡。
企业为什么要从闭源API迁向开源推理?
核心原因是成本、可控性和稳定性。闭源 API 在流量放大后容易出现账单飙升、版本漂移和可用率隐患;而开源推理或专属 GPU 方案能锁定模型版本,结合私有 Eval 和智能路由,把高频业务的单任务成本明显压低。
私有Eval在模型选型里有什么作用?
私有 Eval 是企业自己的评测资产,基于真实业务样本和调用轨迹来比较不同模型与推理端点的效果。它比通用榜单更贴近线上表现,能帮助团队判断模型是否适合实际工作流,并避免只看单 Token 价格导致的误判。
多租户推理服务最大的风险是什么?
最大的风险是“吵闹邻居”和性能静默降级。即使接口没有报错,共享资源争用也可能让延迟变慢、上下文窗口被截断或缓存命中率下降,影响关键链路体验。因此上架前要做真实样本压测和多端点精度核验。
📊 Frontier lab uptime(AI 视觉结构化提取)
核心发现:图中展示了两家前沿模型 API 的自报可用率对比:OpenAI APIs 为 99.97%,Anthropic Claude API 为 99.76%,OpenAI 略高。
| 服务 | 公开口径 | 可见组件数/时间窗 | 可见可用率 |
|---|---|---|---|
| OpenAI APIs | OpenAI's self-reported APIs uptime | 14 components | 99.97% uptime |
| Claude API | Anthropic's self-reported Claude API uptime | 90 days | 99.76% uptime |
私有 Eval 应该先测什么指标?
先测任务成功率、幻觉率、延迟 P95 和单位请求成本,再按业务场景分层。不要只看离线准确率,最好把真实线上样本、失败案例和人工标注一起纳入,才能判断迁移是否真的可控。
多租户推理服务怎么避免互相抢资源?
核心是做配额隔离、动态限流和优先级调度,并把 KV cache、batching、显存水位纳入统一监控。高峰期可按租户拆分队列,低优先级请求降级到更便宜的模型或更慢的通道。


