

💡 站外导读:前沿科学探索与超大规模系统工程长期受制于单一大模型的两大物理瓶颈:生成结果随机失真导致的一步走错全盘皆输,以及随着多日长程任务展开注意力在膨胀上下文中稀释涣散。Google Research 今日正式宣布向全球科研人员与开发者开放 Antigravity 平台的核心多智能体能力——/teamwork。该系统基于最新的 Gemini 4 系列模型(Argon、Carbon、Hydrogen),通过创新的“生成器-证伪器解耦(Generator-Falsifier Separation)”与“上下文构造级物理隔离”,一举攻克了信息论领域悬宕 13 年的 Courtade–Kumar 猜想(生成 5,000 万行 Lean 4 代码),并在分布式微内核与 TPU 算子优化中实现了高达 90 倍的吞吐暴增。本文将对这一里程碑式的多智能体工业级底座进行全景深度拆解。
一、 架构范式革命:为什么长程科学推理必须彻底打破“单模型大上下文”神话?
在过去的智能体探索中,行业普遍寄希望于不断扩大大语言模型(LLM)的单窗口上下文(Context Window),试图通过把成百上千页的代码库、数学论文与执行日志一股脑丢给同一个模型来解决长程复杂任务。然而,Google Fellow 兼 Google Research 副总裁 Vahab Mirrokni 率领的团队在实践中发现,这种单体范式存在致命缺陷:
- 单次生成的随机性与验证鸿沟:单模型在推理长链条问题时,只要某一个推导步骤产生微小幻觉,整条链路就会彻底崩溃。传统单 Agent 无法实现客观的自我批判,极易陷入自证自洽的逻辑泥潭;
- 上下文注意力耗散与细节漂移:当任务周期跨越数天、上下文积累达数百万 Token 时,模型的注意力分布呈指数级弥散,根本无法精准捕捉数十个步骤前的约束边界;
- 紧耦合推理的死锁陷阱:并行暴力分支探索在遇到高度依赖拓扑的系统代码时,常常导致大量子模块因接口脱节而无法组装。
针对这一瓶颈,Google Antigravity 团队研发了 /teamwork 多智能体协作架构。其核心设计原则非常纯粹:“按构造切分上下文(Partition Context by Construction)”。在 /teamwork 中,没有任何一个智能体能看到全局长上下文;每个专业智能体仅持有完成当前特定原子步骤所需的最小物理文件和专有工具集。协调器(Coordinator)负责将上一步的结构化产物交接给崭新的后继智能体,而独立的审查员(Auditors)与证伪器(Falsifiers)则在完全干净的上下文中对中间结果进行无偏见的物理检验。
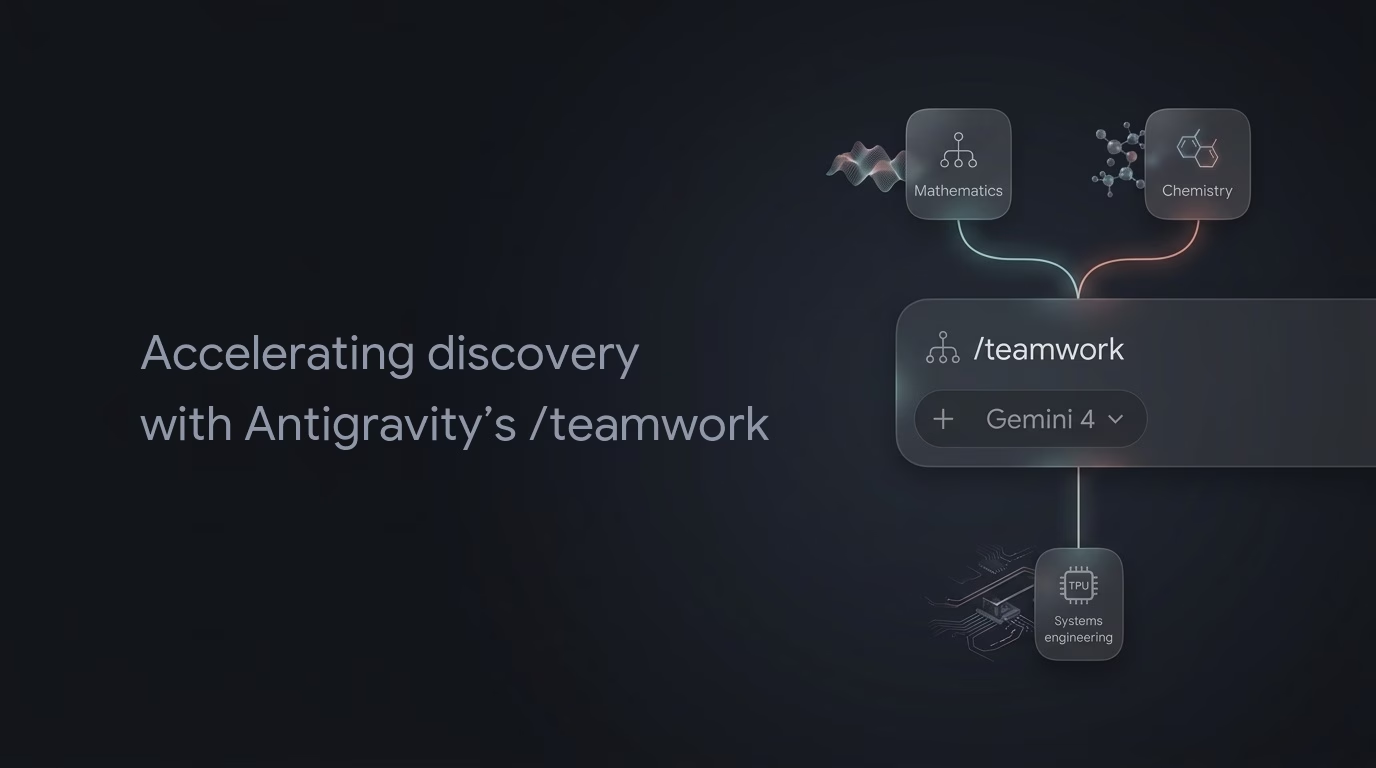
二、 数学与形式化验证实战:5000 万行 Lean 4 攻克 Courtade-Kumar 猜想
数学定理证明是检验 AI 逻辑推理严密性的“试金石”。人工审查包含数万行计算的手稿极易遗漏微小漏洞,而将数学推导形式化为 Lean 4 代码,则允许编译器内核逐行对逻辑进行物理绝对验证。/teamwork 在这一领域交出了震撼学界的答卷:
- 攻克 2013 Courtade–Kumar 猜想:来自 Google、香港中文大学(CUHK)、南加州大学(USC)与卡内基梅隆大学(CMU)的联合团队,利用
/teamwork的“长程证明模式(Long Proof Pattern,内部代号 Stellar Colosseum)”,完整证明了信息论著名猜想。该猜想指出:当随机比特串通过带噪信道时,将输入压缩为单个比特的方案中,没有任何压缩方式能比直接复制单个输入比特的“独裁者函数(Dictator Function)”保留更多互信息。Gemini 首先推翻了前期论文中的泛化猜想反例,随后与 CUHK 团队构建的 14 变量优化模型协同,自主推导了区间算术证书,并将证明从平衡函数无监督扩展至非平衡函数,最终生成了整整 5000 万行经过 Lean 4 严格编译通过的形式化代码; - 全自动形式化 Pierre Deligne 韦伊猜想:借助结合了 Google Cloud AI 与 Gemini 4 Argon 的 LEAP 框架,
/teamwork-LEAP在无人干预的情况下,历经 28,800 次子智能体并发调用,产出了 180 万行 Lean 代码,实现了对皮埃尔·德利涅 1974 年代数几何巅峰之作——有限域多项式方程解计数的韦伊猜想(Weil Conjectures)的全量端到端机器形式化; - 攻坚千禧年大奖难题 Navier-Stokes 方程:该系统独立重现并机器验证了三维不可压缩 Navier–Stokes 方程在平滑外力作用下有限时间爆破(Blowup)证明的全量 Lean 形式化,为这道悬宕近 90 年的千禧难题提供了坚不可摧的逻辑铁证。
三、 系统软件与内核工程:微内核 PGAS 吞吐提升 90 倍与 TPU 算子加速
在纯数学之外,/teamwork 展现了更加恐怖的底层系统级软件工程改造能力。在大规模代码迁移与内核重构中,普通 AI 经常通过 mock 测试或篡改测试用例来制造“全部通过”的虚假繁荣。而 /teamwork 通过拓扑编译依赖编排与未修改测试集硬约束,实现了真正的工业级重构:
- FarArray 低延迟微内核分布式系统:基于 Google SNAP 微内核构建绕过 Linux 内核的分布式全局地址空间(PGAS)。利用
/teamwork与 Argon 模型,开发的无锁连通分量算法能够轻松扩展至 1 万亿条边超大规模图计算,相较传统 TCP 键值存储实现了 60 到 90 倍的吞吐量提升、40 至 180 倍的加速比,同时将 RAM 内存消耗暴降至六分之一; - 80 万行 Google Zircon 微内核全量重构为安全 Rust:在两周的高强度多 Agent 战役中,团队将 Fuchsia OS 核心微内核剩余的 C++ 代码全部迁移至内存安全的 Rust 语言,产出 80 万行代码并通过了全部单元测试,成功在 arm64 真实物理硬件上冷启动点亮;
- TPU Pallas 算子优化神器 DuoDiscover:针对 TPU 自定义算子全硬件评估耗时高达 7~32 分钟的痛点,
/teamwork采用 4 智能体并行发现架构,自动化构建了仅需 23 秒的代理评估器(Yardsticks)。在 17 个 JAXBench 算子与 7 个 vLLM Pallas 推理算子上,实现了相较人工手写汇编极致优化版仍有 2.99x ~ 4.09x 的几何平均加速; - /boost 命令行工具背后的 Harness 自优化:团队通过分析历史数万条任务轨迹,发现强耦合工程代码在“串行演进与审查”下的 Token 效率与成功率远高于无序并行,这一发现直接反哺并固化为 Antigravity 开发者每天高频使用的
/boost命令。
四、 核心维度对比:传统单智能体 vs 树状多智能体 vs Antigravity /teamwork
为了让系统架构师直观理解 /teamwork 的工业级代差,下表详细对比了当前主流 AI 智能体工程范式在长程科学与系统任务中的表现:
| 评估维度 | 单体大上下文 Agent (Single-Agent) | 无序并发子智能体 (Swarm / ReAct) | Google Antigravity /teamwork |
|---|---|---|---|
| 上下文隔离策略 | 单窗口累加 (易发生注意力耗散与记忆错乱) | 共享全局内存或黑板广播 (冗余噪音大) | 构造级物理分治 (最小化 Token 暴露与接力转交) |
| 错误证伪机制 (Verification) | 自身 Prompt 自我反思 (极易盲目自信) | 简单的互评审查 (缺乏客观基准) | 独立证伪器 (Lean 4 编译器、硬件计数器、物理仿真) |
| 系统级重构能力 | 局限于百行代码修改,长任务必断流 | 并行修改常发生接口冲突与循环报错 | 拓扑依赖驱动 (支撑 80 万行操作系统微内核级移植) |
| 底层模型支撑 | 通用商业闭源 API | 通用开源小模型 | Gemini 4 Argon / Carbon / Hydrogen 专有长程推理底座 |
| 对外开放与科研资助 | 无专项资助,按 Token 昂贵计费 | 社区散兵游勇,缺乏算力支撑 | 开放 Antigravity 工具链,为 1 万名学者提供 6 个月最高配免费算力 |
📝 站长洞察 (Editor’s Insight)
Google 开放 Antigravity /teamwork 不仅仅是一次产品功能的常规更新,而是整个人工智能方法论从“概率性文本生成”向“确定性形式化工程”演进的分水岭。在过去的两年里,业界被大语言模型的生成速度和上下文长度遮蔽了双眼,误以为只要不断堆砌 Token,AI 就能自主解决物理、数学和复杂操作系统的深水区难题;然而严酷的事实证明,缺乏物理隔离和机器证伪器的智能体,在数十步推理之后必定被自身产生的幻觉噪声反噬。/teamwork 真正厉害的地方,在于它彻底将人类顶尖科学家的协作组织结构程序化——负责开拓思路的生成者与持有 Lean 4 严格编译器的证伪者物理隔离,负责架构设计的协调者与深挖局部细节的执行者上下文解耦。这一架构不仅将操作系统内核重构的规模拉升至百万行级别,更向我们揭示了未来十年智能软件工程的唯一确定路径:不相信概率巧合,只相信由编译器、物理仿真与微内核严格校验的确定性逻辑。
Google开放的Antigravity /teamwork是什么?
这是Google Research开放的多智能体协作能力,核心是让不同智能体分工完成生成、审查和证伪,并通过上下文物理隔离减少长程任务中的幻觉、漂移和自证自洽问题。
/teamwork为什么适合长程推理和形式化证明?
因为它不依赖单模型承载全部上下文,而是按步骤拆分任务,每个智能体只看最小必要信息,再由独立审查者验证结果,更适合多日任务、复杂代码和Lean 4形式化证明。
文中提到的90倍吞吐提升来自哪里?
摘录中说明,这一提升来自分布式微内核工程与TPU算子优化,结合FarArray等系统改造,在大规模代码迁移和内核重构场景中实现了显著吞吐增长。
团队落地多智能体先改哪层架构?
先把任务拆成“生成、质检、证伪、汇总”四层,并为每个代理隔离上下文与权限。优先接入可观测性和失败回滚,而不是先追求更多 agent 数量。
长程推理和形式化验证如何配合?
让模型负责提出候选证明与搜索路径,再用 Lean/证明器做硬约束校验。工程上要把“可证伪步骤”显式化,避免模型在长链路里自洽但不可验证。


